HuggingFace生态实战:从模型应用到高效微调
摘要
本文以中文文本分类为主线,梳理 Hugging Face 从 Hub 资产管理、Pipeline 推理到 BERT 微调的完整链路,并补充 LoRA 与 QLoRA 在大模型领域适配中的工程选择。
HuggingFace生态实战:从模型应用到高效微调
写在前面
Hugging Face 的价值不只是提供模型下载地址。它把模型权重、Tokenizer(分词器)、数据集、训练封装、评测信息和演示应用组织为一套可复用的工程接口。真正需要掌握的不是某一条 from_pretrained 命令,而是如何根据任务和资源,在快速调用、监督微调和参数高效微调之间做选择。
本文以中文文本分类为贯穿案例,完整说明一条工程链路:先用 Pipeline 验证模型能力,再拆开 Tokenizer、模型与后处理理解推理过程;随后用 Bidirectional Encoder Representations from Transformers(双向编码器表征,BERT)构建垃圾邮件分类器,最后讨论大模型场景下为何需要 LoRA 与 QLoRA。核心结论很简单:模型调用解决验证问题,数据和评测决定能否进入业务,微调方式由任务稳定性、标注数据和资源预算共同决定。
一、项目概览
项目项 | 内容 |
|---|---|
主线任务 | 中文文本分类,从情感分析验证过渡到垃圾邮件识别 |
输入 | 文本、类别定义、标注样本或任务提示 |
输出 | 固定标签或受约束的生成式分类结果 |
已实现流程 |
|
扩展方案 | LoRA(Low-Rank Adaptation,低秩适配)与 QLoRA(Quantized LoRA,量化低秩适配) |
关键工具 | Hub、Transformers、Datasets、Trainer、PEFT、Accelerate |
结果边界 | 材料保留了情感分析的真实输出和垃圾邮件分类实现代码,但未提供可复核的训练日志或测试集指标 |
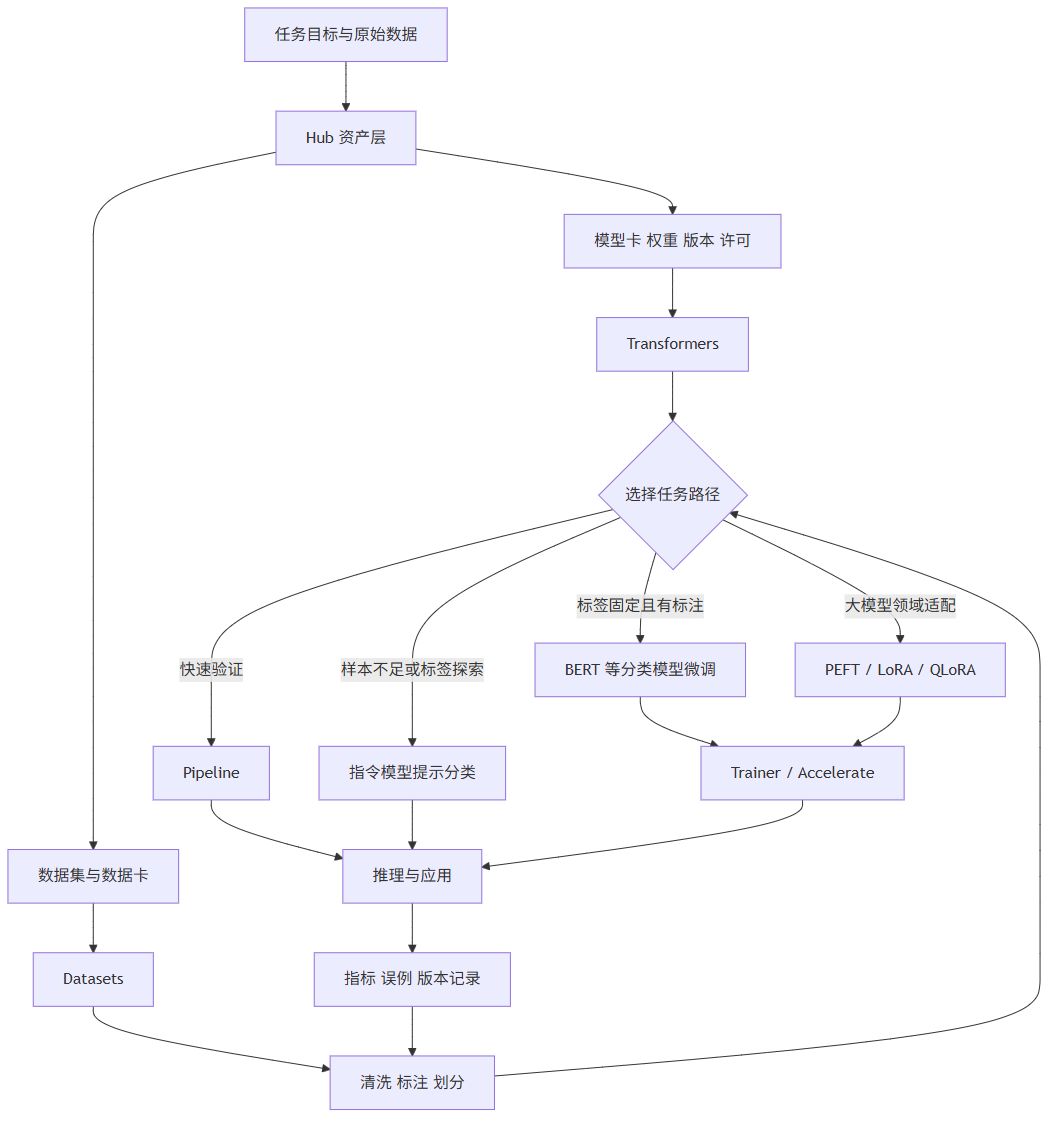
下图给出全文的整体结构。Hub 负责版本化管理模型、数据和应用资产;Transformers 与 Datasets 将这些资产接入代码;不同的任务阶段再选择 Pipeline、分类微调、提示分类或 PEFT。最后的评测和误例不是附属步骤,而是下一轮数据与模型选择的输入。
二、Hugging Face 解决的不是单点调用问题
很多初学者把 Hugging Face 等同于 transformers。实际上,transformers 只是本地调用模型的一层接口;完整生态还包含 Hub、数据集、训练加速、参数高效微调和应用托管。
组件 | 解决的问题 | 在本案例中的位置 | 使用时的注意点 |
|---|---|---|---|
Hub | 模型、数据与应用资产的发现、版本和协作 | 查找 BERT、Qwen、模型卡和数据集 | 查看任务、语言、许可证、限制和 |
Transformers | 统一加载模型、Tokenizer 和推理接口 |
| 模型和 Tokenizer 必须配套;模型类要与任务头匹配 |
Datasets | 加载、转换和划分数据 | 将 CSV、JSON 等文本样本转为训练集 | 先检查标签分布、重复样本和训练测试泄漏 |
Trainer | 封装常规训练、评测和检查点 | BERT 二分类训练循环 | 默认封装不等于无需理解指标、保存策略和数据划分 |
PEFT | 用少量可训练参数适配大模型 | LoRA、QLoRA 扩展方案 |
|
Accelerate | 统一设备、多卡和低精度训练接口 | 大模型训练或推理扩展 | 先估算显存,再决定量化、并行和批次策略 |
Hub 上的仓库以 Git 方式组织模型、数据集和 Spaces 应用,并保留版本、提交记录与文件差异。对工程使用者来说,模型卡和数据卡与权重同样重要:它们记录任务、训练数据、适用范围、限制和评测信息。Hugging Face 官方文档也将模型、数据集和 Spaces 视为 Hub 的三类核心资产。Hub 文档
这带来一个直接的工程约束:模型标识不是完整的可复现实验配置。至少还要固定模型版本、Tokenizer、任务头、数据版本、最大长度、评测脚本和随机种子。否则同一名称的模型在不同时间下载,或使用不同的后处理逻辑,都可能得到不可比较的结果。
三、从 Pipeline 开始:先验证能力,再拆开黑盒
1. Pipeline 适合做什么
Pipeline 是 Transformers 提供的高层推理接口。它根据任务名称组合预处理、模型前向计算和后处理,适合在 Demo、模型选型和功能验证阶段快速确认能力是否匹配需求。官方文档明确指出,Pipeline 可以通过任务标识加载默认预训练模型与预处理器,也可以显式替换为指定模型。Pipeline 文档
材料使用中文点评情感模型,对负向与正向输入分别得到约 0.9923 和 0.9826 的类别分数。这里的分数只说明该预训练模型对这两条点评的置信度,不等于它在任意中文文本上的准确率,更不能迁移为垃圾邮件分类效果。
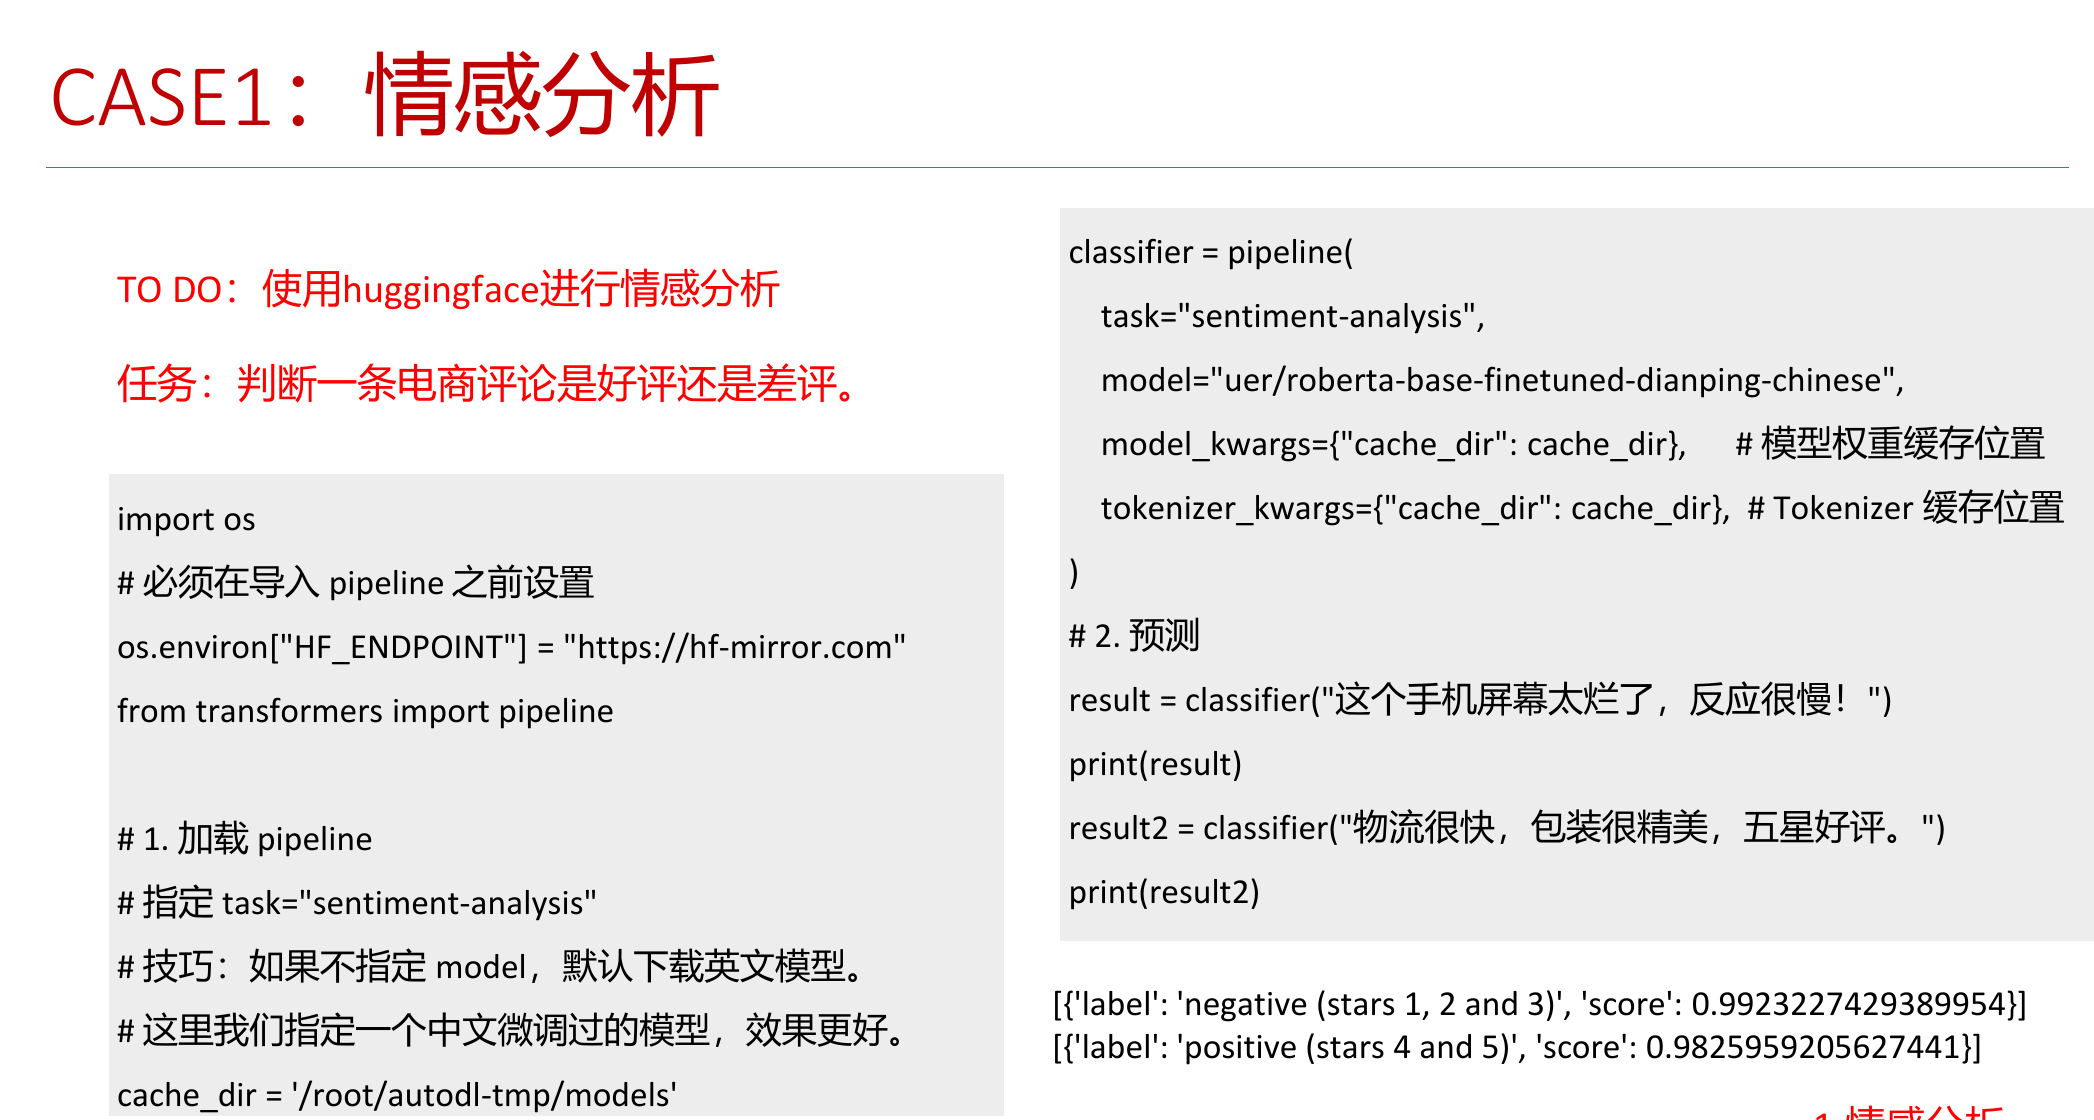
最小调用形式如下。指定中文领域模型很重要;如果只写任务名,库可能加载与目标语言、领域不匹配的默认模型。
在网络受限环境中,镜像地址、本地缓存目录和预下载策略属于部署问题,不会改变模型算法。工程上应将这类配置放入环境变量或部署配置,而不是散落在业务代码中;同时保留官方源或受控镜像的版本记录,避免来源不明的权重文件进入生产环境。
2. 为什么还要拆开 Pipeline
Pipeline 让调用变短,但会隐藏三项决定结果的事实:输入如何切分、模型输出代表什么、类别如何生成。进入微调和排错阶段后,这三项都必须显式控制。
Tokenizer 把文本编码为模型输入张量,包括 input_ids 和 attention_mask。前者是词元编号,后者用于标识真实 Token 与填充位置。不同模型的词表、特殊 Token、最大长度和对话模板并不相同,因此不能将 BERT 的 Tokenizer 与 Qwen 模型混用。AutoTokenizer 会读取模型配置并解析对应的 Tokenizer 类,是避免手工选择错误的一种稳妥方式。Tokenizer 文档
对分类模型,前向计算产生的通常是 logits,即尚未归一化的类别分数。经过 Softmax(归一化指数函数)得到概率分布,再通过 argmax 选择分数最高的类别。AutoModelForSequenceClassification 在基础模型之上提供了分类头,适合固定标签任务;AutoModel 只输出隐藏状态,后续分类层需要自行实现。
这段代码和 Pipeline 完成的是同一条推理链,只是把中间结果暴露出来。理解这一层之后,才能合理设置截断长度、批处理、阈值,以及错误样本分析所需的概率记录。
四、代表性案例:BERT 垃圾邮件分类器
1. 场景、数据与结果边界
案例的目标是将短信或邮件文本划分为正常邮件和垃圾邮件。基础模型是 bert-base-chinese,任务头为二分类头,训练接口使用 Trainer。配套代码构造了 6 条演示样本,并按 test_size=0.2 做随机划分。
这个规模只能说明从数据读取到推理输出的代码链是连通的,不能用于评估模型泛化能力:测试集实际仅约 1 至 2 条样本,随机划分还可能使某一类别在训练或测试集中缺失。因此,本文不报告准确率,也不把演示分类结果写成实验结论。
实际项目至少应准备独立的训练、验证和测试集。垃圾邮件通常类别不均衡,除 Accuracy(准确率)外,应同时报告 Precision(精确率)、Recall(召回率)和 F1-score(F1 分数),并特别检查漏判垃圾信息的代价是否可接受。若数据随时间变化,测试集还应保留时间顺序,避免同一模板的近重复文本同时出现在训练与测试中。
2. 数据处理:动态补齐比固定长度更合理
文本长度天然不一致。若所有样本在预处理时都补齐到 max_length=512,短文本也会被大量无意义的填充 Token 占用显存和计算。案例在 Tokenize 阶段仅进行截断,把补齐交给 DataCollatorWithPadding,使每个 batch 只补齐到该批最长样本。
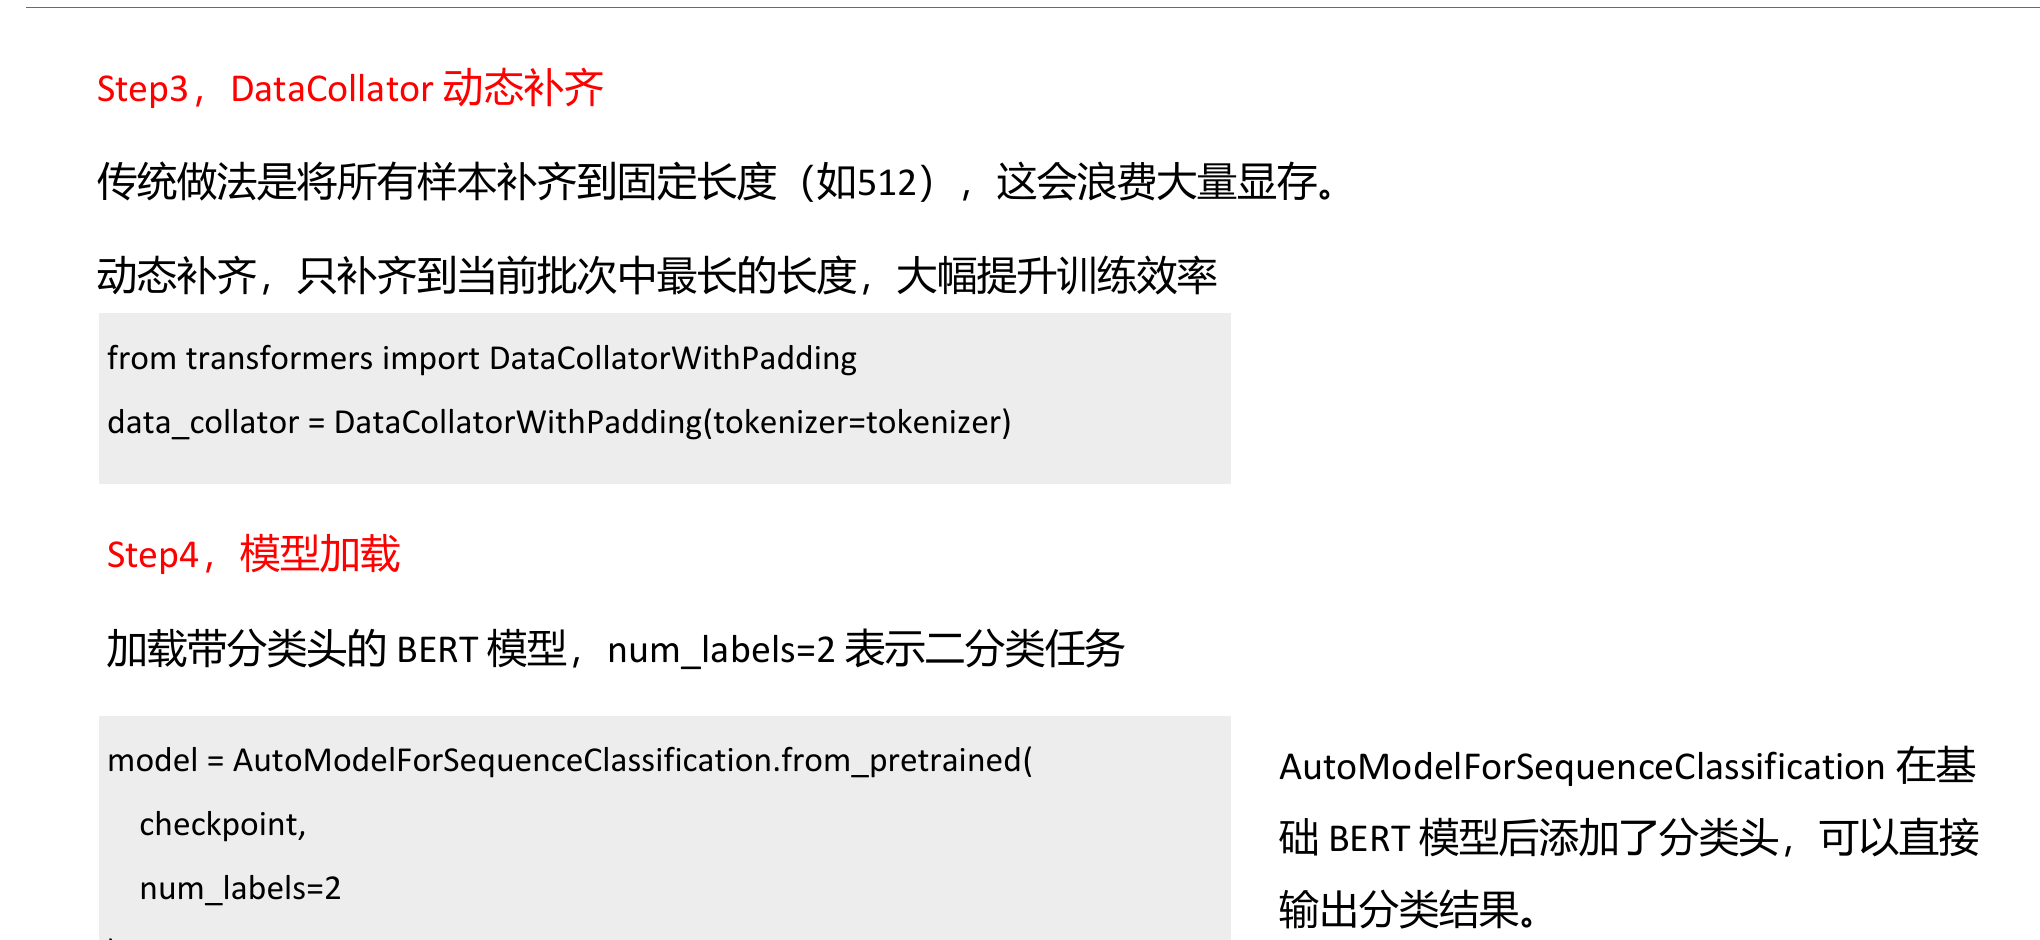
这一步的作用不仅是节省资源。更短的有效序列允许在同一显存条件下使用更大的 batch 或更长的真实输入。代价是每个 batch 的形状不同,吞吐统计要以真实 Token 数而非样本数判断。对于长度差异极大的语料,还可以按长度分桶,减少同一 batch 内的填充比例。
核心数据流如下:
load_dataset() 可以直接加载 CSV、JSON、Parquet 等数据文件,并将它们构建为带类型列的数据表。Datasets 文档 但加载并不等于数据可用。在调用 map 前,应确认文本为空、乱码、重复、标签冲突和敏感字段等问题已经处理,否则训练过程会放大数据缺陷。
3. 训练:Trainer 解决循环,不能替代实验设计
Trainer 将前向计算、反向传播、优化器更新、检查点和评测循环封装起来,能减少训练样板代码。它接收模型、训练参数、数据集、批处理函数和指标函数;当数据集列不被模型 forward() 接收时,默认会移除这些列。Trainer 文档
下列配置保留案例的关键逻辑。compute_metrics 的输入是 logits 和真实标签,先取最大类别编号再计算指标;训练参数中的每轮评测和保存使训练状态可追踪。
这里采用的是全量微调,即基础 BERT 与分类头的可训练参数都会更新。对于 BERT 级别的判别模型,它仍然是清晰、有效的基线:标签固定、数据量足够且需要低延迟分类时,分类头直接输出 logits,推理路径短、部署形式也简单。
训练完成后的推理不需要再调用 generate(),只需得到 logits 并取最大类别。这个差异决定了 BERT 更适合封闭标签空间,而不是所有文本任务都应使用生成模型。
五、同一任务的另一条路径:Qwen 提示分类
案例还给出了 Qwen 指令模型的零样本分类实现。它将待分类文本和标签定义写入 Prompt(提示词),再用 generate() 生成自然语言标签。其流程是文本、提示构造、Tokenize、文本生成、结果解析、类别输出。
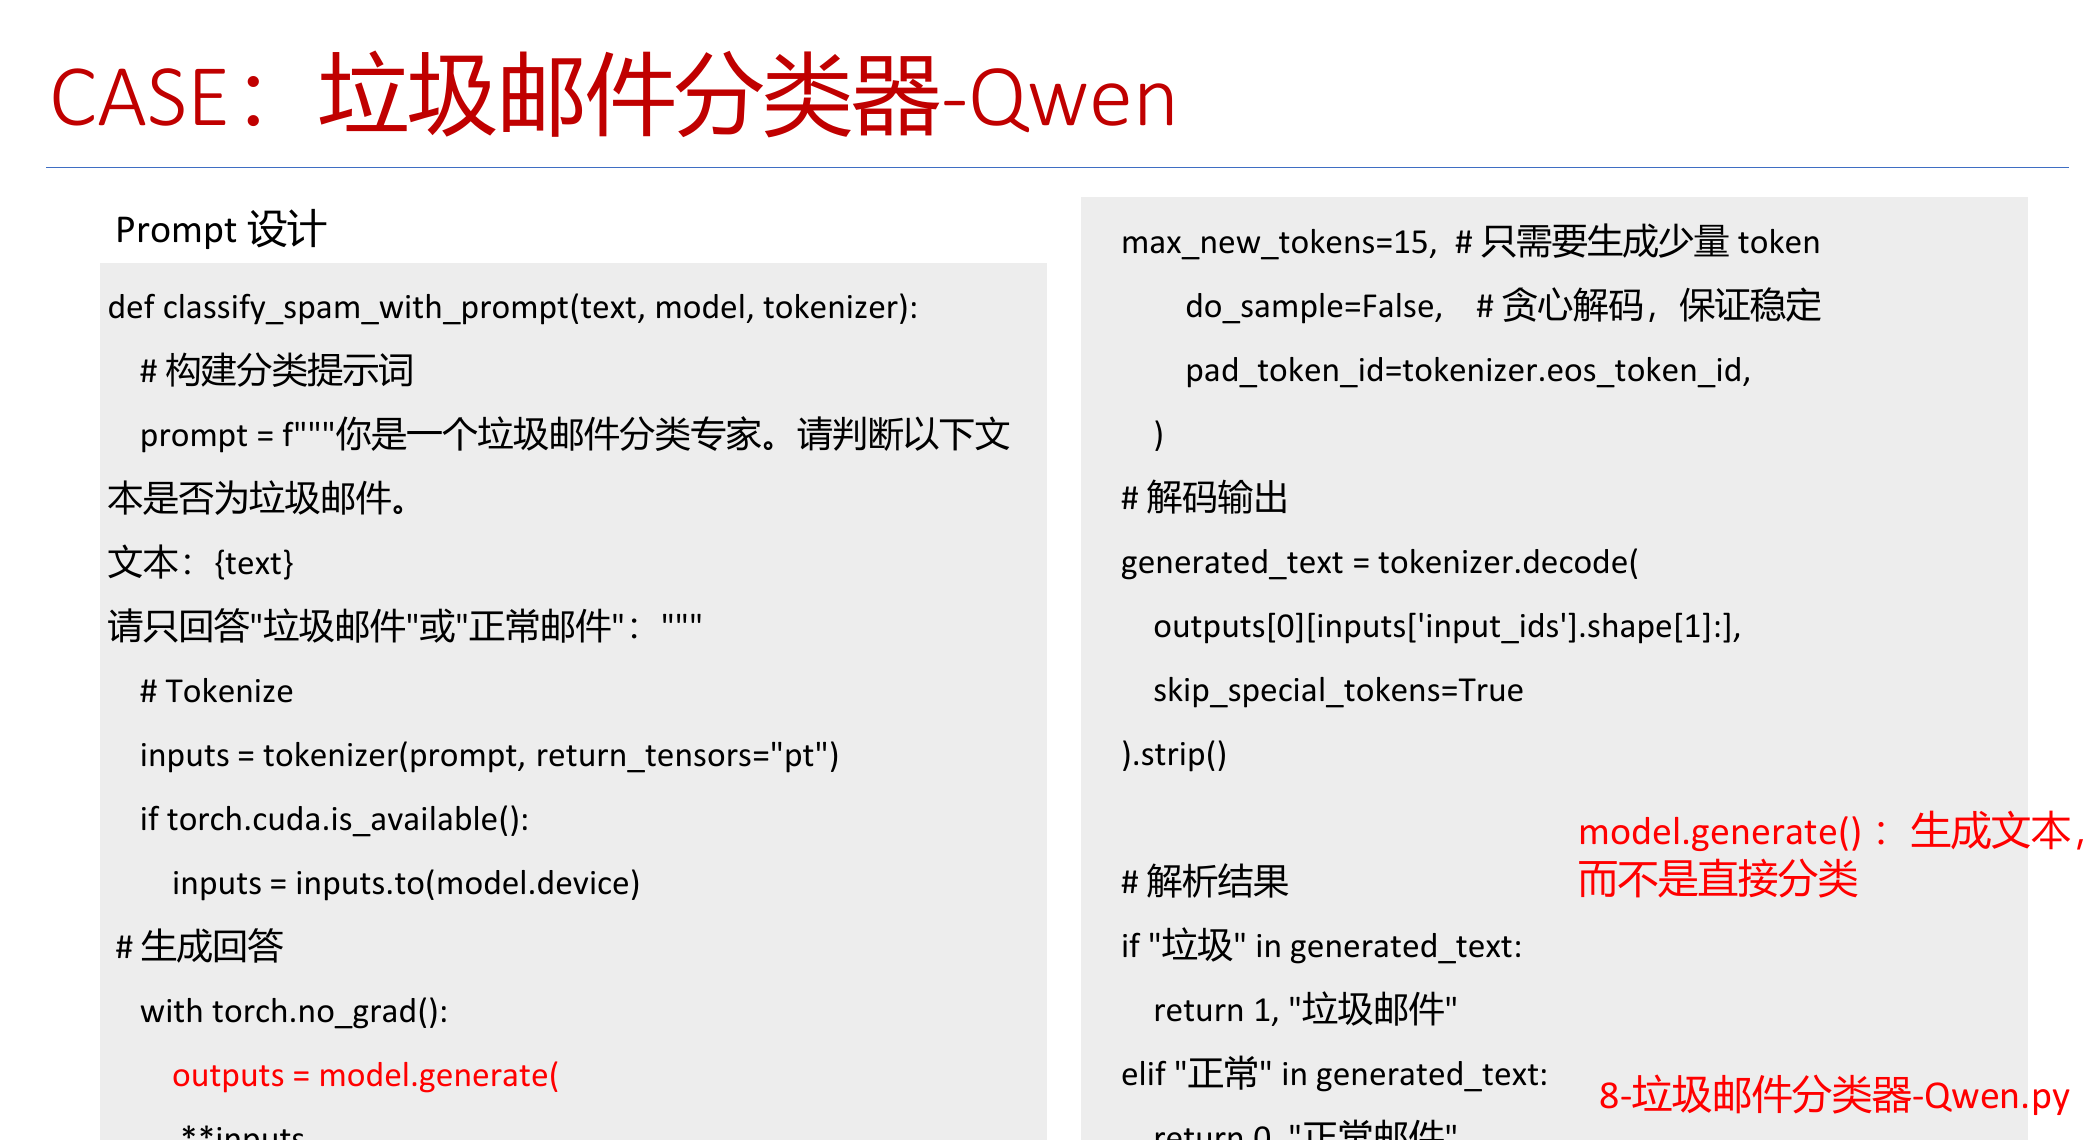
这条路径没有训练步骤,适合标签尚在变化、样本不足或需要快速验证任务定义的阶段。它还可以利用指令模型的通用语义能力处理较复杂的描述,而不必先准备一套稳定的大规模标注集。
但生成式分类增加了一个 BERT 分类器没有的风险:模型输出的是文本,不是固定维度的类别向量。即使设置 do_sample=False,输出仍可能包含解释、同义词或格式变化。材料中的实现通过关键字解析生成结果,这适合演示流程;真实系统更应使用明确的输出模式、允许标签集合和失败状态,不能把未识别文本静默映射成业务类别。
一个更完整的判定逻辑应包含三步:先将标签和边界条件写入提示,再约束输出为有限集合,最后对不符合模式的输出记录原文并进入人工复核或重试队列。不要用宽松的字符串包含判断掩盖解析失败,否则错误会被误记为正常预测。
BERT 微调与提示分类如何选择
条件 | 更合适的方案 | 原因 | 需要承担的代价 |
|---|---|---|---|
标签固定、已有较可靠标注、吞吐和延迟敏感 | BERT 等 Encoder 分类模型微调 | 输出是固定类别 logits,推理链短,便于阈值控制 | 需要持续维护标注集和重训练流程 |
标签仍在探索、样本很少、任务描述复杂 | 指令模型提示分类 | 无需先训练,可快速验证标签定义 | 推理成本高,输出格式和一致性需额外控制 |
希望适配较大生成模型,且有领域数据 | LoRA 或 QLoRA | 保留生成能力,同时降低可训练参数和显存压力 | 需要选择适配层、训练模板和更严格评测 |
任务可由规则充分覆盖 | 规则或规则加模型 | 可解释且成本低 | 对边界模糊、表达多样的文本泛化差 |
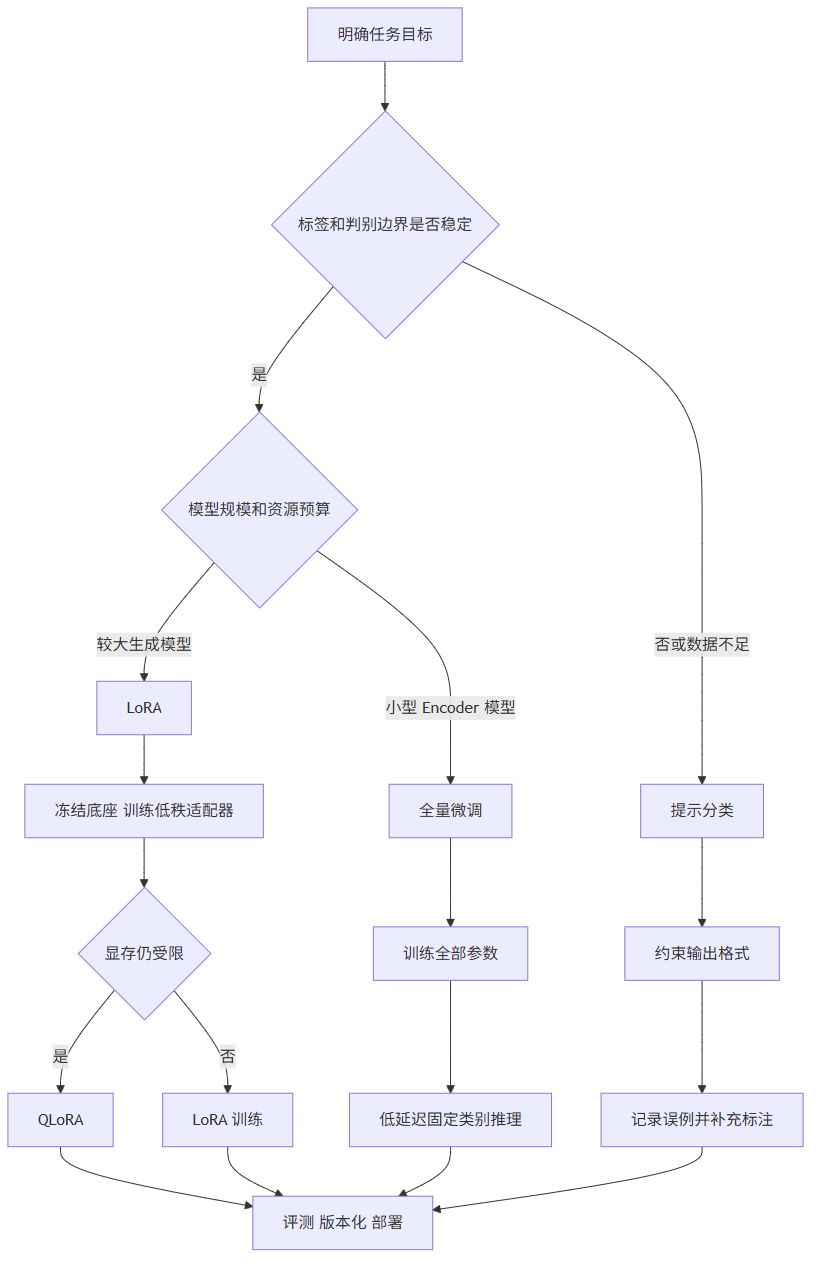
选择的起点不是模型大小,而是任务边界。若业务定义本身未稳定,先用提示分类收集误例和标注规范;当标签与验收标准稳定后,再使用判别模型或参数高效微调追求成本、速度和一致性。
六、从全量微调到高效微调
1. 全量微调的资源问题
全量微调会更新所有基础模型参数。训练时不仅要存放权重,还要保存梯度、优化器状态和中间激活。模型越大,显存压力越大;即使只改动领域知识,也需要保存一份完整的新模型版本。对于小型 Encoder 分类器,这一代价通常可接受;对于多十亿参数的指令模型,则往往不经济。
Parameter-Efficient Fine-Tuning(参数高效微调,PEFT)的思路是冻结大部分预训练权重,只训练少量新增或选定参数。它改变的是训练和发布方式,而不是绕开数据、评测和任务定义。
2. LoRA:只学习权重增量
LoRA 将某个权重矩阵的更新表示为低秩矩阵乘积。若原权重为 W,训练后的权重为 W' = W + BA。其中 W 保持冻结,A 与 B 的秩远小于原矩阵维度,训练只更新这两个小矩阵。这样可以显著减少可训练参数,并让同一个底座模型挂载多个轻量任务适配器。Hugging Face 的 PEFT 文档也指出,LoRA 可在推理前合并适配器与底座权重,消除额外适配器加载带来的延迟。LoRA 文档
LoRA 的关键参数不是固定模板。r 决定低秩更新的容量,lora_alpha 控制缩放,target_modules 决定在哪些线性层插入适配器。常见的 q_proj、v_proj 只适用于具有相应命名的注意力结构;加载自定义架构前应先检查模块名称,再决定目标层。对分类任务,还要考虑分类头是否需要加入 modules_to_save,否则新初始化的任务头可能不会被训练和保存。
下面是对生成模型进行 LoRA 配置的最小骨架,用于说明依赖关系,不是对本案例已执行训练的描述。
3. QLoRA:把量化与适配器结合
Quantization(量化)通过更低比特表示权重,以降低显存占用并加快部分推理路径。QLoRA 的常见做法是以 4-bit 量化加载底座模型,在其上训练 LoRA 适配器。代码中的 nf4 表示 NormalFloat 4,一种面向近似正态分布权重的 4-bit 数据类型。官方 PEFT 文档建议通过 BitsAndBytesConfig 配置 4-bit 或 8-bit 加载,并在训练前调用 prepare_model_for_kbit_training() 处理量化模型的训练准备。量化与 PEFT 文档
QLoRA 降低的是资源门槛,不会自动保证领域效果。量化配置、序列长度、batch 大小、训练样本质量和 Prompt 模板仍会改变结果。对需要高精度的固定分类任务,应把 QLoRA 与小型判别模型作为候选方案一起在同一测试集上评估,而不是仅按显存占用选择。
4. 何时需要 Accelerate
当单卡或单进程不再满足训练与推理需求时,Accelerate 用统一接口适配多 Graphics Processing Unit(图形处理器,GPU)、混合精度和多种分布式后端。它的作用是减少不同设备与并行方案的代码差异,而不是替代显存估算和训练监控。官方 Quicktour 将其定位为统一启动入口、训练代码适配和大模型推理支持。Accelerate 文档
实际顺序应是先缩小问题:确认数据、序列长度与单卡基线;再增加动态补齐、混合精度或 LoRA;最后才引入多卡、DeepSpeed 或 Fully Sharded Data Parallel(全分片数据并行,FSDP)等复杂方案。若单卡配置已经能稳定满足吞吐和成本要求,过早分布式只会增加排错面。
七、可复用的实施流程
上面的案例可以收敛为一套更稳定的实践顺序。
1. 先确认任务和验收边界
写清输入文本、标签定义、允许的未知类别、错误代价和验收指标。垃圾邮件任务中,误将正常邮件判为垃圾与漏判垃圾的代价不同,阈值和指标也应不同。没有清晰标签边界时,先做提示分类和误例收集,而不是立即训练。
2. 用 Pipeline 做能力验证
选择任务和语言相符的现成模型,保留几条代表性输入、输出和版本信息。此阶段回答的是模型是否具备基本能力,不回答最终业务准确率。
3. 建立可审计的数据与评测集
划分训练、验证、测试集,去除近重复样本并检查标签分布。将高风险误例、边界样例和线上失败样例固定到测试集。每次更新模型、Tokenizer、最大长度或标签定义后,使用同一评测集比较。
4. 选择最小可行的训练方案
固定类别且模型规模适中时,从全量微调的分类基线开始;需要快速冷启动时使用提示分类;需要适配较大生成模型时再进入 LoRA 或 QLoRA。模型越复杂,验证和版本管理越应提前,而不是延后。
5. 保存完整推理契约
发布的不应只有权重。还应保存 Tokenizer、标签映射、最大长度、Prompt 模板、阈值、依赖版本、数据版本和评测报告。Hub 的模型卡与数据卡提供了组织这些信息的标准位置,但项目内部仍需保留可重复执行的配置。
八、问题与限制
本案例覆盖了 BERT 全量微调和 Qwen 提示分类的关键代码路径,但原始演示数据只有 6 条,未提供训练曲线、测试集输出、混淆矩阵和资源消耗记录。因此它适合作为 Hugging Face 接口和流程的学习基线,不足以比较 BERT、提示分类、LoRA 或 QLoRA 的实际优劣。
材料中的 Qwen 示例使用生成文本后再做关键字解析。该方案对零样本演示直观,但在生产分类系统中需要更强的结构化输出约束和异常处理。另一方面,BERT 分类器的标签空间固定,面对新型诈骗话术或标签体系变化时,需要通过持续标注、再训练或上层规则完成更新。
后续若将案例扩展为可评测项目,优先补齐三项工作:构建有时间边界的真实标注集;使用 Precision、Recall、F1 和混淆矩阵评估类别风险;在同一测试集、相同标签规范下比较 BERT 全量微调、提示分类与 LoRA/QLoRA 的成本、延迟和误例。
九、小结
Hugging Face 生态将模型应用拆成了清晰的工程层次:Hub 管理资产和版本,Transformers 负责统一调用,Datasets 组织数据,Trainer 与 Accelerate 支撑训练,PEFT 将大模型适配的资源成本降到可控范围。
从这个案例可以得到三点结论。第一,Pipeline 是能力验证入口,不是最终评测。第二,BERT 全量微调仍然适合标签固定、低延迟的判别任务,动态补齐和正确的数据划分比堆叠复杂框架更重要。第三,LoRA 与 QLoRA 解决的是大模型适配的资源问题,不能替代高质量数据、明确标签和独立测试集。
模型选择最终应回到任务本身:先用最小方案验证问题,再用数据和评测决定是否训练,最后才为规模、显存和吞吐引入更复杂的工程能力。