
Scion:Agent 大规模检出下的源码服务与分层缓存
摘要
解读 Scion 如何用服务端增量记录、派生索引和分层对象缓存支撑 Agent 与 CI 的高频检出,区分作者资源收益、迁移代价及可独立验证的工程思路。
Scion:Agent 大规模检出下的源码服务与分层缓存
全文概览
Agent 与 CI 会反复创建工作区,仓库体积和检出次数随之成为基础设施成本。Anthropic 在 Redesigning source control at Anthropic 中介绍了内部源码系统 Scion:把提交、合并和历史查询交给服务端,以不可变对象分发文件,让客户端只读取任务需要的目录。
核心变化在于客户端与服务端的职责。changeset 记录增量,派生索引回答历史问题,节点与区域缓存复用文件对象。工作区可以稀疏创建,也可以在文件被读取时再物化。原文报告的资源收益来自这些设计的组合,不能单独归功于某一层缓存或模型。
这是一份工程案例。原文发表于 2026 年 10 月 13 日,10 月 15 日补充了对 Sapling、Mononoke 和 Bonsai 数据模型的说明。本次阅读包含全文、两幅结构图与脚注,关注前提是超大单仓库、始终联网的任务和高频检出。Scion 尚无面向通用场景的公开实现,普通项目采用这些思路时仍需独立测量。
先看图 1。上方灰色路径承担提交、分支和历史查询,橙色路径传输目录树与文件对象。CI 任务优先复用同一节点的 daemon,缺失对象再逐级向上请求。
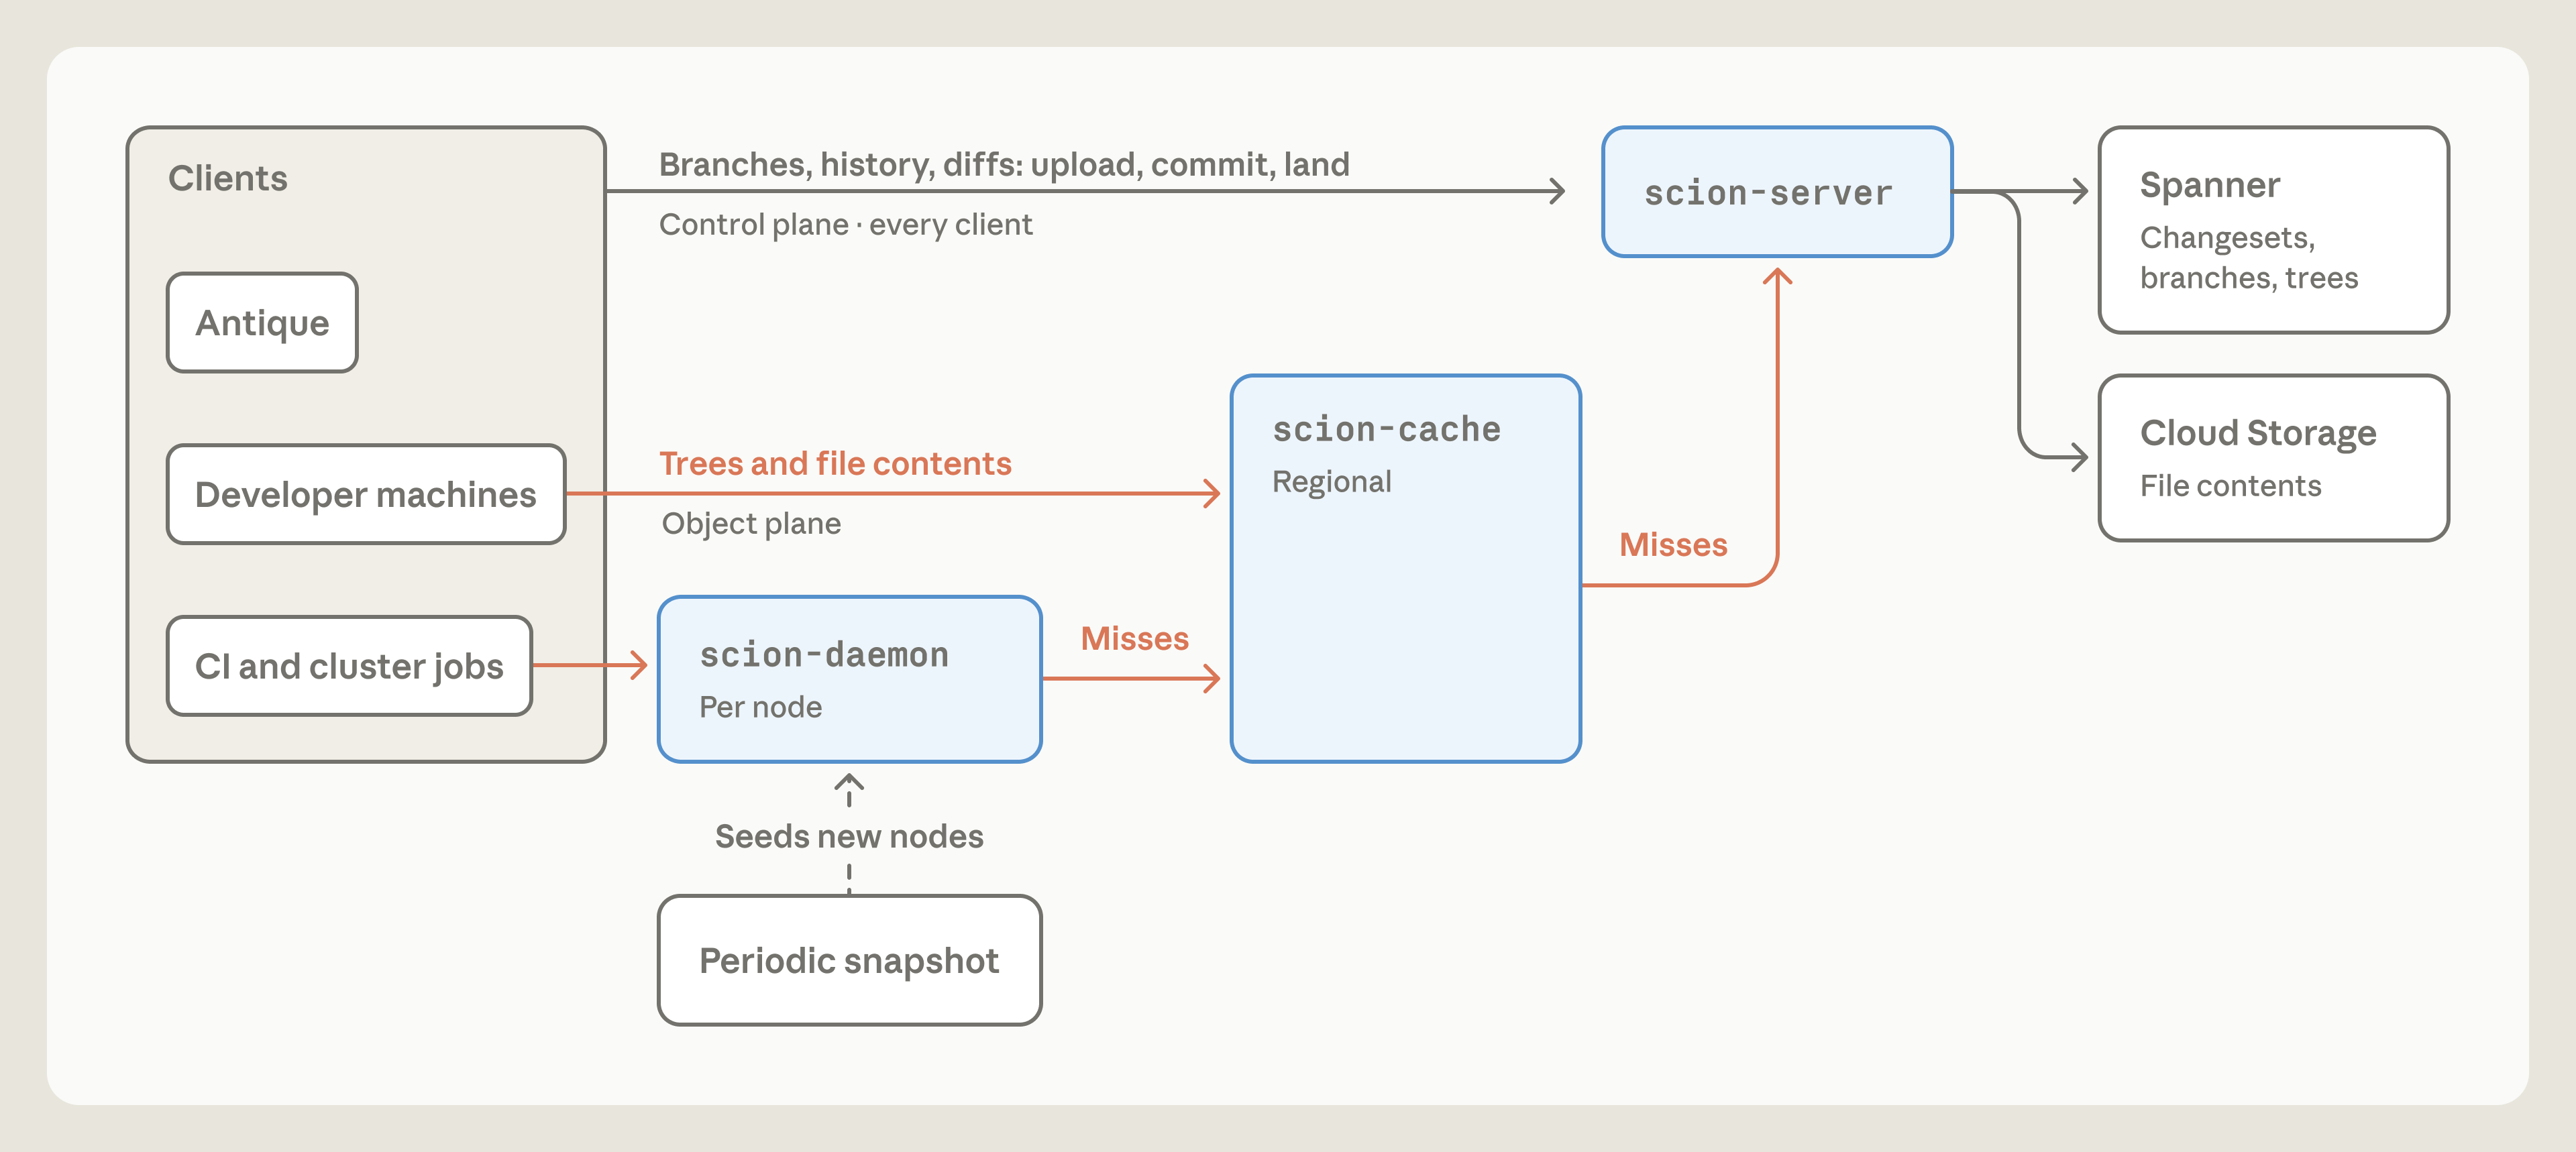
图源:Anthropic 原文,高清结构图。阅读顺序是工作负载、数据模型与缓存协议、作者结果、适用边界,最后给出可验证的工程尝试。
背景与约束
原文称,Anthropic 主分支历史接近 100GB,压缩工作副本超过 25GB,仅 CI 每天就执行约 2500 万次检出。按完整工作副本机械相乘会得到超过 600PB 的日传输量,这是作者用来解释压力的朴素估算,不是实际测得的网络流量。
团队此前使用浅克隆、稀疏检出、promisor remote、内部镜像和对象存储中的仓库种子。合并频率增长后,种子与主分支之间的距离变大,局部仓库中的 diff、blame 等历史操作也更难维护。这些问题发生在作者的负载与部署环境中,不能据此认定 Git 的相应功能普遍失效。
Scion 接受了两个约束:客户端持续在线,主要工作可通过中心服务完成。Agent 沙箱与短生命周期任务通常符合这一条件,离线开发者却不一定符合。设计由此允许客户端只保留有界对象缓存,把复杂的仓库计算集中到服务端。
数据模型、查询与检出协议
changeset 保存本次修改
一个 changeset 是预写日志中的条目,包含作者、父节点、消息,以及相对第一个父节点发生变化的文件。文件内容单独压缩存放,使用内容地址定位。图 2 中,删除文件只需要删除标记,新增或修改文件指向对应 blob。
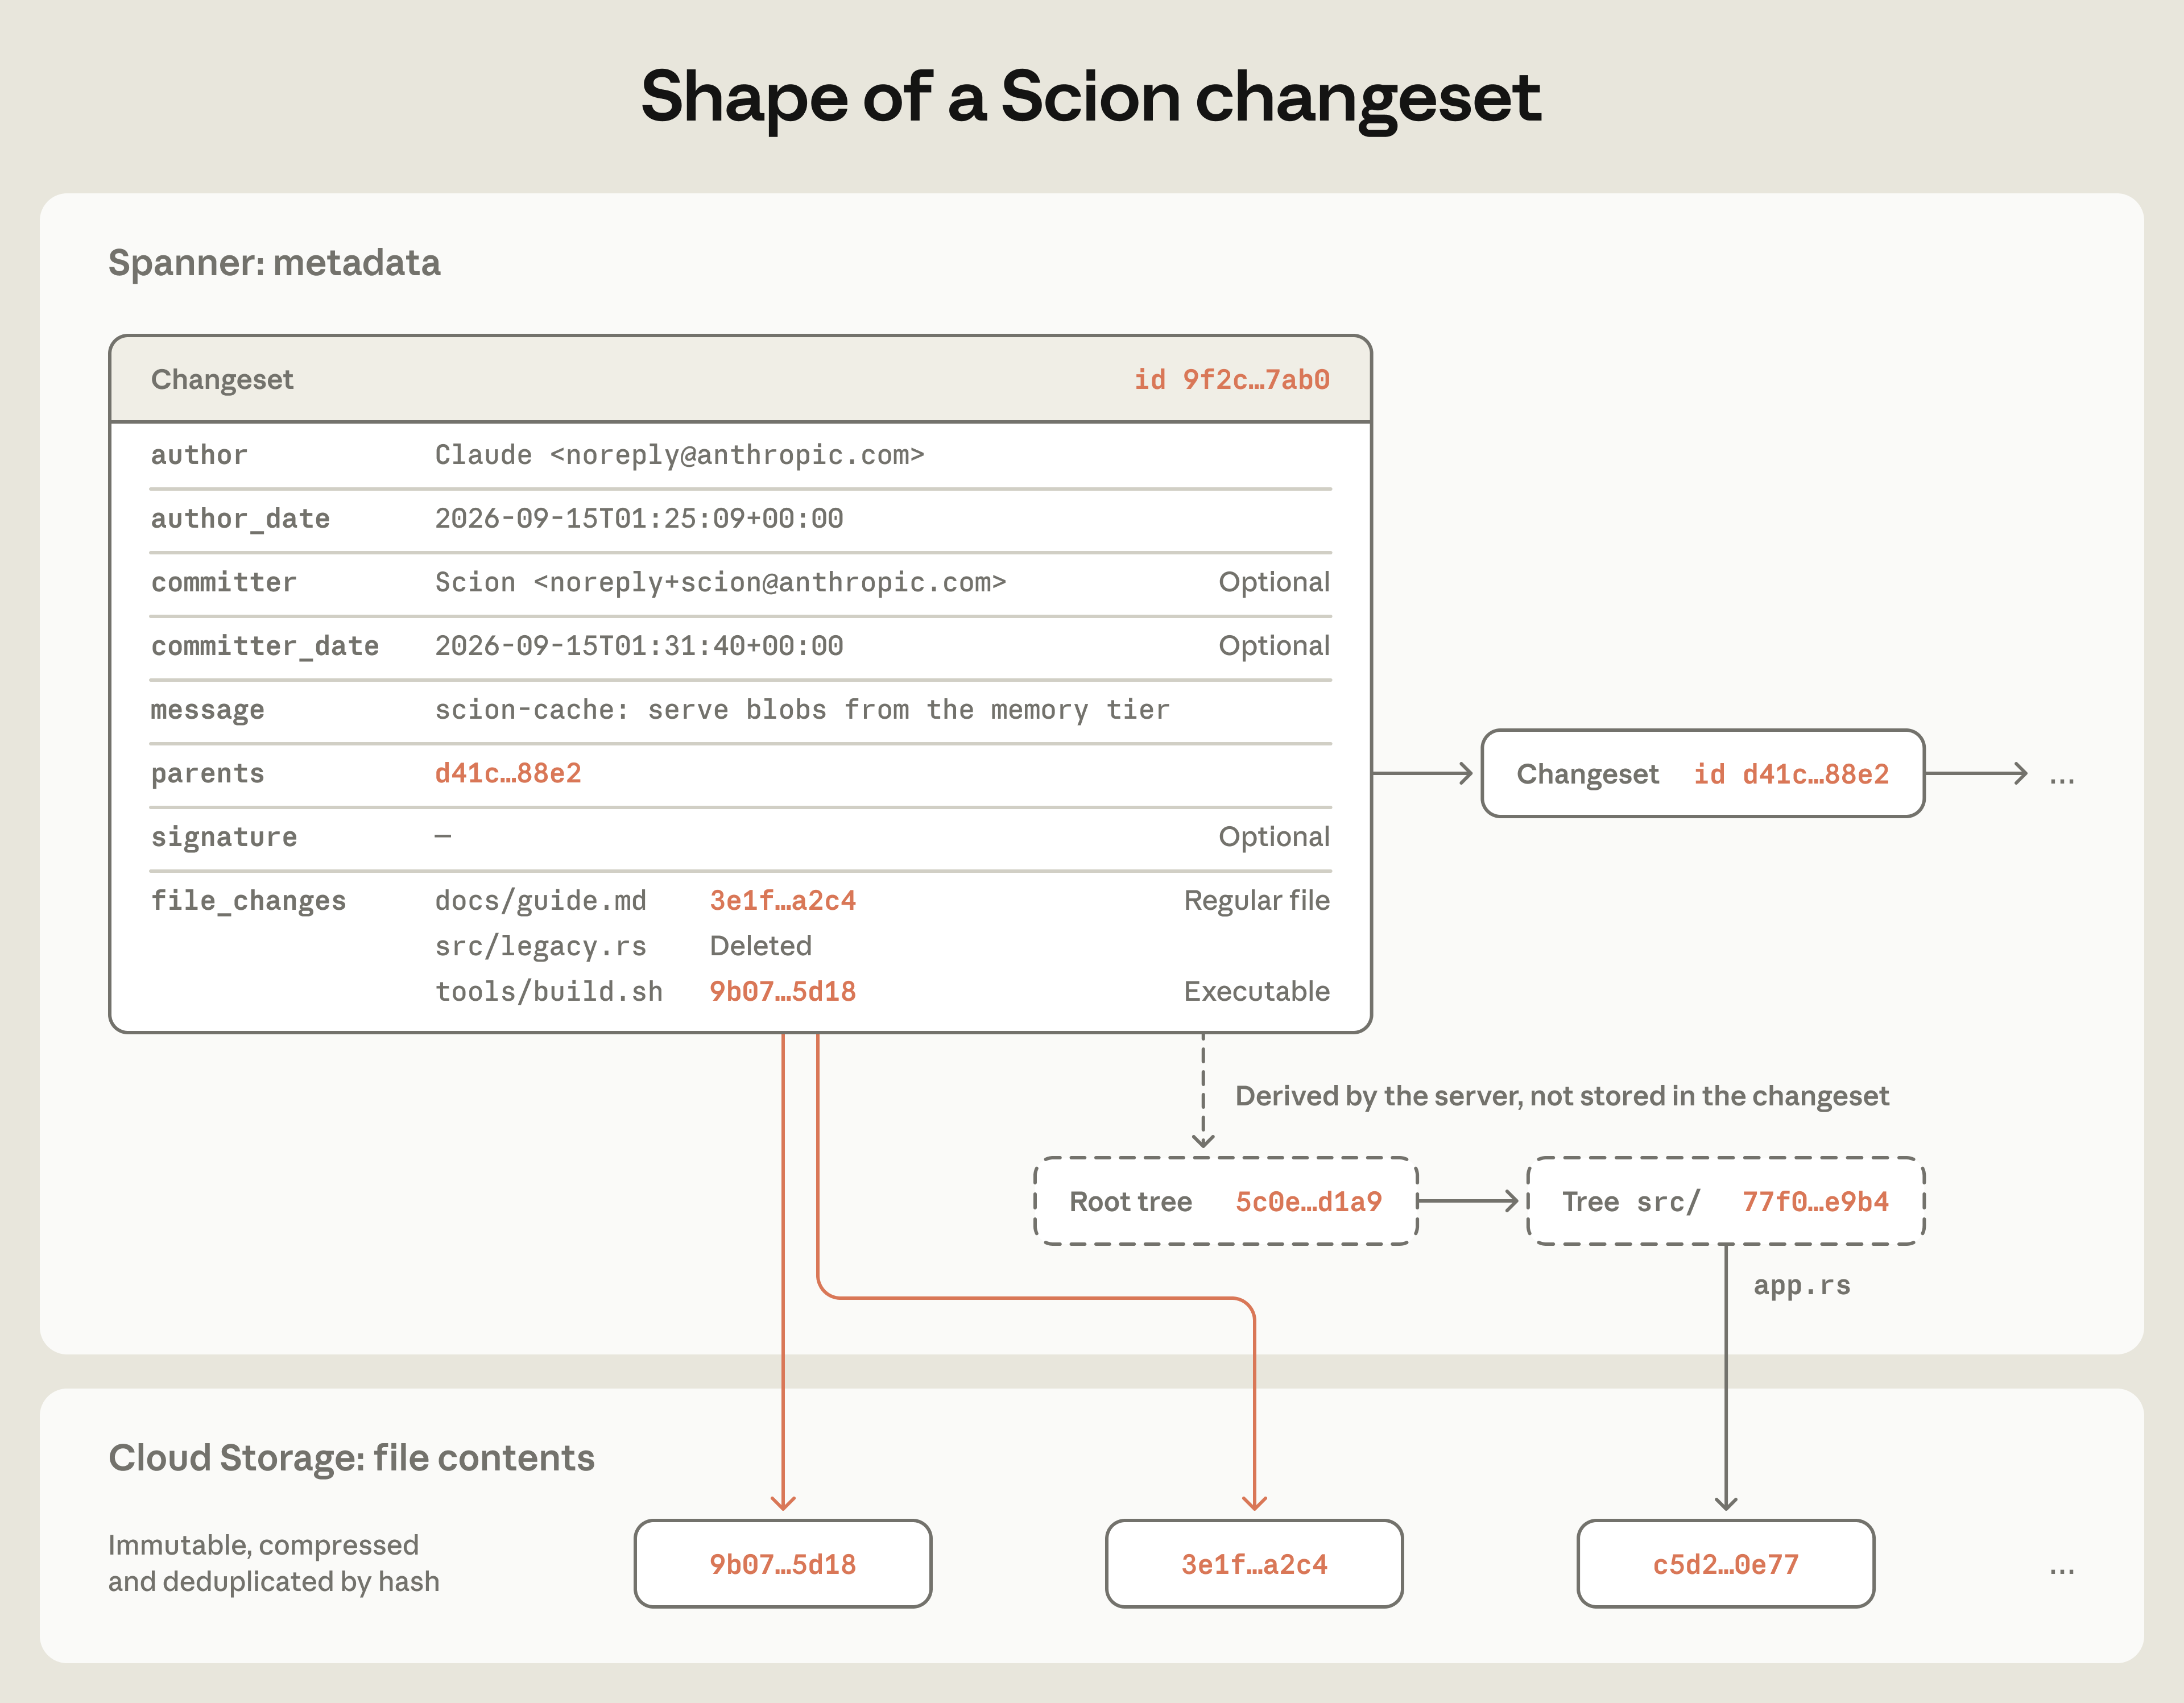
图源:Anthropic 原文的数据结构部分,高清数据模型图。上半部分为元数据,下半部分为文件内容,虚线目录树由服务端派生,并非 changeset 直接存储的字段。
增量记录降低了接受一次修改时需要处理的数据量。原文将高吞吐与无需接收 packfile、减少锁及跨服务协调联系起来。Scion 仍支持 refs,其移动通过 Spanner 中单行的 compare-and-swap 单独完成,创建和读取 changeset 不依赖移动 ref。因此,原文的无锁表述不能扩展成整个系统没有协调或一致性成本。
派生数据回答历史问题
只有修改清单,查询某行的归属或某条路径的历史仍会很慢。Scion 为 blame、路径历史、提交图等建立派生结构,统一按父 changeset 的已有结果递归计算。
这让服务端可以为不同索引选择提前计算或延迟计算,并在增加新查询时补充索引。客户端不依赖索引内部布局,因此服务端可以独立优化。代价是需要正确维护增量计算、持久化与故障恢复,原文未提供足够信息让读者复现其完整一致性设计。
可以用一个示例理解数据流:任务需要某次修改的 diff 时,直接请求服务端计算,无需先下载完整工作区。任务确实要编译代码时,再获取指定目录的树和文件。这是对原文机制的解释示例,本次没有运行 Scion 或测量该调用。
对象请求沿固定缓存层级向上
检出协议从目标根树开始,客户端检查本地缺失的树对象并递归请求,再请求缺少的文件对象。协议围绕想要的具体对象组织,无需让服务端为每个客户端生成一个大型打包响应。对象不可变,缓存可直接复用已保存的内容。
在集群任务路径上,客户端先访问节点级 scion-daemon。daemon 用周期快照初始化,只向本区域 scion-cache 请求缺失对象,区域缓存再向权威 scion-server 请求。后者按需读取 Spanner 或云存储。区域缓存直接流式传输 daemon 可消费的磁盘格式,避免为每个请求重新执行差量压缩。
各层使用相同 RPC,客户端无需理解完整拓扑,但运行系统严格限制跨层访问。原因是区域缓存故障时,不能让大量节点绕过它直接压向权威服务。图 1 中开发机与 CI 的入口有所不同,节点 daemon 的复用收益主要对应集群任务路径。
作者报告的结果与工程代价
Anthropic 报告各缓存层命中率超过 99%,源码基础设施的 CPU 与内存需求相较原镜像方案缩小约 200 倍,CI 与研究任务检出从分钟级进入秒级,并称 CI 释放了约 25% CPU 容量。
这些指标描述的对象不同:200 倍对应基础设施资源占用,25% 对应 CI 容量,检出耗时则属于任务等待时间。它们不能相互换算,也不能由本文推导为任意仓库的预期收益。原文没有公开可供独立运行的实现、完整硬件配置、延迟分布和负载回放脚本。
原文还介绍了仿真、模糊测试、限流和持续监控。上线质量同时依赖这些运维工作,缓存命中率本身不能证明故障时的可用性。值得单独检查的指标包括冷节点启动、区域缓存失效后的回源峰值,以及多租户读写竞争下的尾延迟。
局限与适用边界
Scion 需要中心源码服务持续可达,离线状态下的能力明显受限。访问控制、目录级权限、服务端查询和新审查系统也必须共同工作。原文明确表示,外部采用者需要迁移源码生命周期中的多个组件,内部 Antique、代码搜索与 CI 的定制程度使直接复用困难。
原文脚注承认 Mononoke 与 Bonsai 对相应技术的先行贡献。将多个已有机制组合到新的工作负载中,可以形成工程价值,不能据此声称 changeset 或服务端索引由 Scion 首次提出。
对中小仓库,新增服务、缓存层级、协议和迁移流程可能超过节省的资源。若瓶颈主要来自测试执行或依赖下载,先改源码管理也未必有效。负载定位应先于系统重建。
可验证的工程尝试
以下是根据原文提出的验证建议,本次未实施。
第一,选择一组真实 CI 作业,记录检出字节数、实际读取路径、准备时间和测试时间。若大量下载文件没有被读取,可以先评估现有稀疏检出或按需物化机制。成功判据是任务结果保持一致,同时减少准备阶段的时间和传输量。若耗时主要由测试决定,应停止扩展源码缓存方案。
第二,评估节点级内容寻址缓存。对同一节点上的重复作业测量对象复用率,并分别测试冷启动和热缓存。缓存键必须绑定内容身份及相应访问控制。验证中若出现跨权限复用或内容不一致,应先处理正确性,再讨论命中率收益。
第三,在测试环境模拟区域缓存不可用,观察上游请求数、错误率和尾延迟。目标是判断固定层级与限流能否控制回源峰值,而非只测正常运行的吞吐。原文支持这一故障隔离动机,具体阈值仍需根据自己的服务容量确定。
参考资料
Redesigning source control at Anthropic,Anthropic source control team,2026-10-13 发布,2026-10-15 更新。本文使用的主要事实、结构图与性能数字均来自这份原始工程报告,阅读日期为 2026-10-16。
Scion 检出与缓存结构原图、changeset 数据结构原图,用于解释相应机制。图像版权归原作者,本文保留来源,仅引用这两幅与评论直接相关的结构图。