WeLM-Image: A Unified Image Generation Model towards Visual Intelligence:论文阅读
摘要
解读 WeLM-Image 的统一多模态序列、双路径混合专家、分任务强化学习和部署评测,说明实验条件与可复现边界。
WeLM-Image: A Unified Image Generation Model towards Visual Intelligence:论文阅读
全文概览
图像生成系统越来越需要同时处理文字指令、参考图片和目标图像:例如,把参考图里的人物放进另一张海报,同时保留人物身份、改变衣服并写入指定文字。这个任务既要理解不同输入的作用,也要在生成过程中保持局部细节。单纯扩大模型规模会增加推理开销,多张参考图还会增加上下文长度。
WeChat Vision 团队的 WeLM-Image 技术报告 将文生图、指令编辑和多参考合成表示为统一的多模态序列。理解与生成使用各自的参数路径和专家网络,通过共享注意力交换信息;数据构造、分任务强化学习和蒸馏共同服务于可控生成和部署。
报告称,基础模型在所测生成和编辑基准中表现具有竞争力;其 8 步 Turbo 版本在作者的单张 NVIDIA H20 测试中生成 1024×1024 图片平均用时 4.98 秒。该结果依赖特定采样设置和测试环境,不能直接推广到所有 GPU 或质量要求。以下依次看统一序列、双路径结构、训练方法、实验条件和工程边界。
下面的总览图展示输入如何进入两条路径,以及每层如何进行联合注意力。
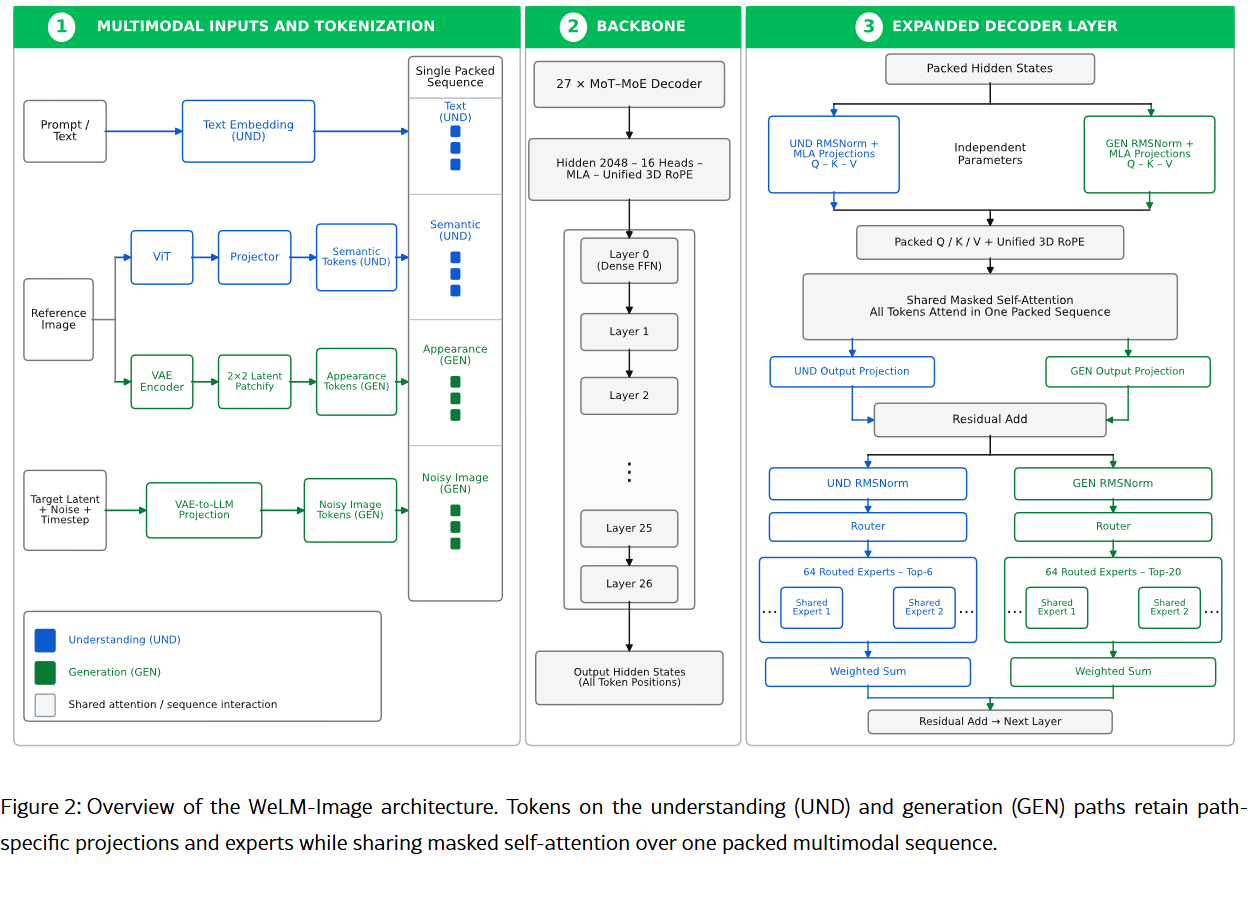
图中蓝色表示理解路径,绿色表示生成路径;文本和参考图被转换为同一序列中的不同 token,经过各自投影后进入共享注意力。图片来自 WeChat Vision 的论文图 2,依据 CC BY 4.0 署名转载;手机阅读可打开架构原图放大查看。
背景与问题
文生图接收文本并输出图像;图像编辑还要读取源图,完成指定变化并保留未要求改变的内容;多参考合成需要分别识别各张参考图提供的身份、风格或物体属性。若所有任务使用完全共享的参数,语言理解与连续图像生成的训练目标可能互相干扰;若为每个任务独立部署模型,又会增加维护和服务成本。
论文将输入划分为文本 token、视觉语义 token、参考图潜变量 token 和待生成图像的含噪潜变量。视觉 Transformer(Vision Transformer,ViT)负责提取语义特征,变分自编码器(Variational Autoencoder,VAE)负责图像与潜空间的转换。统一格式为不同任务提供共同接口,但并不意味着所有 token 的计算路径和训练目标完全相同。
整体方法与关键创新
一条序列,两类参数路径
理解路径处理文本与 ViT 语义 token;生成路径处理参考图和目标图的 VAE 潜变量。每层分别计算两条路径的投影,再在由掩码控制的共享注意力中交互。生成目标因此能够结合文字、参考图语义和参考图外观,同时两类任务保留独立参数。
这套双路径结构称为混合 Transformer(Mixture-of-Transformers,MoT)。作者又在各路径内部配置独立的混合专家(Mixture-of-Experts,MoE),由路由器为每个 token 选择部分专家。论文表 2 给出 27 层解码器、2048 的隐藏维度以及每条路径各 64 个路由专家和 2 个共享专家;理解路径选择 6 个路由专家,生成路径选择 20 个。
报告中的完整多模态模型储存 31.7B 参数,包含 ViT、但不包含独立 VAE;每个理解 token 约激活 2.2B 解码器参数,每个目标潜变量 token 约激活 5.4B 生成参数。储存参数和单 token 激活参数衡量的是不同开销,后者也不能直接等同于整次请求的显存或总计算量。
为什么还需要注意力掩码
把不同输入拼成序列后,必须限制哪些位置可以相互读取。下面的原论文图 4 给出了一个包含提示词、条件图、推理文本和目标潜变量的例子。
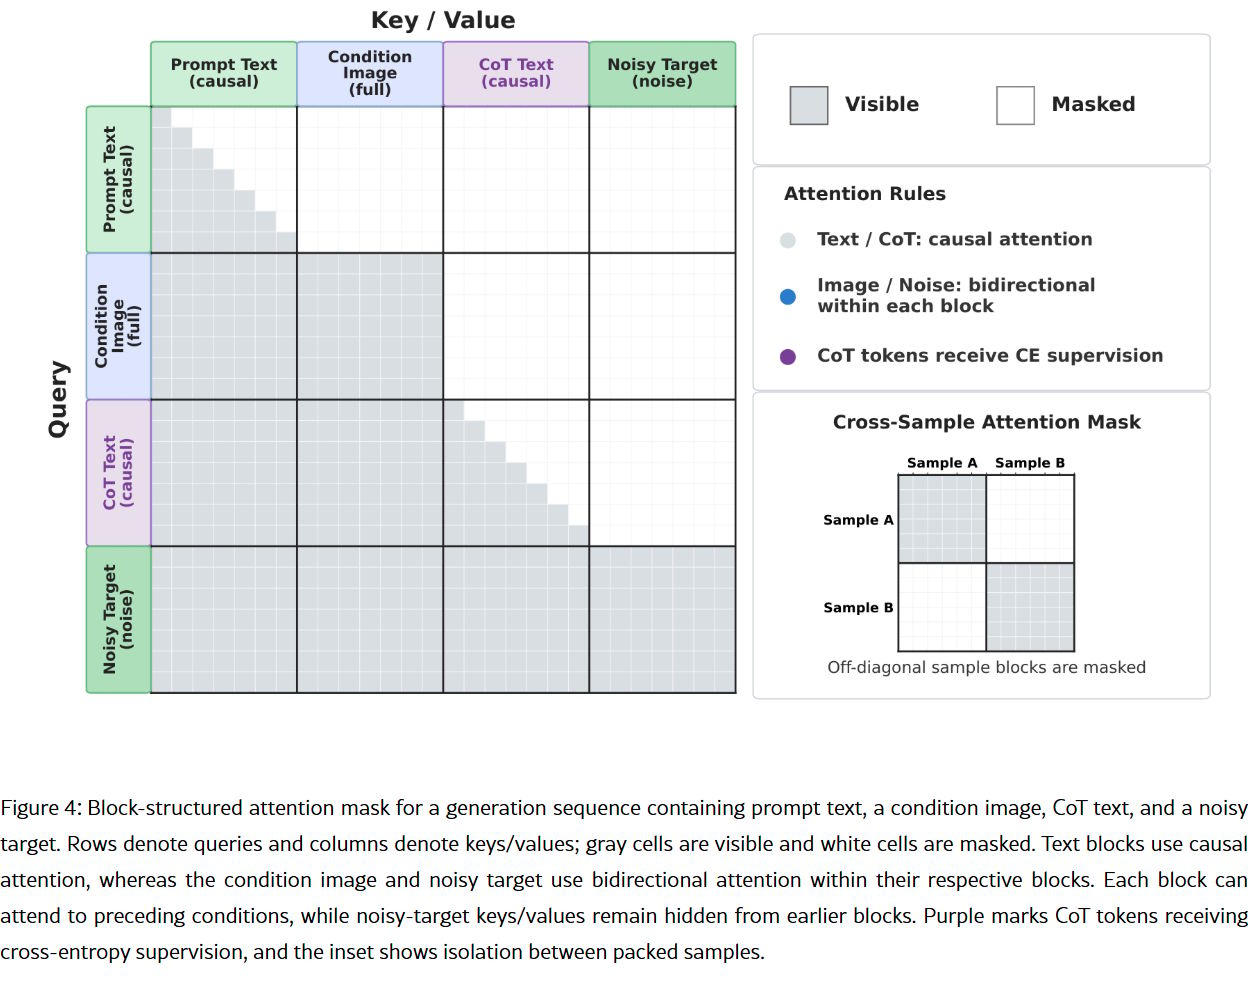
文本段按因果顺序读取;条件图和含噪目标在各自图像块内部使用双向注意力;目标可读取此前条件,但目标的键和值对前面的条件段不可见。右侧小图说明不同打包样本之间需要隔离。该图来自 WeChat Vision 的论文图 4,按 CC BY 4.0 署名转载;手机阅读可打开掩码原图放大查看。
这种掩码既允许目标图像利用完整条件,也避免不同训练样本互相泄漏。推理采样时,条件 token 的计算结果可缓存,后续去噪步主要重复计算含噪目标潜变量,减少多步生成中的重复工作。
位置编码和输出目标
不同模态的位置不能只按普通文本的一维序号处理。论文使用兼容文本的三维旋转位置编码(3D Rotary Position Embedding,3D RoPE):文本保持预训练语言模型原有位置变换,VAE 潜变量在相应序列锚点附近附加图像高度与宽度偏移。这样既能利用已有语言模型的位置表示,也让注意力知道图像潜变量的二维结构。
文本输出采用语言建模监督,图像潜变量使用生成目标。虽然任务共享一个训练循环,损失掩码仍需区分各位置的监督类型;否则统一序列并不能保证训练目标正确。
数据构造与训练
数据设计决定模型能否正确理解复杂指令。作者从约 6 亿张图片的整理池出发,利用知识驱动的视觉词汇覆盖长尾概念,再结合视觉聚类平衡外观分布。双语标注结合光学字符识别(Optical Character Recognition,OCR)信息描述图片中的文字;编辑数据核验源图与目标图之间的实际变化,多参考样本则明确每张图承担的角色。训练过程中的评测结果继续反馈给筛选和采样策略。
训练从预训练的 Kimi-VL 检查点初始化理解路径,并将相应权重复制到生成路径;生成侧的 VAE 桥接与时间步嵌入单独初始化。训练分辨率从 512 逐步提高到 1024 和 1536,早期保留部分理解数据,后期更集中于生成、编辑和多参考任务。高分辨率阶段使用上下文并行,报告中的打包上下文长度最高为 64K token。
监督微调(Supervised Fine-Tuning,SFT)之后,作者分别对文生图和图像编辑开展强化学习。文生图分支使用图文一致性、审美、文字渲染和自然度等奖励;编辑分支进一步检查指令要求、未修改区域保持和视觉质量。两分支主要更新生成侧的低秩适配器,理解路径和路由器保持冻结。
之后的在线策略蒸馏(On-Policy Distillation,OPD)将两条专长策略整合到一个学生模型;噪声水平不同的阶段采用不同教师信号,兼顾全局构图和局部细节。最后,基于 MeanFlow 的少步蒸馏得到 Turbo 版本。这里的速度收益来自采样步数、是否使用无分类器引导等多项设置的共同变化,不能只归因于某一个模块。
实验与证据
论文同时报告生成质量、图像编辑和推理效率。生成评测包括 GenEval、PRISM-Bench 和 Qwen-Image-Bench;编辑评测包括 GEdit、ImgEdit、UnicBench,以及作者构建的 WeGenEditBench。后者包含单图、文字编辑和多参考样本,适合分析指令执行、内容保持与参考绑定,但作为作者自建评测仍需要外部复核。
在论文表 14 的单图编辑对比中,WeLM-Image 在 GEdit、ImgEdit、UnicBench 和 WeGenEditBench 分别得到 8.381、4.581、8.992 和 4.005;Turbo 8 步版本分别为 8.314、4.537、8.664 和 3.947。各指标量纲不同,不能横向相加;论文将闭源模型列入表中,但其排名高亮排除了闭源模型。这些都是作者报告的结果,并非独立复现。
推理测试采用 H20、一次预热和三次计时取平均,不包含模型加载。文生图输出均为 1024×1024 时,50 步基础版本为 56.99 秒,8 步 Turbo 为 4.98 秒;Turbo 使用一至四张输入图进行编辑时分别为 6.78、8.78、10.92 和 13.17 秒。作为对照,论文给出的 Qwen-Image-2512-Lightning 4 步文生图为 3.21 秒。不同模型的质量、步数和采样方式不同,这些数字展示各自配置的端到端表现,不能单独证明架构效率优劣。
局限与适用边界
首先,论文是团队技术报告,质量和性能数据由作者报告;训练数据包含自建和专有部分,读者未必能完整复现数据配比及评测管线。报告并不等于已经公开全部权重、训练数据或可直接部署的实现,实际获取条件仍需以官方发布为准。
其次,单卡延迟以 H20 和论文的软件栈测得,并排除了模型加载;生产环境还需计入显存、并发、排队、模型切换、输入分辨率和安全审核。多参考输入增多也会增加上下文和注意力计算成本。
最后,统一模型仍可能在长指令、精细文字修改、人物身份保持或多个参考图的属性绑定上失败。论文自建编辑基准正是针对这些问题设计,但测试集覆盖有限,不能保证任意真实业务场景都可靠。
可验证的启发
如果要研究统一多模态模型,可先在同一任务集上比较共享参数、双路径参数和双路径加专家路由,固定训练数据与计算预算,分别测量生成质量、文本理解退化和推理成本。只有在相同预算下同时观察任务指标和资源占用,才能判断路径隔离是否值得。
如果关注工程部署,可构建一组一至四张参考图的编辑任务,记录指令执行、未编辑区域保持和每请求延迟,并固定输出尺寸与采样设置。若参考图增加后时延或属性混淆明显上升,再分别检查缓存命中、序列长度与注意力掩码;这属于基于论文设计的后续验证建议,而非论文已经证明的生产结论。
参考资料
WeChat Vision, Tencent Inc. WeLM-Image: A Unified Image Generation Model towards Visual Intelligence, arXiv:2611.07392v1,2026-11-05,技术报告;全文。
论文图 2、图 4 的转载许可:Creative Commons Attribution 4.0。