
Deep Review:长文核验中的分段预算与全局证据
摘要
解读 Deep Review 如何通过分段覆盖、自适应预算、全文交叉引用和全局核验组织长文审查,区分 PAT 作者问卷反馈与缺陷检出质量,并保留输入及文档保存条件。
Deep Review:长文核验中的分段预算与全局证据
全文概览
一份技术文档的错误可能跨越多个章节:摘要里的性能主张,需要同时对照实验设置、结果表和附录。Google 的 Deep Review 工程说明介绍了一套四阶段流程,将文档拆成审查单元,按内容分配计算预算,让各段审查保持全文上下文,最后统一检查跨段矛盾并补做外部核验。
这里有两项互相配合的设计。分段让每个审查任务聚焦,全文上下文让审查者能够追踪定义、引用与证据。汇总阶段再处理重复意见、严重程度与全局一致性。单纯增加并行审查者数量,无法自动保证这些关系成立。
原文由 Rajesh Jayaram 与 Vincent Cohen-Addad 撰写,页面标注 2026 年 10 月 14 日,RSS发布时间换算为北京时间是 10 月 15 日。本稿依据这份公开工程说明和原始图表解读机制,没有运行 Deep Review,也未据关联 PAT 论文的全文展开实验结论。
图 1 给出整体路径。输入文档经过语义分段与预算分配,分段审查结果汇入全局报告。图中的轻、中、重推理是不同段落的示意分工,具体预算参数并未在这份说明中公布。

图源:Google Research 原文,高清流程图。后文依次讨论长文核验的约束、四阶段机制、试点证据、使用边界与可验证的工程尝试。
背景与约束
长文审查需要处理事实、逻辑、数学陈述和跨章节依赖。原文指出,一次提示词调用可能耗尽推理预算,忽略长上下文中的依赖,或接受需要更仔细检验的主张。Deep Review 将这些负担拆到不同阶段,同时保留文档整体信息。
可以用一个假设例子理解问题:摘要声称模型能跨设备泛化,方法部分只说明随机划分数据,实验表又全部来自同一设备。审查者需要把这三处文字关联起来,再判断证据是否支持主张。这个例子用于解释核验任务,并非本次实际检测到的论文缺陷。
Deep Review 由 Paper Assistant Tool(PAT)演化而来。原文称,PAT 在 STOC 2026、ICML 2026、NeurIPS 2026 与 ICLR 2027 的合作试点中,为自愿参加的作者提供投稿前反馈。该反馈与正式会议审稿流程分离,不能当作接收决定或正式评审意见。
四阶段机制与信息流
分段同时保留覆盖关系
第一阶段由分段 Agent 将输入组织为引言、方法、实验等逻辑单元。分段允许重叠,并要求覆盖全部输入内容。重叠有助于保留边界附近的解释,但也会产生重复发现,后续必须统一处理。
从工程角度看,需要保留段落与原文的位置映射,才能判断一条意见引用了什么、是否遗漏附录,以及两个审查者是否指出了同一个问题。这是根据原文覆盖要求提出的实现分析。原文没有公开映射字段或具体分段算法,本稿不补造其内部接口。
计算预算随内容密度变化
第二阶段依据段落的信息密度和复杂性分配计算预算。数学证明等内容可获得更多推理计算,相关工作或引言通常承担不同的审查任务。原图中的三档分工帮助解释这一思路,实际调度规则没有披露。
这项设计要解决的是资源分配。若所有段落获得相同预算,容易把大量计算花在容易检查的段落,同时让难点缺少充分验证。预算估计也可能出错,因此后续仍需允许发现证据不足时追加核验。原文明确提到汇总阶段可重跑逻辑检查,但没有给出触发阈值或每份文档的成本分布。
分段职责与全文上下文并存
第三阶段让专门的推理 Agent 并行审查各自目标段落,同时访问全文。局部职责帮助集中推理,全文访问支持跨引用追踪。例如,检查实验结论时可以同时查阅数据划分、指标定义和附录设置。
这种安排也带来上下文复用与成本问题。原文试点表提到共享上下文缓存等流程改进,但没有提供可直接复现的配置或消融数据,不能据此量化缓存单独贡献的收益。多个 Agent 也可能共享相同误解,独立任务分配本身无法保证独立判断。
全局汇总继续做核验
第四阶段由汇总 Agent 合并分段报告,检查跨段一致性,必要时重跑逻辑检查,并通过外部依据和工具调用进行事实核验。原图还列出意见去重与严重程度检查,说明最终报告需要进一步整理证据与判断。
例如,两段都指出同一张表缺少单位时,汇总应把它归为一个问题,并保留相关位置。摘要与附录对训练数据数量的描述冲突,则需要结合双方证据判断。这些是对原文机制的解释示例,本次没有运行该系统验证实际输出。
外部核验能够提供新的证据,结果仍需检查来源是否直接支持具体主张。搜索命中、引用存在与论证成立分别是不同的判断,汇总文本应保留这种区别。
试点证据能说明什么
Google 报告 PAT 合作试点覆盖了超过 16,000 份自愿参加的稿件。图 2 同时列出规模、系统演进和作者问卷反馈,三类信息的含义需要分开阅读。
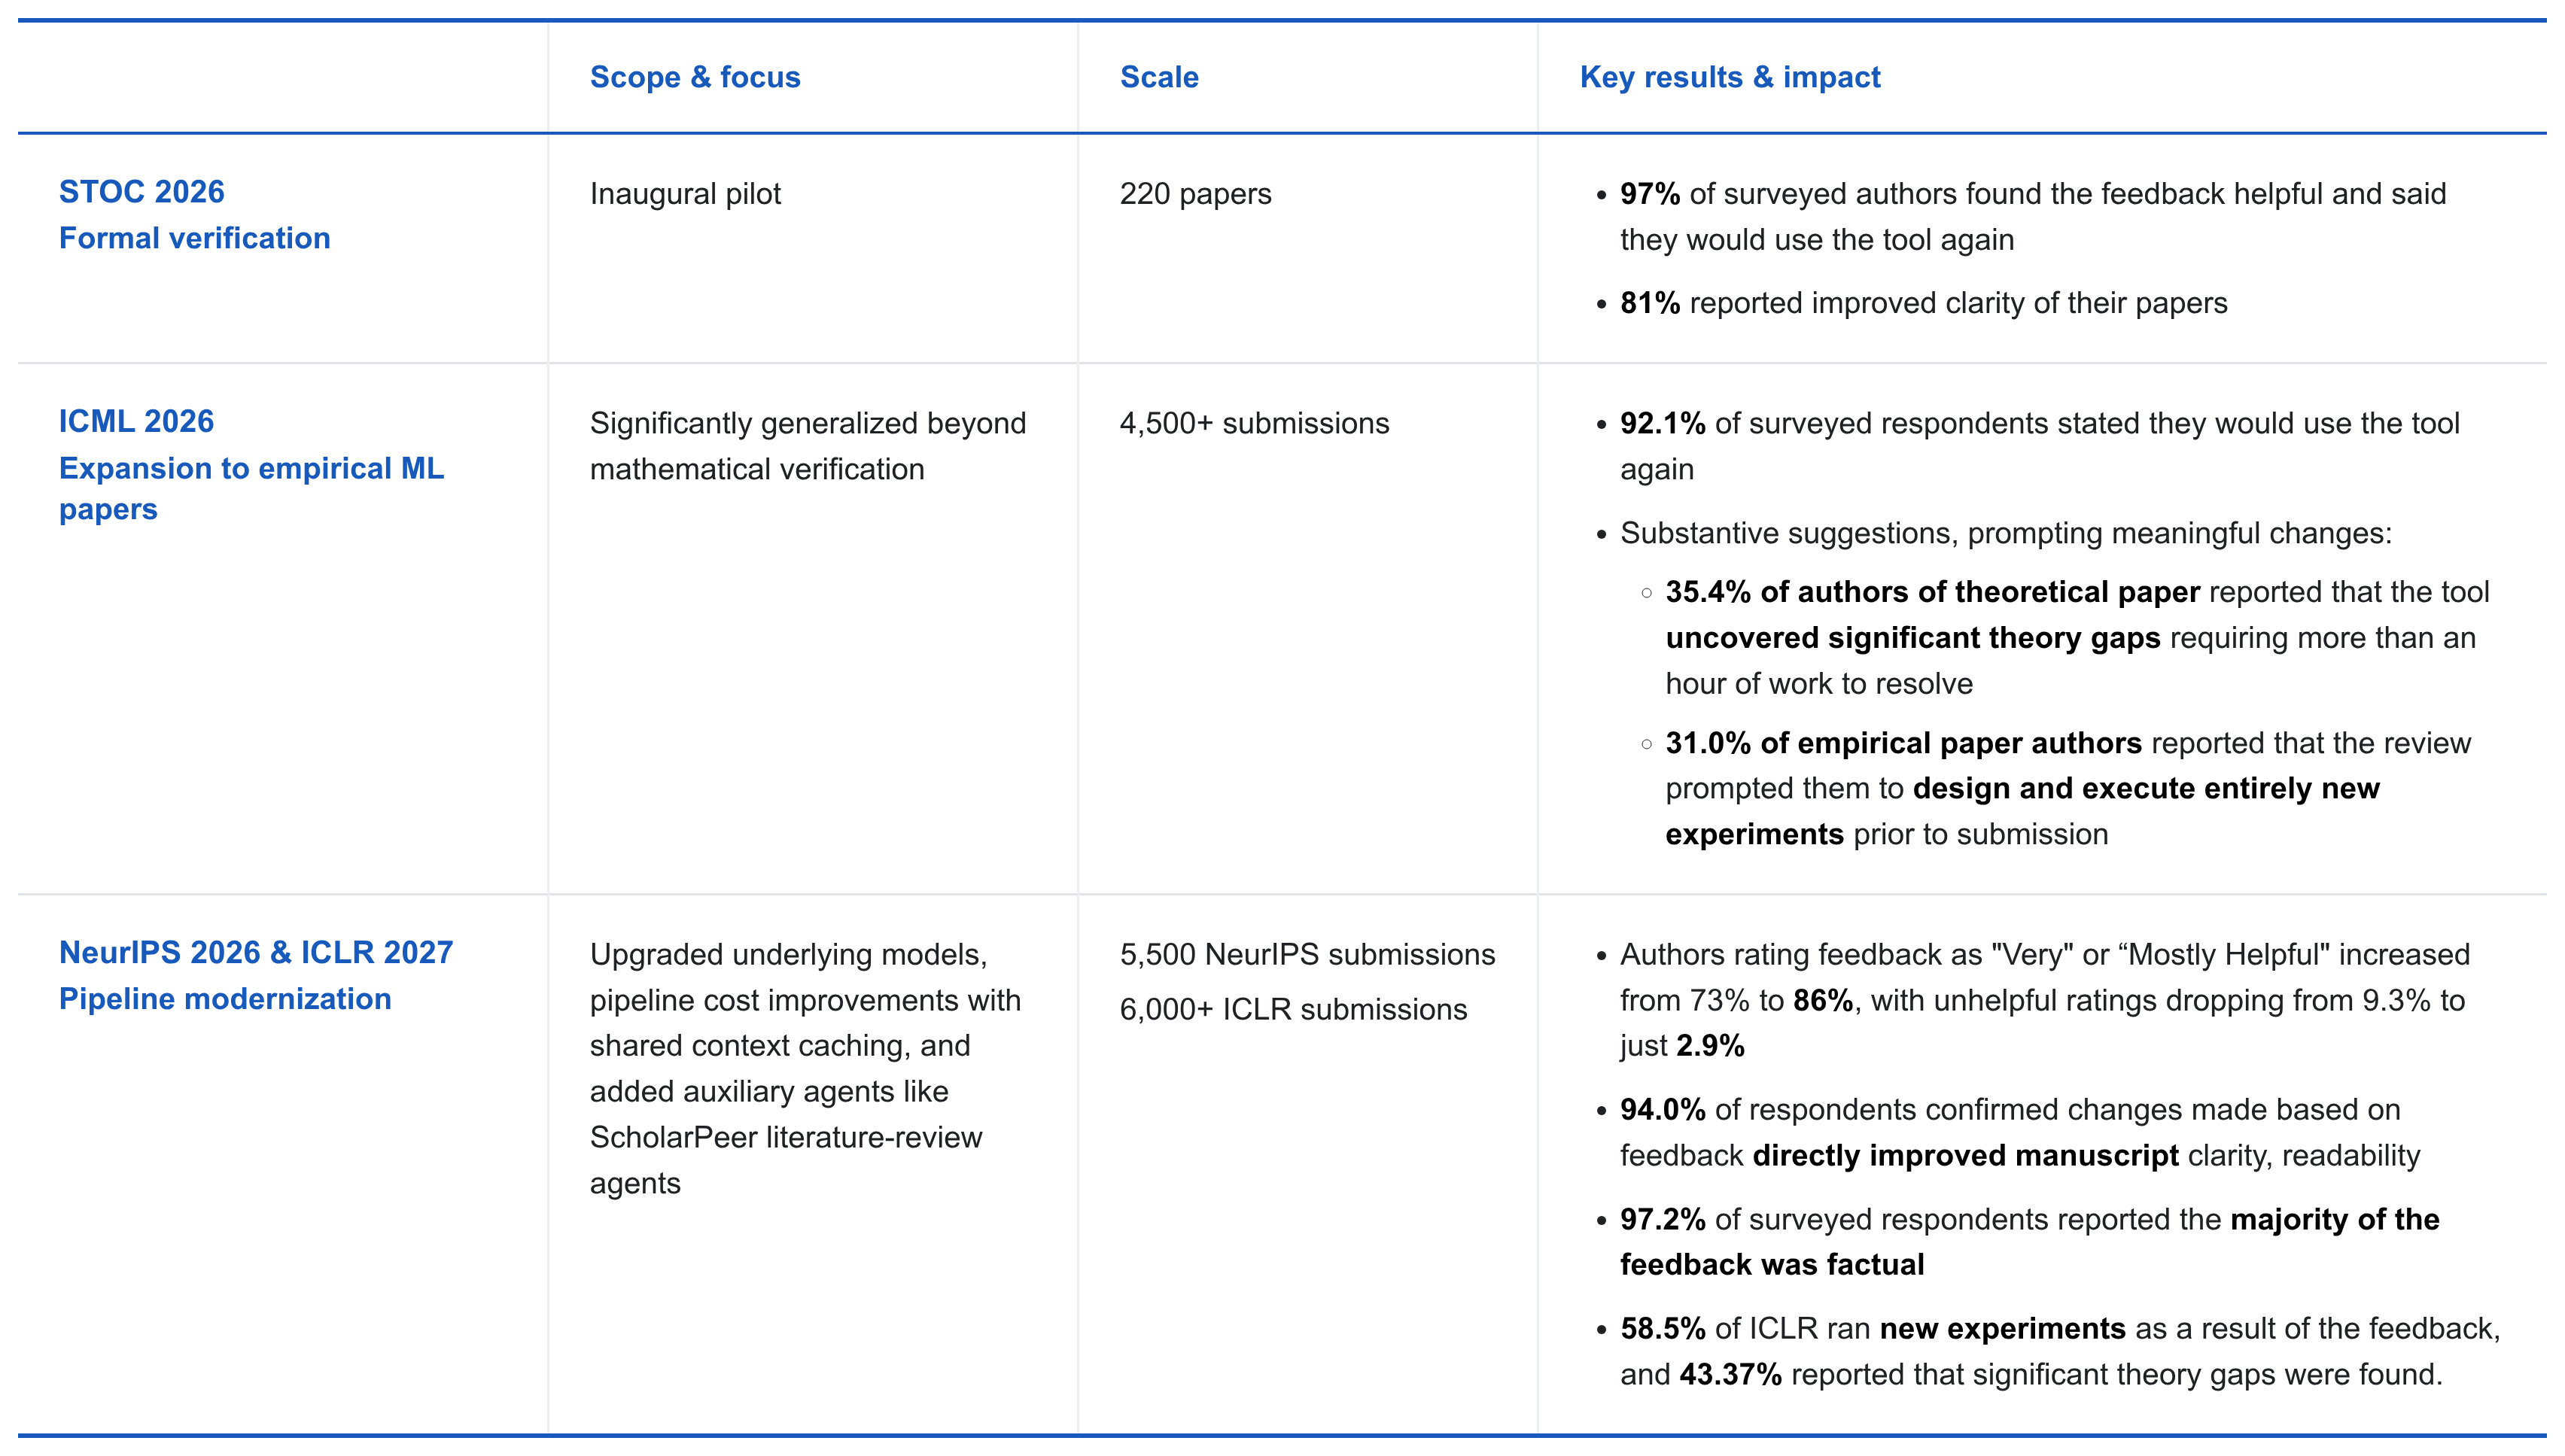
图源:Google Research 原文试点表,高清试点表。小屏下可先阅读下面的中文说明,再放大核对原始字段。
表中 STOC 试点涉及 220 篇论文,ICML 涉及 4,500 余份投稿,NeurIPS 与 ICLR 两项分别列出 5,500 和 6,000 余份投稿。这些数字说明系统被使用的范围,不能推导其缺陷检出准确率。
STOC 一行称,97% 的受访作者认为反馈有帮助并愿意再次使用。后续试点的一行称,97.2% 的受访者认为多数反馈符合事实。后者衡量受访者对整体反馈的感受,分母是问卷受访者,不能写成系统每条判断有 97.2% 准确率。
试点表还包含作者根据意见补做实验、改进表述或发现理论缺口的反馈。它们能支持工具具有使用价值这一判断。若要评估可靠性,还需要错误类型标注、干净对照、漏报与误报统计,以及人工复核协议。公开工程说明没有给出足以完成这些比较的完整数据。
原文将既往 PAT 试点与当前 Deep Review 的模型和流程演进联系起来,并说明公开服务加入 Gemini 4 Argon 支持。旧试点结果也不能直接作为新服务在所有文档领域的性能保证。本稿未进行独立复现。
使用边界与未披露部分
公开服务初期接受 PDF 和纯文本,多文件输入仍在计划中。原文列出的设计文档、演示文稿、法律和财务材料属于应用场景,不能据此推断所有原生文件格式已支持。
截至本次核验,原文写明每名用户每周获得两次免费文档审查,更高使用量可连接 Gemini API key,并通过 Deep Review API 集成。具体限制会随服务更新,实际使用应核对当前入口。
文档政策需要单独阅读。原文称公开服务上传内容不会用于训练、微调或改进 Google 模型,但为用户界面展示保存一年。此前合作试点结束后删除论文的安排属于另一阶段,不能直接套用到公开服务。未公开论文和受保密约束的材料,应先核对适用的上传与保存要求。
工程说明还没有披露完整分段算法、预算决策参数、并发规模、工具权限、成本分布和各阶段消融结果。四阶段架构可用于理解设计,完整复现仍需要更多实现信息。
可验证的工程尝试
以下建议根据原文机制提出,本次未执行。
首先,用一份包含摘要、数据划分、指标表和附录的短文档建立人工核验样本。分别准备一致版本,以及带有跨章节数字矛盾、缺失基线或划分泄漏描述的版本。比较整篇一次审查与保留全文上下文的分段审查,记录已知问题召回、干净版本误报、证据定位和计算成本。若发现数量增加但误报明显上升,应先修正审查标准。
其次,单独检查汇总阶段。输入含有重复意见、相互冲突的判断和缺少原文位置的反馈,观察系统能否合并同一问题、保留冲突证据并标明待核实项。成功判据应包括原始位置可追溯和结论不过度加强,不能只看报告更短或语言更顺。
这两项尝试分别检查局部分析与全局整合,能够帮助判断哪一阶段贡献了有效发现。正式写回文档前,保留原文、意见、依据和人工处理结果,可避免把未经确认的建议直接变成新的事实表述。
参考资料
Analyzing technical documents with Deep Review,Rajesh Jayaram、Vincent Cohen-Addad,Google Research,页面日期 2026-10-14,本次完整阅读日期 2026-10-17。
Google Research RSS,该文条目的发布时间为 2026-10-14 16:14 UTC,北京时间为 10 月 15 日 00:14。