Gated Attention for Large Language Models: Non-linearity, Sparsity, and Attention-Sink-Free 论文阅读
摘要
从逐头逐维SDPA输出门控的公式、张量与数值例子出发,核对非线性、稀疏与attention sink消融,完整解释稳定训练、长上下文外推和继续训练新增gate的负向结果。
自注意力先把上下文加权汇总,再把汇总结果送回残差流。Gated Attention 研究一个很小的改动:在每个注意力头的加权汇总之后,用当前 token 的隐藏状态计算 sigmoid 门控,逐维决定这些信息保留多少。Q、K、V、softmax 与因果掩码仍然存在,变化发生在 SDPA 输出到最终输出投影之间。
论文通过 30 余种门控变体、不同参数预算和训练设置,发现逐头独立、逐维、依赖当前输入的 SDPA 输出门控表现最好。作者从两条线索解释收益:在 value 与输出投影之间增加非线性;让汇总信息经过与当前 query 相关的稀疏过滤。实验还观察到 loss spike 减少、注意力过度集中于首 token 的现象缓解,以及长上下文外推更稳定。
论文发表于 NeurIPS 2025,获得最佳论文奖。作者主要来自 Qwen 团队,并有爱丁堡大学、Stanford、MIT 和清华大学参与。本文使用 27 页会议正式版,原始 arXiv 编号为 2505.06708。代码在 qiuzh20/gated_attention,模型在 QwQZh/gated_attention。
对正在微调已有大模型的读者,有一项附录结果需要先记住:作者在继续训练时给已有模型加入输出门控,未观察到明显性能收益,也未消除已有的巨大激活和 attention sink。 主要正向实验来自带门控架构的预训练,这篇论文不能直接转换为“给任何 checkpoint 加一个 gate 就能改善”的微调配方。
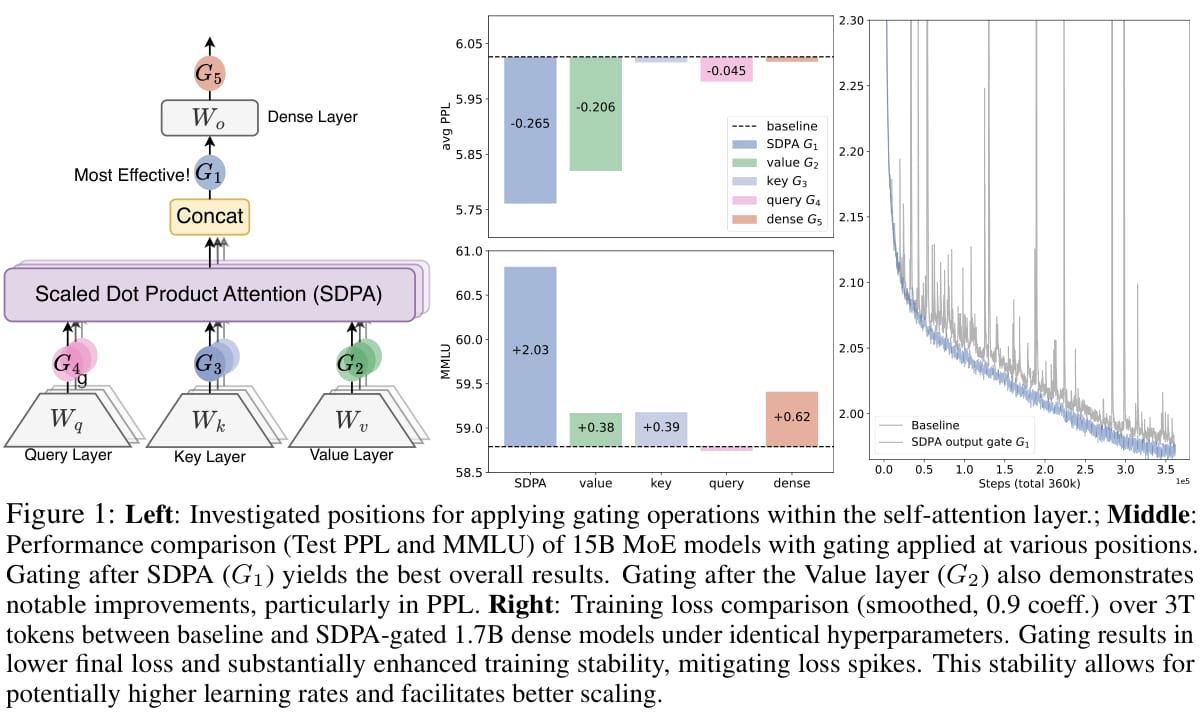
图 1|论文原图 Figure 1,PDF 第 2 页。左侧列出五个插入位置,中间比较位置变体,右侧比较预训练 loss。右图是 1.7B 稠密模型在大规模训练下的曲线,不能当作单次 LoRA 微调结果。
从标准注意力走到门控,计算流程有什么变化
设输入为 。论文用 pre-normalization 后的隐藏状态计算门控。标准注意力先投影得到:
对第 个 query head,scaled dot-product attention 是:
表示因果或其他有效注意力掩码,确保模型只使用允许访问的位置。多头结果拼接后乘以 ,得到可加入残差流的输出。
论文的推荐门控放在 之后、 之前:
是 query head 数, 是每头维度, 是逐元素乘法。推荐版本每个 query head 有独立的 维 gate。sigmoid 得分处于 0 到 1 之间,低分让对应输出分量衰减,高分让它较多保留。gate 由当前 token 的输入算出,与本次 query 对应。
softmax 内的注意力权重仍然按行归一化,门控在信息汇总之后工作。 一次 forward 中,它不会先改写 softmax 矩阵,也不会直接把特定历史 token 从 KV cache 删除。模型训练后,Q/K/V 和其他参数会适应门控,因而最终学习出的 attention pattern 可以改变。这两个层面需要分开理解。
GQA 中多个 query head 可以共享 KV head,但门控仍按 query head 分别计算。例如论文 MoE 配置为 32 个 query head、4 个 KV head、每头 128 维;逐维 G1 得分张量形状是 。共享 KV 不意味着 gate 也应共享,正是这一点在消融中影响明显。
一个数字例子与实现位置
假设两个头的 SDPA 输出为 、。当前 token 的 gate 分别是 和 。逐维相乘后得到 与 ,拼接结果 再进入输出投影。
这个教学例子说明门控可以保留某头的一个维度,同时强烈压低另一个维度。一个 headwise 标量只能统一缩放整头,不能做到这种维度选择;head-shared 向量则迫使不同头使用相同的过滤模式。数值由本文构造,不对应论文测得的某个真实 token。
下面是张量布局明确的教学伪代码,帮助定位插入位置。省略已有 QKV 投影、RoPE、KV cache 与分布式后端,实现不能直接替代模型原 attention:
关键是 gate 与 query head 对齐,乘法发生在 out_proj 之前。若输出投影后再门控,就变成论文 G5 位置;若先给历史 value 门控,就变成 G2。变量名同样叫 gate,实际方法却不同。训练目标仍是语言建模损失,不需要为“稀疏”额外编造一个正则项来解释本文结果。
为什么作者比较五个位置,而不能随便乘一个 gate
门控机制并非新发明。LSTM、SwiGLU、状态空间模型、线性注意力和部分 softmax attention 都使用它。本文的工作是把门控与路由、稀疏选取等其他改动拆开,比较门控自身的作用。
位置 | 在哪里操作 | 主要变化 |
|---|---|---|
G1 | SDPA 输出后、 前 | 当前 query 决定已汇总信息的保留程度 |
G2 | value 投影后 | 历史位置各自决定其 value 被后续查询使用多少 |
G3 | key 投影后 | 改变进入注意力相似度计算的 key |
G4 | query 投影后 | 改变当前查询向量 |
G5 | 最终输出投影后 | 对已经混合到模型维度的输出进行调制 |
作者还比较 elementwise 与 headwise、head-specific 与 head-shared、乘法与加法、sigmoid 与 SiLU。默认的有效方案是逐头独立的乘法 sigmoid 门控。加法版本即 ,为注意力结果增加另一条信息支路,它与乘法过滤的作用不同。
一项相关动机来自 Switch Head 实验。把注意力专家数量缩减到一个、无需真正选择多个专家时,仍有收益,此时操作等价于 value 端门控。这说明某些含路由的架构收益中,门控本身可能有重要贡献。附录 A.1 给出这种控制实验,但它不证明专家路由在所有架构里都没有价值。
实验规模与参数预算怎样控制
实验包括 15B MoE 与 1.7B 稠密模型。15A2B 模型总参数约 15B、每 token 激活参数约 2.54B,24 层、hidden size 2048,128 个专家,top-8 路由,query/KV heads 为 32/4,head dimension 为 128。专家路由的 gate 与本文 attention output gate 是两个不同组件。
稠密模型有 28 层与 48 层两类,hidden size 分别 2048、1536,两者约 1.7B 参数,query/KV heads 为 16/8,head dimension 为 128,输入输出 embedding 共享。模型使用 QK normalization。更深模型减小宽度,以保持参数规模可比。
训练数据来自约 4T 高质量 token 池的子集,包含多语言、数学与一般知识;具体实验采用 400B、1T 或 3.5T token 预算。通常序列长度为 4,096,不能把“比较 30 余个变体”理解成每个变体都分别训练了 3.5T token。
MoE 的主要位置实验训练 400B token,global batch 1024,100K optimization steps,学习率在 1K 步 warmup 到 ,cosine 降到 。作者加入增加 KV head、query head 和专家数量的基线,避免把新增参数本身误当作门控机制收益。
稠密模型加入 gate 时减小 FFN 宽度,使总参数量基本保持一致。作者报告其测试环境中的额外 wall-time latency 低于 2%,这是特定实现与规模下的开销观察;本文没有将它当作所有推理引擎、量化格式和硬件的固定延迟上限。
主要结果:G1 最好,粒度与开销各有取舍
下面摘取 Table 1 的核心对照。Added Param 的单位为百万参数,PPL 越低越好,其余是对应评价分数。
400B-token MoE 变体 | 新增参数 M | Avg PPL | MMLU | GSM8k |
|---|---|---|---|---|
baseline | 0 | 6.026 | 58.79 | 52.92 |
KV heads 4 → 8 | 50 | 5.979 | 59.78 | 52.16 |
query heads 32 → 48 | 201 | 5.953 | 58.45 | 53.30 |
增加 4 个专家 | 400 | 5.964 | 58.84 | 52.54 |
G1,逐维 sigmoid | 201 | 5.761 | 60.82 | 55.27 |
G2,逐维 sigmoid | 25 | 5.820 | 59.17 | 53.97 |
G1,逐头标量 sigmoid | 1.6 | 5.792 | 60.05 | 54.44 |
G1,跨头共享向量 | 201 | 5.801 | 60.06 | 53.15 |
G1 逐维门控比 baseline 的 PPL 低 0.265,MMLU 高 2.03 分,优于表中参数扩充对照。逐头标量只增加约 1.6M 参数,仍接近逐维方案,但并非各项都最优。这为资源有限的实验提供一个轻量对照。
这里“简单修改”指计算结构容易描述,不代表所有方案只多几个参数。逐维 gate 跨全模型增加约 201M 参数,约为 15B 总参数的 1.34%;headwise 才是百万级增加。参数量、激活 FLOPs 和墙钟时间是不同成本口径,应分别核对。
G3、G4、G5 在该表中没有得到与 G1 同量级的 PPL 收益。sigmoid 乘法 G1 优于 SiLU 乘法或 SiLU 加法,但单项 benchmark 有波动。论文的结论来自综合对照,不能写成所有任务分数都单调提高。
第一条机制线索:value 与输出投影之间的非线性
对当前 token 、某个注意力头 ,把输出投影对应的分块写成 ,标准注意力可表达为:
每头的 把 投影到 , 再投回模型维度,所以乘积秩最多为 。当 ,这条 value-to-output 通路是低秩线性映射。GQA 还让组内多个头共享 value 投影,进一步限制该通路的独立性。
这段推导针对 value 到 output 的映射,不代表整个 attention 是线性的。 本身依赖输入并经过 softmax,完整注意力已经有非线性。论文关注的是在固定这部分权重的表示中,连续两个 value/output 线性投影可合并,而它们之间缺少新的非线性调制。
G2 在每个历史 value 上插入非线性,G1 在汇总之后插入当前输入相关的非线性,都位于 与 之间。G5 发生在二者之后,没有直接处理这个映射。这个位置解释与主实验的优势趋势一致。
Table 3 用更多控制验证该想法:每头 SDPA 输出 RMSNorm 不显著增加参数,PPL 从 6.026 降到 5.847;只加入 SiLU 降到 5.975,收益较小;移除加法 gate 中的 SiLU 后,收益也变小。这些实验支持“中间非线性有价值”,但 RMSNorm、乘法 gate 与其他变换还改变了尺度和优化行为,尚不足以把所有收益严格归因于一种表达能力证明。
论文有一个 input-independent gate 对照,用可学习但与输入无关的 sigmoid 系数缩放输出,PPL 为 5.917。作者把改善与非线性联系起来;从映射本身检查,固定参数下的常数缩放仍可并入线性投影,不等于对输入新增非线性。这个对照更稳妥的阅读结论是:单纯可学习重标定也可能改变优化结果,但效果弱于输入相关 gate,具体因果仍需进一步分析。
第二条机制线索:当前 query 决定的稀疏过滤
G1 与 G2 都位于 value/output 通路之间,G1 仍更有效,因此作者继续分析 gate 分布。最有效的 G1 逐维 sigmoid 在该 MoE 测试中平均得分为 0.116;G2 为 0.221;跨头共享 G1 为 0.271。许多得分集中在零附近,表明部分输出分量被大幅衰减。
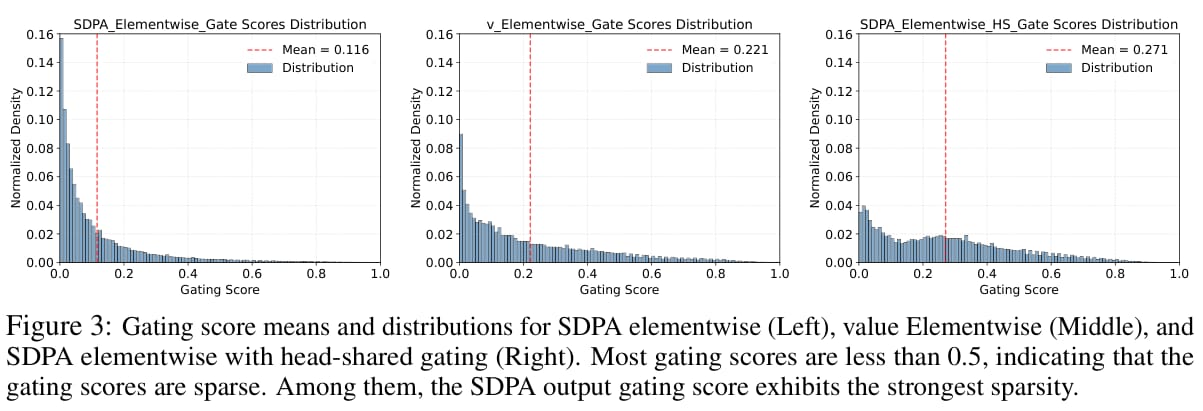
图 2|论文原图 Figure 3,第 8 页。G1 的分布最集中在低值区。这里的稀疏指许多分量很小,不是 sigmoid 自动产生大量严格为零的值。
G1 得分由当前 决定。相同历史信息对一个 query 有用,对另一个 query 无用,当前 token 可以使用不同过滤方式。G2 得分由历史 决定,是在未来 query 出现前对 value 进行调制,两者提供的条件信息不同。
作者用两类控制检查这种解释。跨头共享得分降低各头自主选择的空间,效果弱于逐头独立;input-independent gate 没有当前 query 信息,表现也较差。还使用非稀疏激活:
它仍有非线性,但得分限制在 0.5–1.0,不能强烈压低输出。平均 gate 为 0.653,PPL 5.900,弱于正常 sigmoid 的 5.761。这个实验在尽量保留非线性时减少了强抑制能力,支持稀疏过滤也参与收益。
平均缩放是否就够了?附录把 SDPA 原输出统一乘以平均 gate,再与真正的动态 gate 对比。在 阈值下,小值比例从门控前 0.03 到统一缩放 0.33,动态门控达到 0.44; 阈值下则为 0.003、0.080、0.126。统一缩小整体幅度解释了部分变化,输入相关、逐维的门控还带来额外稀疏结构。
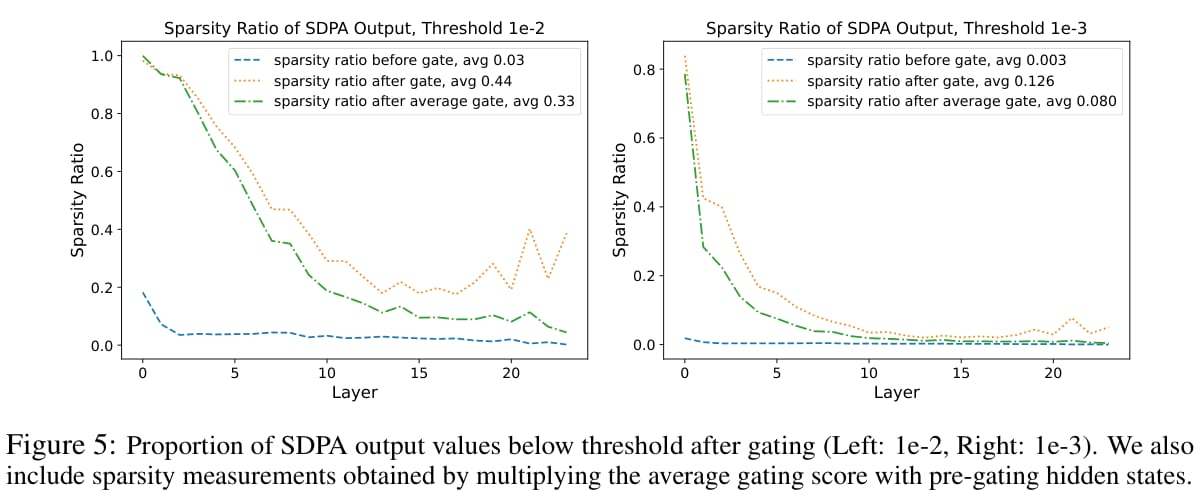
图 3|论文原图 Figure 5,第 18 页。阈值定义的稀疏度对数值尺度敏感,因此论文加入平均 gate 缩放作为对照,避免仅把“输出整体变小”当作全部机制。
这些结果主要是消融与统计证据。它们支持输入相关稀疏过滤的解释,尚未给出完整理论证明,说明任意 token 的哪项语义信息必然被正确删除。
Attention sink 与巨大激活:观察、关联和因果要分开
attention sink 指某些 token 获得与其语义重要性不相称的大量注意力,常见于序列起始位置。softmax 每行必须把非负权重分配到和为 1,当当前头不需要上下文信息时,模型可能借助某个位置承接多余权重。这是论文借鉴已有工作讨论的解释。
G1 提供另一种控制方式:即使 SDPA 汇总了信息,当前 query 仍可以把输出压低。模型在训练中因此可能减少对特殊 sink token 的依赖。论文测量首 token 权重、各层 hidden-state 最大激活与 gate 分布,得到以下对照:
变体,Table 4 | 平均 gate | M-Act | 首 token 权重 F-Attn |
|---|---|---|---|
baseline | — | 1053 | 0.467 |
G1,逐维 | 0.116 | 94 | 0.048 |
G1,逐头标量 | 0.172 | 98 | 0.073 |
G1,跨头共享 | 0.271 | 286 | 0.301 |
G2,value 逐维 | 0.221 | 125 | 0.297 |
G1,输入无关 | 0.335 | 471 | 0.364 |
G1,NS-sigmoid | 0.653 | 892 | 0.451 |
M-Act 是论文聚合的 hidden-state 最大激活统计,不能当作所有 token 的平均幅度。baseline 首 token 权重平均 46.7%,推荐 gate 降到 4.8%。标题中的 attention-sink-free 描述现象显著缓解,4.8% 的首 token 权重仍然存在,不能解释成禁止模型关注首 token。
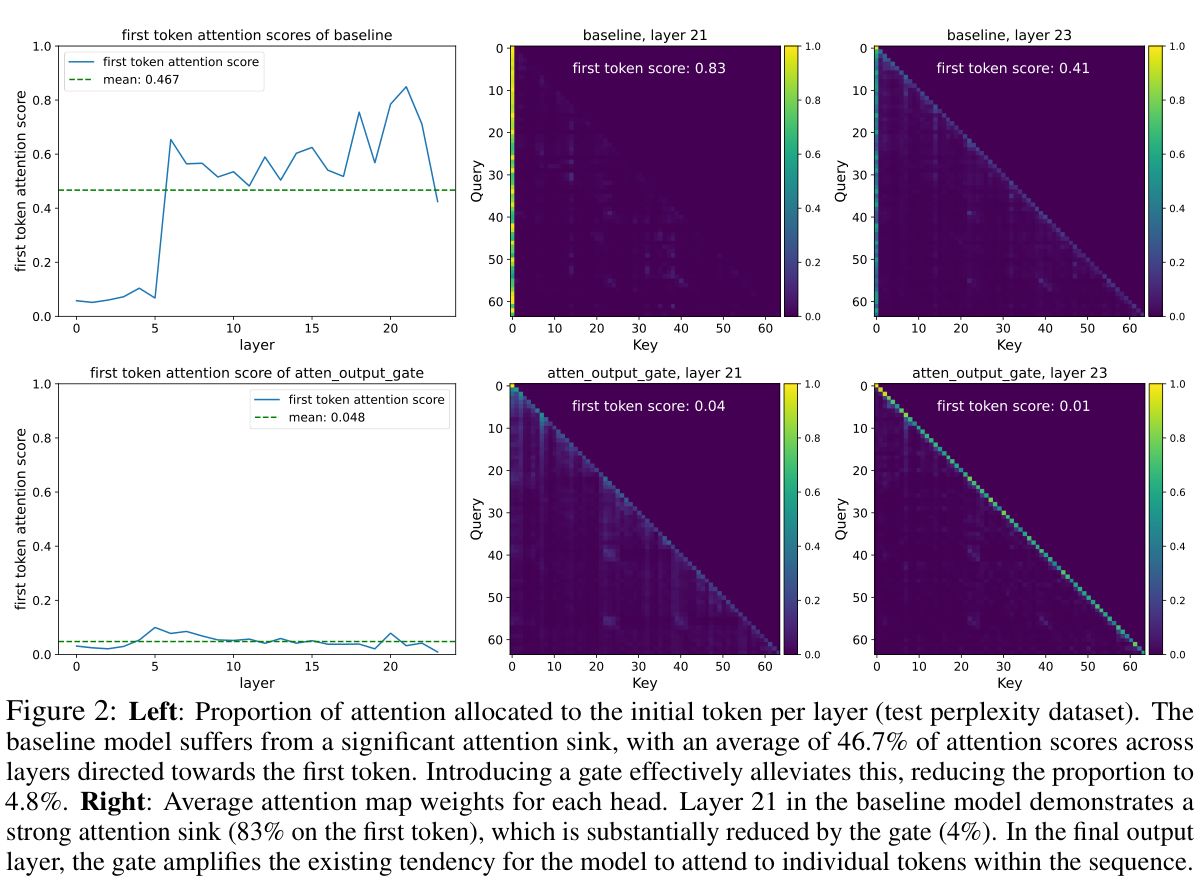
图 4|论文原图 Figure 2,第 3 页。某一 baseline 层首 token 占比达 83%,对应 gate 模型约 4%。热图与平均统计共同帮助识别 sink,不能仅凭一层的单个数概括整个模型。
G2 是一个有价值的反例:M-Act 从 1053 降到 125,但首 token 权重仍有 29.7%。降低巨大激活没有自动消除 sink,二者不能直接等同。正文分析与附录 A.4 均据此指出,巨大激活不是 sink 出现的必要条件;相关工作段有相反字样,阅读时应以实验及明确分析为准。
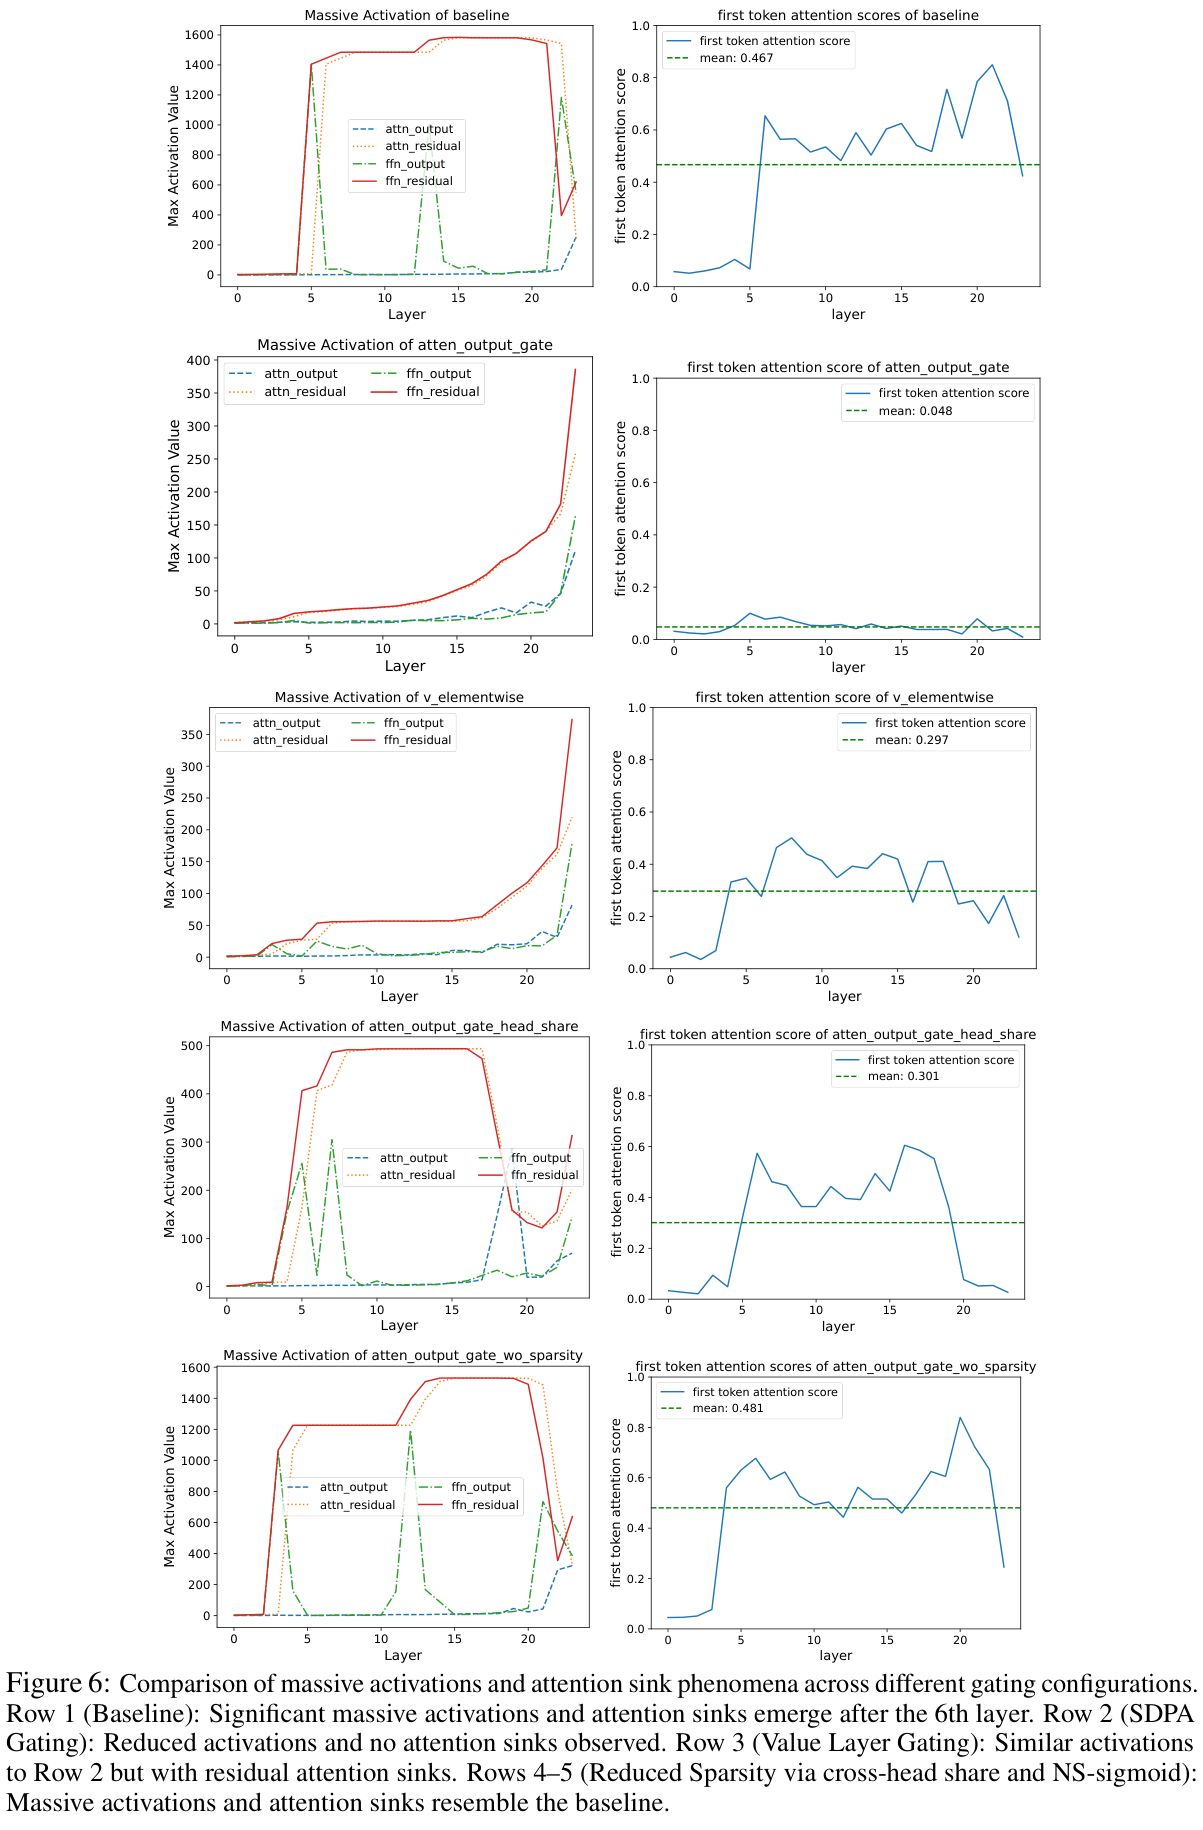
图 5|论文原图 Figure 6,第 19 页。baseline 早期 FFN 产生较大激活,经过残差传播到后续层。推荐 G1 同时缓解巨大激活与首 token 集中;value gate 仍残留 sink。
作者认为小一些的激活可能减少 BF16 数值误差,进而改善稳定性,这是根据现象提出的机制解释。附录又尝试把 attention 与 FFN 输出 clip 到 100 或 300 范围,高学习率下仍有收敛问题。因此训练稳定性还涉及层内计算、归一化、优化与梯度,不能简单归结为把残差流里的大数截掉。
训练稳定性如何变成更好的超参数空间
门控在原来较稳定的配置下通常有收益,高学习率设置更能暴露不同方法的边界。Table 2 的稠密模型保持参数总量相同,以下摘取 48 层的主要对照:
预算与 batch | 配置 | 最大学习率 | Avg PPL | MMLU | GSM8k |
|---|---|---|---|---|---|
400B,1024 | baseline | 0.004 | 7.421 | 52.04 | 32.98 |
400B,1024 | baseline | 0.008 | 9.195 | 44.28 | 15.24 |
400B,1024 | baseline + sandwich norm | 0.008 | 7.407 | 52.07 | 32.90 |
400B,1024 | G1 逐维 | 0.004 | 7.288 | 52.44 | 32.37 |
400B,1024 | G1 逐维 | 0.008 | 7.325 | 54.47 | 36.62 |
1T,4096 | baseline | 0.008 | 训练发散 | — | — |
1T,4096 | G1 逐维 | 0.008 | 7.078 | 56.47 | 39.73 |
高学习率下 baseline 在不同预算中表现恶化或发散,sandwich norm 能恢复部分收敛,但 gate 模型更有能力使用较大更新。G1 在 400B 设置把学习率从 0.004 提到 0.008,PPL 稍差而 MMLU/GSM8k 更好,说明优化不同指标还需要权衡。
作者建议从 baseline 已调好的 batch size 出发,适度增加学习率,再继续联合探索 batch 与学习率。这里的 0.004、0.008 是这些从头预训练设置的数值,不能直接复制到自己的 SFT、LoRA 或 RL。架构改变也改变最佳超参数,公平比较既要有同配置对照,也要观察各自合理调参后的表现。
长上下文实验实际做了两次扩展
长上下文结果来自在 3.5T token 训练后继续扩展的模型。第一阶段将 RoPE base 从 10K 改为 1M,并用长度 32K 的数据再训练 80B token,获得 32K 模型;第二阶段用 YaRN 把上下文扩展到 128K,再用 RULER 评价。
第一阶段包含训练。标题和结论中的长度外推不能省掉前面的 80B-token 继续训练,把整套过程写成从 4K 无训练直接获得可靠 128K 能力。
RULER,Table 5 | 4K | 8K | 16K | 32K | 64K | 128K |
|---|---|---|---|---|---|---|
32K baseline | 88.89 | 85.88 | 83.15 | 79.50 | — | — |
32K gate | 90.56 | 87.11 | 84.61 | 79.77 | — | — |
YaRN 扩展 baseline | 82.90 | 71.52 | 61.23 | 37.94 | 37.51 | 31.65 |
YaRN 扩展 gate | 88.13 | 80.01 | 76.74 | 72.88 | 66.60 | 58.82 |
在训练覆盖的 32K 内,未 YaRN 扩展时二者很接近:79.50 与 79.77。扩展后,baseline 原 32K 范围下降 41.56 分,gate 下降 6.89 分;128K 下为 31.65 与 58.82。主要差异出现在改变位置编码后的鲁棒性与外推,不能只笼统概括为训练长度内的长文理解全面更好。
作者推测 baseline 依赖 sink 调整注意力分布,位置编码扩展扰动它;gate 模型有输入相关的输出控制,因而更适应这种变化。论文明确没有完整理论解释 sink 如何影响长度泛化。RULER 也以特定长上下文任务为主,结果不能直接等同于真实多轮 Agent 的长期记忆、事实综合或工具决策能力。
给已有模型新增门控,原文的负向结果是什么
附录 A.7 专门测试了继续训练阶段加入 attention output gate。作者报告它没有缓解已经形成的巨大激活和 attention sink,也没有明显改变最终性能,认为作用主要来自从头训练时的动力学。
这是一个经验负向结果,附录没有展开足够多的不同初始化、不同继续训练长度和模型类型,不能进一步证明所有继续训练方案永远无效。但它直接限制了应用建议:若当前重点是微调已有 checkpoint,这篇论文主要帮助理解架构与预训练,不应作为已经验证过的即插即用微调技巧。
新增 gate 会改变函数形式、参数与 checkpoint 兼容性。默认零 logits 会产生 sigmoid 0.5,初始输出被缩小;若想接近原函数,需要额外设计初始化与恢复训练,效果仍要实验确认。这个初始化观察来自公式,是迁移时的工程推导,不是作者已验证的成功补救方案。
如果正在设计自己从头训练的小模型,可以将 G1 逐维与低参数 headwise 方案纳入对照,控制数据、token 预算和参数总量,观察 loss spike、激活、gate 分布与任务分数。若训练预算很小,只验证了几百万 token 的试验,结论也只能覆盖那个预算,不能直接复现本文 400B–3.5T 的收益。
稀疏门控对 Agent 的意义与边界
Agent 输入常包含工具结果、失败日志、检索片段和反复追加的指令。当前 query 需要的信息随步骤变化,输出门控的输入相关过滤提供一个可研究的模型层控制方式。但本文没有以长时程 Agent 为主任务,也没有直接报告 Agent 工具成功率,不能据此承诺它会自动消除上下文噪声或减少错误调用。
门控的“稀疏”主要是输出数值稀疏,推荐 G1 仍计算稠密 softmax attention。它没有把 注意力复杂度自动变成线性,也没有减少需要保存的历史 KV 数量;没有稀疏内核时,小值本身通常不会带来省算。它与下一篇 DeepSeek 的缓存压缩、索引选择和有界重放解决不同层面的成本问题。
即使模型层过滤更有效,系统仍需要好的上下文政策、可核验评测与工具协议。前面 Manus 的缓存前缀和观察策略、Anthropic 的任务评价、Agent Lightning 的训练轨迹边界,以及 DR Tulu 的证据奖励,分别管住不同环节。架构实验不能替代这些系统验证。
读完应能独立解释哪些关系
理解本文的核心,应能画出从 QKV 到 SDPA、gate、concat、 的真实顺序,说明 gate 来源、张量维度与 GQA 的对应;能解释 G1/G2/G5 的不同位置为什么影响非线性;能区分输出稀疏、稀疏 attention 和 KV 压缩;能把 sink、巨大激活、稳定性与长度外推的证据和推测分别说明。
结果的限制也要一起保留。作者在 checklist 中明确未给多次大规模预训练的误差条,原因是计算成本;若单项分数差很小,应考虑随机性。论文没有完整的 sink 泛化理论,主要结论依赖实验。继续训练新增 gate 的负向结果属于重要适用边界,不能在介绍推荐实现时省掉。
原文第 2 节是方法定义,第 3 节是架构与主结果,第 4.1–4.4 节分别讨论非线性、稀疏、sink 和长度扩展。附录 A.1 给 Switch Head 控制,A.2 给架构,A.3–A.5 给逐层分析,A.6–A.7 给 clipping 与继续训练的负向结果。本文公式依据 Equations 2、5、6、9,表格摘录自 Tables 1、2、4、5。
继续阅读入口:会议正式 PDF、官方实现、官方模型。文中实验成绩为作者报告,数值例子、伪代码和迁移推导已标明,本文未独立运行大规模预训练。