
Olmo 3 论文阅读
摘要
完整追踪 Olmo 3 的数据处理、受约束混合、中训练和长上下文课程,讲清 Think、Instruct、RL-Zero 的 SFT/DPO/RL 方法与奖励、系统实现和实验证据。
Olmo 3 公开了一组模型的训练路径:原始数据怎样处理,混合比例怎样选择,预训练底座怎样为推理和工具使用做好准备,SFT、DPO 与强化学习怎样衔接,以及中间检查点如何用于分析。对自己训练或微调模型的读者,这份报告的价值在于能沿着一条完整路径追踪设计决策与能力变化。
报告覆盖 7B 与 32B,包含 Base、Think、Instruct 和 RL-Zero。Think 面向带较长推理过程的任务,Instruct 面向直接回答与工具交互,RL-Zero 用开放底座研究从奖励开始学习。数据课程、评价设计与训练基础设施共同决定结果,任何单个最终分数都不足以解释全部收益。
信息 | 内容 |
|---|---|
论文 | Olmo 3 |
作者 | Olmo Team,Allen Institute for AI 与合作研究者;作者按字母排序 |
版本 | arXiv:2512.13961v2,2026-04-14;首次预印本于 2025-12 |
类型 | 开放模型训练技术报告,本文按论文研究报告变体解读 |
阅读范围 | 正文 §1—6;架构与训练配置、偏好损失、去污染等必要附录 |
模型 | 7B/32B decoder-only Transformer;本文按所读版本区分 Olmo 3 与 3.1 |
基座数据 | Dolma 3 Mix、Dolmino Mix、Longmino Mix |
后训练数据 | Dolci Think/Instruct SFT、DPO、RL,以及 RL-Zero 数据 |
原文 | |
主要实现 |
先按 Model Flow 分清训练阶段
模型训练不是只把一个数据集送进一个循环。Olmo 3 先训练通用底座,再用更集中数据改善目标能力、扩展上下文,最后选择后训练路线。下图给出了数据、阶段与模型分支的对应关系。
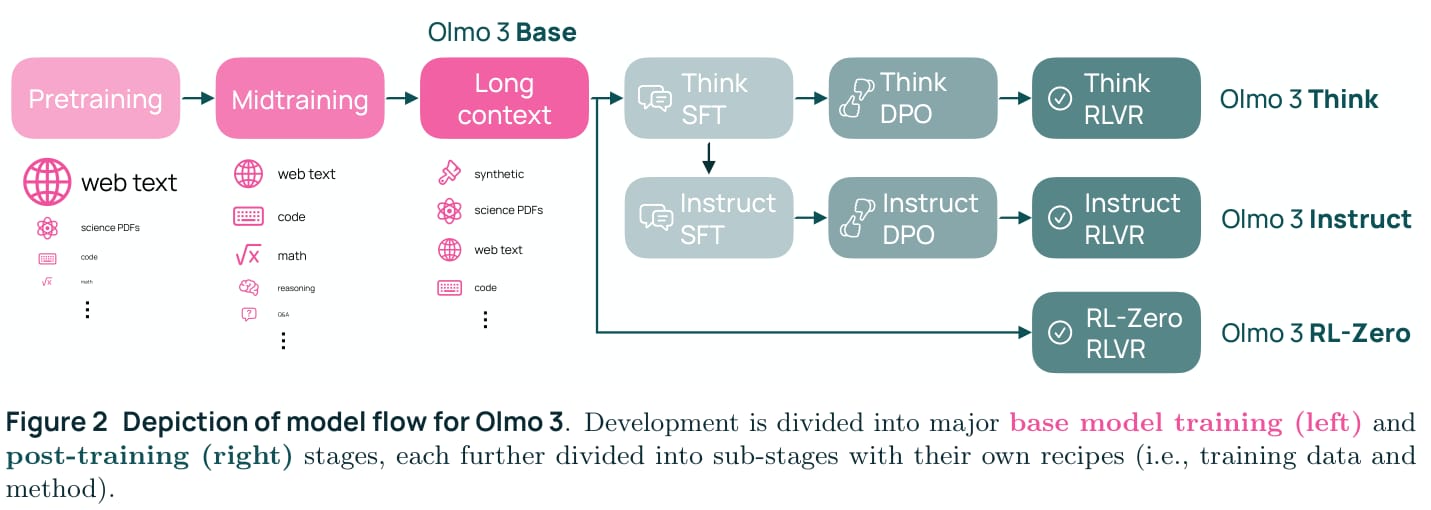
来源:论文 v2,Figure 2,PDF 第 4 页。
阶段 | 主要作用 | 数据或训练方式 |
|---|---|---|
Pretraining | 建立语言、知识与通用代码/数学基础 | Dolma 3,下一 token 预测 |
Midtraining | 集中补强数学、代码、QA、指令与推理基础 | Dolmino 高质量混合与继续训练 |
Long-context extension | 从 8192 扩展到 65536 token | Longmino、位置编码调整与长序列训练 |
Think SFT | 学会结构化推理过程与回答 | 经验证和过滤的推理轨迹 |
Think DPO | 利用答案对比中的能力差异 | 高对比 chosen/rejected 数据 |
Think RL | 根据实际采样结果与奖励进一步优化 | 多领域奖励、OlmoRL |
Instruct 路线 | 直接回答、多轮交互与 function calling | 从 Think SFT 起步,再用 Instruct SFT/DPO/RL |
RL-Zero | 研究底座如何直接接受奖励学习 | Base 起步,跳过相应 SFT/DPO 阶段 |
Model Flow 的开放性意味着研究者可以检查中间数据和权重,选择某个阶段进行干预。发布最终权重、公开训练混合与公开整个训练依赖是不同开放程度。报告中的 strongest fully-open 等表述属于作者在其比较范围内的判断,本文不将它延伸为当前所有模型的排名。
预训练混合约 5.93T token,7B 按接近完整混合训练,32B 的预训练在约 5.5T 处结束;中训练为 100B,长上下文阶段为 7B 的 50B 与 32B 的 100B。源数据池更大,重复采样后进入训练的 token 数与唯一文档数量要分开理解。
架构与训练条件怎样支撑这条路径
Olmo 3 使用 decoder-only Transformer,沿用 OLMo 2 的 tokenizer,来源于 cl100k。7B 有 32 层、hidden size=4096,32B 有 64 层、hidden size=5120。7B 使用 32 个 Q/KV heads,32B 使用 40 个 query heads 与 8 个 KV heads,后者采用 GQA 降低缓存与注意力开销。
模型使用 SwiGLU、RMSNorm 和 QK-Norm。预训练与中训练上下文为 8192 token,其中每四层有三层滑动窗口注意力,窗口大小 4096,最终一层始终保留全注意力。局部层降低长序列开销,全局层保留跨更远位置的信息交互。这个结构也决定后面位置编码扩展应该作用于哪些层。
基础训练使用 OLMo-core 与 bf16,结合编译、自定义算子、异步日志和检查点写入。报告的每 GPU 吞吐与 MFU 是相应集群及序列条件下的测量,不能直接预测消费级 GPU 性能。长上下文阶段采用 8 路 context parallelism,使每张设备承担部分序列,并支持滑动窗口与文档隔离掩码。
在预训练中,7B 的 peak LR 为 3e-4,32B 为 6e-4,两者 warmup 都是 2000 步。较大模型使用更高 peak LR 并不与常见经验形成通用冲突,因为有效 token batch、训练课程与学习率日程也不同。复用配置时需要同时查看这些条件,不能只抄模型大小与学习率。
先构建能比较小模型的数据评价
训练数据的选择需要大量实验,而完整 32B 训练代价很高。作者用小模型和较短训练进行代理比较,前提是小规模评价必须能给出有效信号。
在困难数学题或代码任务上,小模型可能接近随机,准确率无法区分候选数据。OlmoBaseEval 因此包含 Base Easy 与 Base Main。前者用 bits-per-byte 等连续代理指标支持小规模决策,后者检查较大模型的实际任务能力。
BPB 可以理解为答案的负对数概率,转换为 bit 后除以 UTF-8 字节数:
它测量模型对参考答案的概率,越低越好。按字节归一化有助于减少不同 token 切分造成的口径差异,但 BPB 改善仍需验证是否转化为真实生成任务收益。
作者用约 23K 条评价结果与 70 个外部模型分析任务关系,根据模型排名相似性做层次聚类,再进行必要人工调整,形成数学、代码、生成问答、STEM/非 STEM 多选等能力簇。聚合相关任务和提高样本量,可以减少单个基准噪声主导决策。
评价还保留独立的 held-out 任务,例如 MMLU Pro、DeepMind Math、LBPP 与 BBH,以检查开发集优化有没有泛化。小规模代理、主要开发指标与最终留出评价分别承担不同责任。只盯单个公开榜单混数据,很容易把数据课程变成针对该榜单的优化。
预训练数据:抽取、去重、分类与混合
下图展示各来源先经过适合自身的处理,再进入统一混合。去重与重复采样同时出现,需要按先后顺序理解。
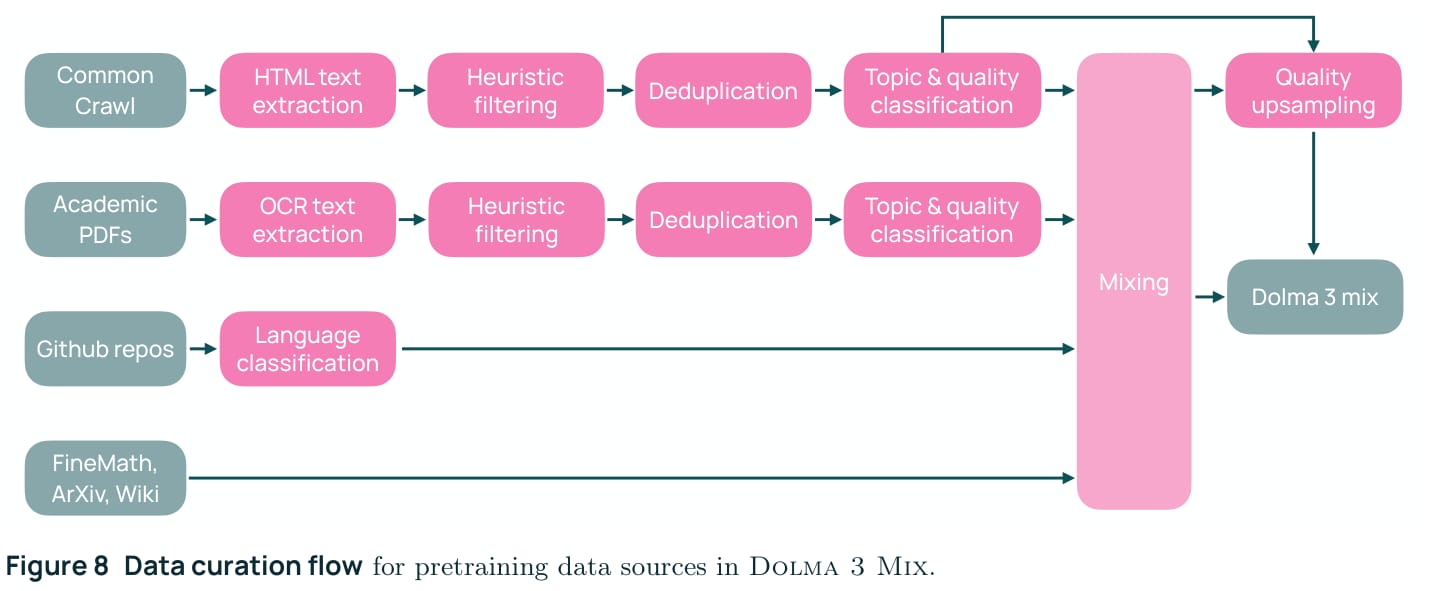
来源:Figure 8,PDF 第 14 页。
网页数据的三层去重
网页处理先提取语义文本,再过滤垃圾 URL、异常长度、符号过多、内部重复与不符合语言目标的文档。报告这条网页课程以英文为主要目标,因此语言筛选不能直接复制到你的中文或双语模型。
去重包含三个粒度。精确去重按文本 hash 去掉完全相同文档;近似去重用 MinHash 找到相似文档,再在簇内做 Jaccard 检查,并保留较新的抓取版本;子串去重处理整篇不同但包含重复模板的内容,例如页眉、页脚与通用填充文本。
子串阶段标记重复出现且至少 500 字节的片段,并保留至少一次出现,再合并需要删除的区间。它解决的是局部内容重复,不能仅靠整篇文档 hash 替代。大规模处理由 Duplodocus 等工具支持,实际执行还涉及分片与数据规模限制。
去重后再受控重复高质量文档有明确目的:先去掉由爬取频率和复制带来的偶然重复,再决定哪些资料值得分配更多训练 token。否则重复次数混入来源流行度、网站模板和采样偏差,很难解释训练配比。
科学 PDF、代码与数学来源
科学 PDF 使用 olmOCR 转成线性文本,经过语言、近似去重、文档类型相关的 PII 检查与质量过滤。文章区分公开科研署名与不适合公开传播的个人记录,判断需要考虑文档用途。提取错误也会影响公式、阅读顺序与训练质量,原 PDF 可用不代表提取文本可靠。
代码使用 Stack-Edu 并按编程语言分组;数学加入保留 LaTeX 的 arXiv 文本与 FineMath 高质量部分;百科来源提供补充知识。训练混合的主要 token 比例在表 4 中是网页约 76.1%、科学 PDF 13.6%、代码 6.89%、数学网页 2.56%、arXiv 0.86%,其他百科比例较小。这是该模型的研究配方,受目标、可用数据与测试约束共同影响。
Token-constrained mixing 的三个环节
作者训练许多 30M 参数代理模型,每个用 3B token、不同来源权重,采样权重来自围绕自然分布的 Dirichlet 分布。对每个代理模型用 Base Easy 测量,再为每个任务拟合权重到 BPB 的回归关系,最后搜索使平均预测 BPB 较低的混合。
混合需要遵守现实约束:总预算约 6T token,各来源可用容量有限,重复次数也受限制。因此数学或代码数据即使代理分数很好,也不能无限提高权重。这个约束使方案同时考虑能力目标与数据消耗。
当新来源到达或过滤方式改变时,conditional mixing 将已优化配比合成一个固定内部比例的虚拟来源,再与新来源进行低维搜索。它减少重新训练整个代理 swarm 的代价,也会限制搜索空间,因为旧来源内部比例被冻结。报告通过增量步骤整合网页、代码语言与较晚完成的 PDF 数据。
质量感知重复采样
网页先按 24 个主题分类,每个主题再分 20 个质量区间,共 480 个子集。主题权重决定分配多少 token,主题内部的质量曲线决定不同质量层重复多少次。
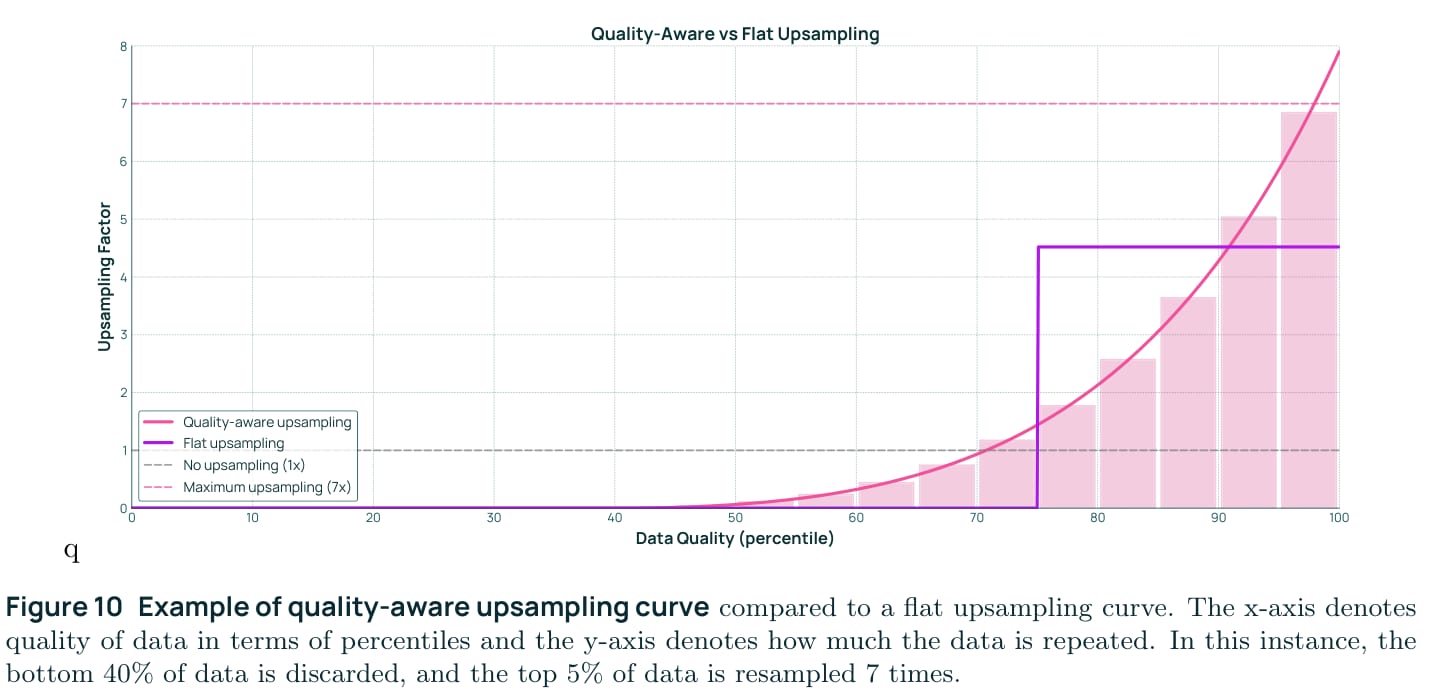
来源:Figure 10,PDF 第 20 页。图为曲线例子:底部部分丢弃,最高质量段重复更多,最大倍率为 7。
曲线的积分对应主题平均采样倍率,离散质量桶按区间积分获得自己的倍率。来源配比、总 token 预算与最大重复次数共同限制曲线。文章示例里的丢弃比例和高质量重复比例不应被当成每个主题统一阈值。
质量分类器由特定正负样本训练,它所偏好的教育或对话风格可能与实际任务不同。学习这套方法时,应同时检查分类误差、领域覆盖与留出任务,避免只用一个质量分数删除全部少见材料。
中训练:把数据质量转成目标能力
中训练在预训练检查点上继续进行,用约 100B token 集中补强能力。此时有价值的小来源、结构化任务和推理轨迹可以占据更大的有效比例,但需要保留高质量网页和 PDF,以控制分布变化。
Microanneal 与集成验证
作者的典型 microanneal 使用目标来源 5B token 加网页 5B token,进行短继续训练,再与只用网页的 10B 训练对照。它回答的是目标数据相对于同等继续训练能带来什么收益。小来源或特殊实验会使用其他比例,文章明确存在不同变体,不能把所有微实验都解释成完全相同协议。
单来源有效之后,再进入 100B 混合的完整集成试验,并对检查点做快速 SFT,验证底座收益是否能转化为后训练能力。这个额外步骤检查 post-trainability:一份数据让某个 Base 指标更好,不一定意味着最终助手更好。
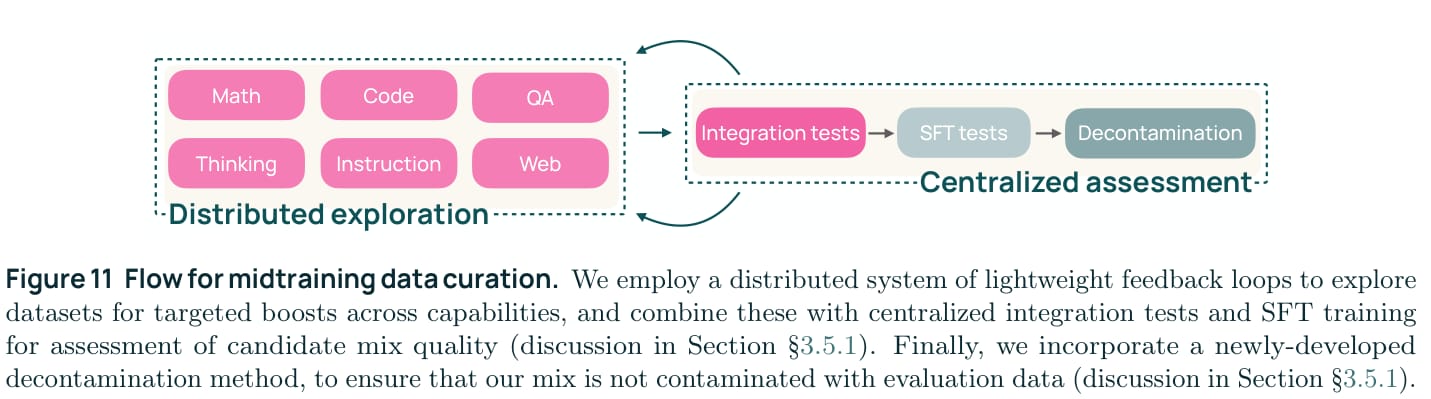
来源:Figure 11,PDF 第 21 页。各能力来源先做轻量探索,再统一进行混合、SFT 与去污染检查。
五轮开发中的代表混合,Base 平均分从 Round 1 的 49.7 到 Round 5 的 53.1,后续 SFT 试验平均从 35.2 到 37.3,见表 6。它描述数据课程开发进展,并非最终模型逐阶段分数。开发过程中预训练也在推进,且最后混合经过更新的去污染处理,不能将这些数字当作每项新来源的独立因果收益。
五类能力怎样构造数据
数学包括已有 Dolmino 数学数据、新生成的 TinyMATH、重写数学网页的 CraneMath 与 MegaMatt。TinyMATH 从已有题生成类似题,再生成代码解与讨论;网页重写保留数学内容并改善表达。有效生成还需要检查题目、答案、代码与格式,扩大文本数量不能替代正确性控制。
代码路线同时改善代码质量和 fill-in-the-middle。FIM 将程序拆成 prefix、middle、suffix,再训练模型恢复中间部分,帮助补全而非只能左到右续写。Stack-Edu 部分数据做 FIM 转换;CraneCode 对 Python 来源做语法、linter 检查,再分阶段重写风格与实现。改写代码需要重新检查行为,不能仅凭更整齐的文本认定数据更好。
QA 采用 Reddit-to-Flashcards、Wiki-to-RCQA 与选择后的 Nemotron QA。前者把学术相关讨论转成多种选择题格式,后者围绕段落生成阅读理解问答。作者发现某些合成子集不如自然文本,因此只保留经评价支持的来源。合成标签不是质量证明。
指令数据来自 Tulu3 与 Flan 等,用于给后训练建立基础。推理数据包括 meta-reasoning、program-verifiable 任务、完整推理链重写与已有轨迹。Meta-reasoning 将问题分类、难度、潜在错误、验证方法等信息纳入生成;program-verifiable 任务先生成,再用程序检查答案,过滤错误解。
这些来源服务于不同学习目标。答案正确、推理完整、代码可执行和问答与原段落一致,是不同检查。重复采样同一道题的不同 completion 也会让记录数大于独立题数,训练规模报告需要同时保留这一口径。
数据偏向与特殊 token 的实际代价
表 7 对比偏 QA 的混合与偏数学/代码/推理的混合,后者提高对应能力,却损失部分知识问答。最终混合选择较均衡方案。对领域模型可以主动接受这种取舍,但要在目标任务与通用回归上测量,而非默认所有分数都会同步提高。
作者在中训练阶段加入指令与思考数据时,保留普通换行形式,未直接套用后训练特殊 chat token。实验中,新引入特殊 token 会被 Base 模型输出,影响答案解析,导致某些分数大幅下降。原文将主要退化与格式和解析联系起来,不能把它解释成模型的数学知识完全消失。正式 SFT 再学习角色与工具格式,与中训练的目标不同。
去污染:检测后还要展开匹配
Decon 先按步长抽取 n-gram,快速查找基准匹配;发现匹配后向两侧展开,检查连续匹配强度,再判断是否移除文档。问题、答案与材料段落分别处理,短问题可借答案或段落提供支持,多选任务避免只按 A/B/C/D 标签匹配。
作者针对开发评价中的全部实际使用 split 清理。去污染会同时影响记忆和领域训练样本,分数变化因此不一定只反映抄答案。原文还发现,有些污染并未提升分数,格式不一致或能力未能利用答案都可能改变观察结果。检测到泄漏、泄漏影响评价与所有泄漏已被去除,是三个不同判断。
32B 的最终中训练检查点还平均了两个不同种子训练的权重,以改善部分指标。7B 初步实验没有同样收益,因此使用单次结果。模型 souping 需要共同初始化与合适训练路径,报告中的收益不能变成任意权重都可平均的规则。
长上下文扩展:结构、数据与训练样本共同改变
Olmo 3 从 8192 扩展到 65536 token。只修改模型卡中的窗口数字无法得到这种能力,报告同时调整位置编码、训练数据与序列组织。
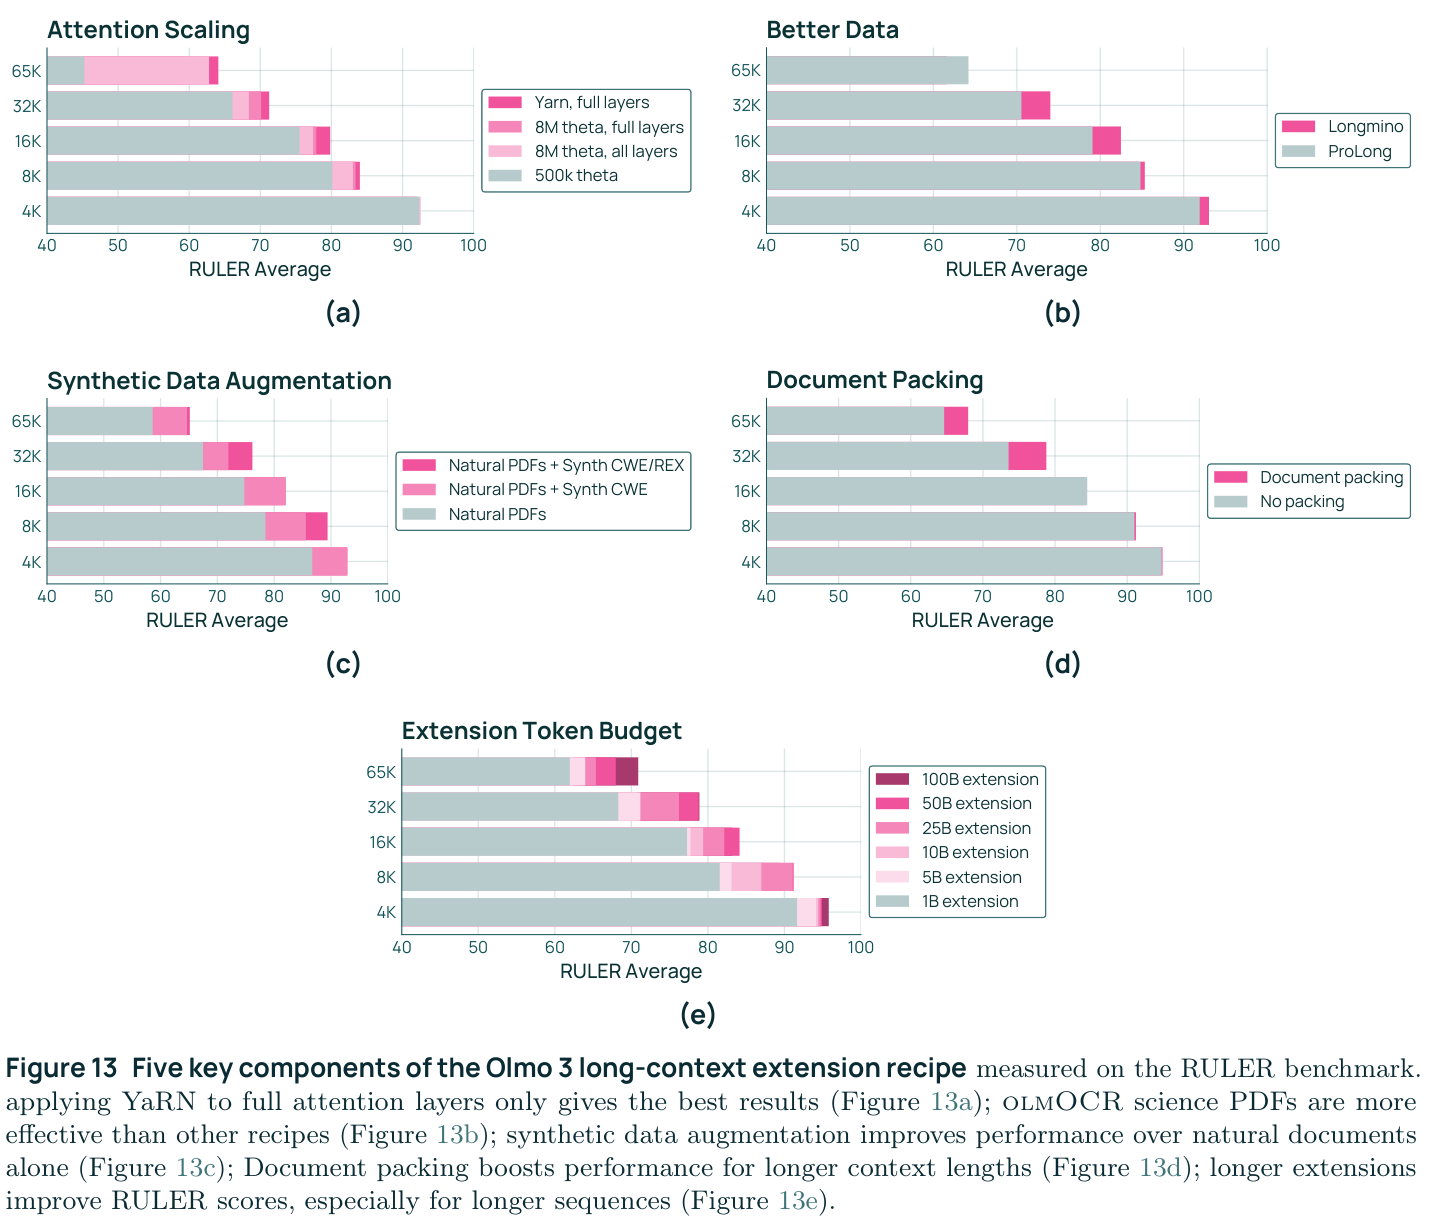
来源:Figure 13,PDF 第 32 页。五个面板分别比较位置缩放、数据、合成增强、文档 packing 与训练预算,纵轴为 RULER 汇总分数。
长文档与跨片段监督
科学 PDF 提供大量天然长文档。作者用 gzip 压缩性去掉两端各 20% 的极端样本,降低高度重复或异常文本影响;其他基于长程依赖的筛选在其实验中没有超过该方案,因此未进入最终训练。
自然长文档能提供长期依赖,却不一定包含信息提取和聚合的明确监督。论文把一部分 32K—64K 文档分成 8K—32K 的自然片段,提取 noun phrases、计算 tf-idf,选相关片段,再让模型生成任务。这样无需教师一次处理整篇超长输入,也能构造与远程内容相关的监督。
CWE 根据常见词生成要求统计出现次数的问答;REX 将相关信息重写成总结、课堂对话、判断题等多种形式。生成任务被注入文档的采样位置,给长序列增加聚合与抽取信号。生成内容仍需要忠于片段与计数,任务规模本身不保证没有噪声。
短长数据混合与位置缩放
最终长上下文配方约为 34% 长内容与 66% 中训练短内容。原文早期比较发现,长内容比重更高时短能力损失更明显。保留短数据使扩展后的模型仍能处理常见任务,同时增加长程训练。
YaRN 只应用于全注意力层,滑动窗口层保持原位置编码。局部层可访问范围没有随全局窗口同步扩大,统一改变所有层会改变它们原先的局部计算条件。作者的消融支持这一有区别的处理,但具体收益仍属于其结构与数据设置。
Packing、文档隔离与上下文并行
简单拼接后按固定长度切分,可能把长文档切成不适合学习依赖的片段。Best-fit packing 尽量少切文档,只增加少量 padding。文档内注意力掩码让位置只能访问同一原文档,防止无关文档间形成伪依赖。
8 路 context parallelism 将一个长序列的计算分给多设备,并使用能处理不规则掩码的注意力策略。数据 packing 改变有效文档长度,mask 改变可见内容,位置缩放改变位置表示,三项应一起记录。单独报告最大 sequence length 会遗漏这些条件。
RULER 用作开发指标,HELMET 用作较独立的长期任务评价,作者承认两者仍有部分重叠。32B 在 65K 上的 RULER 为 79.70、HELMET 为 43.15,见表 12;指标不同,不能相互替代。窗口支持 65K 不代表所有跨全文推理都接近满分。
Think SFT:先构造可学的完整推理轨迹
Think SFT 汇集数学、代码、指令、聊天、安全、科学等来源。既有完整轨迹可以保留,不完整轨迹由相应教师重新生成并再过滤。代码答案通过测试,精确指令由约束验证器检查,生成来源和许可也在筛选范围内。
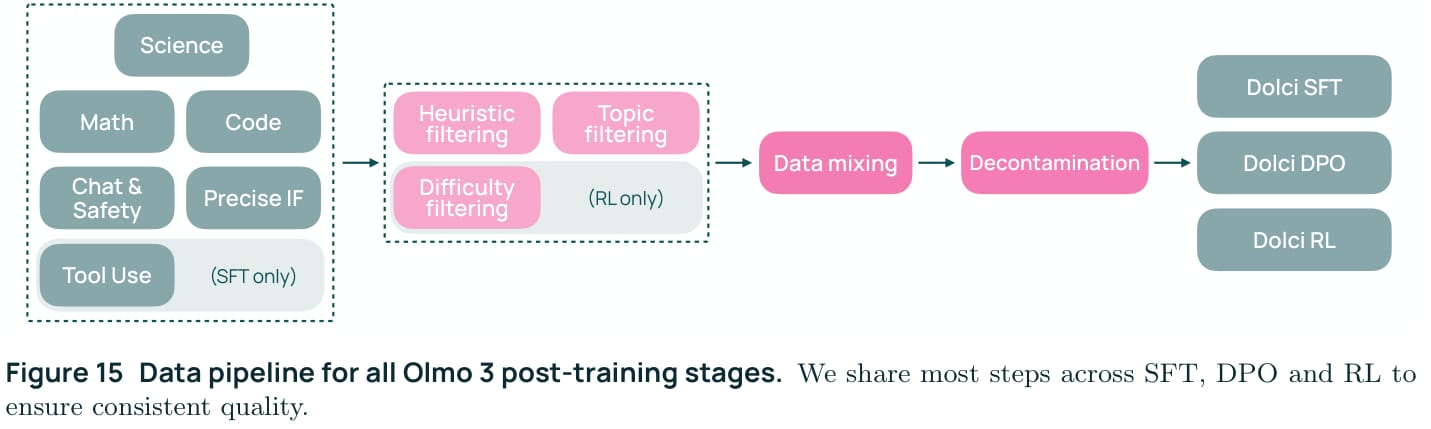
来源:Figure 15,PDF 第 39 页。SFT、DPO 和 RL 共用若干处理环节,但样本对象与额外过滤要求不同。
SFT 混合开发使用较小基础集,加上各类候选数据进行比较,再做集成。最终 Think SFT 记录约 226 万样本,其中部分题目有不同 completion 重复,不能解释成 226 万唯一任务。
去污染采用 8-gram 匹配与重叠阈值,并对常见模板、数学单字符片段等处理误匹配。格式、完整性、主题和模型身份过滤服务于作者的训练目标;中文模型不能直接复制其英文取向筛选,必须重新定义语言覆盖与任务分布。
训练使用两轮数据、32K 序列、token 计量 batch 与 packing,并进行学习率扫描。SFT 只学习标注序列的概率:模型尚未在真实环境中反复采样,根据自身错误获得奖励。之后的 DPO 与 RL 改变训练信号,负责不同能力。
Delta Learning:DPO 为什么与继续 SFT 不同
如果同一批新 completion 已经不适合继续模仿,可以通过与更弱结果比较提取相对能力信号。Think DPO 用 Qwen3-32B Thinking 生成 chosen,Qwen3-0.6B Thinking 生成 rejected,并保留有能力差异的配对。
表 21 的开发 7B 检查点原平均为 70.3,继续在 chosen 上做 SFT 后为 64.5,Delta Learning 后为 72.9。它支持相对对比能够提供不同于继续模仿的信号。不同任务也存在变化,不能把每项 chosen 都视为绝对正确,模型大小只提供配对启发,仍需关注样本质量。
附录 A.6 使用长度归一化 DPO。定义某条答案相对参考策略的平均 log ratio:
优化目标可写为:
x 是提示,y_c/y_r 是 chosen/rejected,参考策略为初始检查点,β 调节相对更新。除以答案长度会改变目标尺度,所以 β 与学习率要与该定义一起理解。论文 Think DPO 的 β=5 与极小学习率,不能直接抄到未归一化 DPO 实现。
作者训练一轮并扫描学习率与数据规模,7B 使用约 150K 偏好对,32B 使用约 200K。DPO 数据量是超参数,效果可能在某处达到最佳后下降。SFT+DPO 再做 RL 的整体收益在表 22 高于 SFT 直接做 RL,但该控制实验只有一次评价运行,并对起点相应过滤数据,需保留这一范围。
OlmoRL:样本、奖励和损失怎样连接
RL 阶段从当前模型采样答案,验证器给出奖励,再用组内相对表现更新权重。Think 使用数学、代码、精确指令与一般聊天的混合,约 100K prompts。各领域的奖励来源不同,不能全部称为确定性正确性检查。
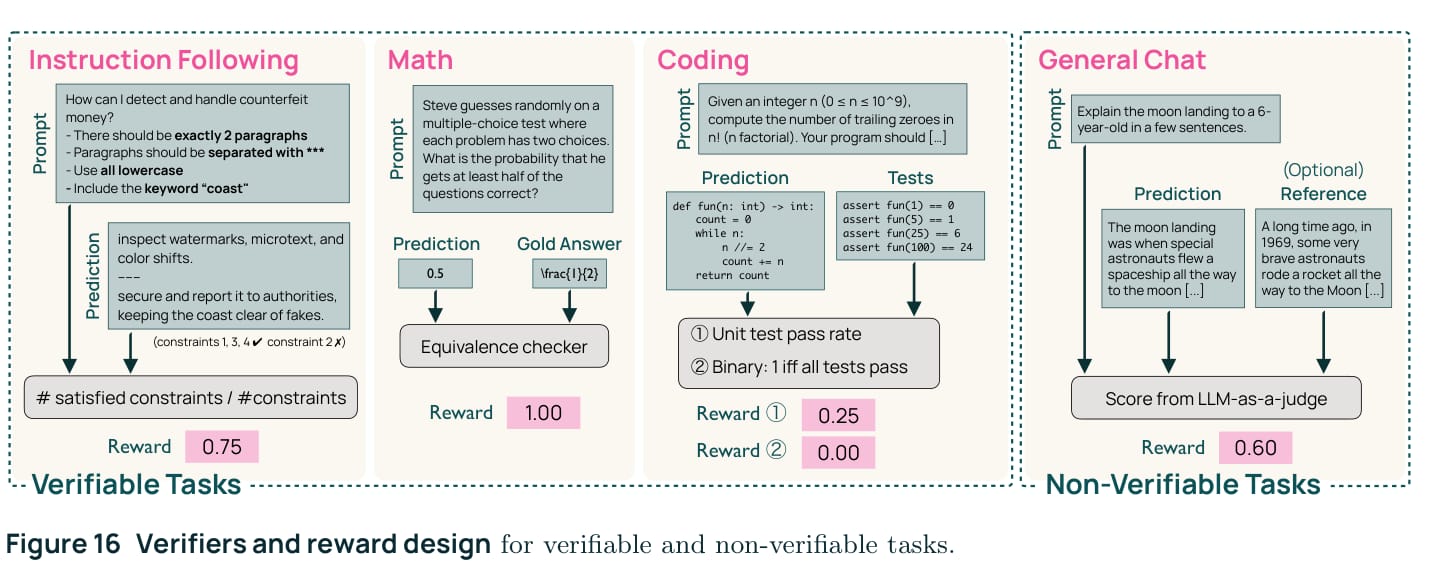
来源:Figure 16,PDF 第 44 页。图展示可验证与开放任务,以及二值或分项奖励的不同设计。
数学用答案归一化与 SymPy 等价检查;代码执行测试,比较通过比例与全部通过的二值奖励;精确指令逐项检查约束,正文描述的训练设置要求全部满足才给 1;开放聊天由模型裁判返回 [0,1],可以带参考答案,也可以没有参考。图中的部分满足示意要与具体运行配置区分。
代码训练数据需要题目与测试。作者对部分来源生成题目、参考解和测试,再执行验证;保留通过较高比例测试的参考解,并移除失败测试。这个流程可降低生成错误,也可能让题解与测试共享盲点,仍需独立代码评价,不能将生成测试全通过当作任意输入正确的证明。
7B Think 在训练前对每个提示采样 8 个结果,过滤太容易的题;32B 主要依赖在线 active sampling。过滤基于当前起点,不同底座难度不同。训练集过难时全部结果可能失败,同样缺少组内可区分信号。
从奖励到 advantage
对同一道题采样 G 条回答,使用:
论文没有再除以组内标准差,以减少标准差归一化带来的难度偏置。教学例子中,四条回答奖励为 [1,1,0,0],advantage 为 [0.5,0.5,-0.5,-0.5];若全部奖励相同,则这一项不产生区分信号。例子是算法说明,不是作者实测样本。
OlmoRL 过滤奖励全相同的组,然后持续采样补足有效 batch。它区别于一开始大量过采样再筛选的做法,可以利用异步队列按需获得有信号结果。有效训练 batch 稳定,并不意味着总生成成本固定,困难度变化仍会影响为凑足 batch 所需的 rollout 数。
重要性比率、clip 与 token 归一化
定义 r_i,t 为当前 learner 策略与旧 learner 策略在已采样 token 上的概率比;另有训练引擎旧策略与 vLLM 返回概率之间的修正权重:
ρ 为截断上限。这一项针对训练和推理引擎的概率差异,不能只将两套 log probability 默认视为完全一致。
目标的主要形式为:
总 token 数归一化让每个 token 参与统一尺度,避免先按每条答案平均而引入特定长度权重。上限 clip 稍高于下限,给某些概率增长更大空间。报告不使用单独 KL loss,保留策略比率裁剪与其他稳定措施。这些是完整训练配方里的相互配合,不能只删除 KL 就预期同样稳定。
这里将同一序列的末端 reward advantage 记为 A_i,论文写成逐 token 的 A_i,t;在该奖励计算下,同组轨迹的标量信号被用于其 token 更新。不同 token 的概率比仍不同,因此一次奖励会影响整条生成轨迹,但这类监督没有直接指出哪一步首次犯错。
异步基础设施:为什么 RL 经常被生成拖慢
Think 轨迹平均很长,最大生成到 32K。Learner 的一次参数更新相对快,actor 生成经常成为主要瓶颈。报告中的资源分配因此给推理分配更多节点,并详细测量等待时间。
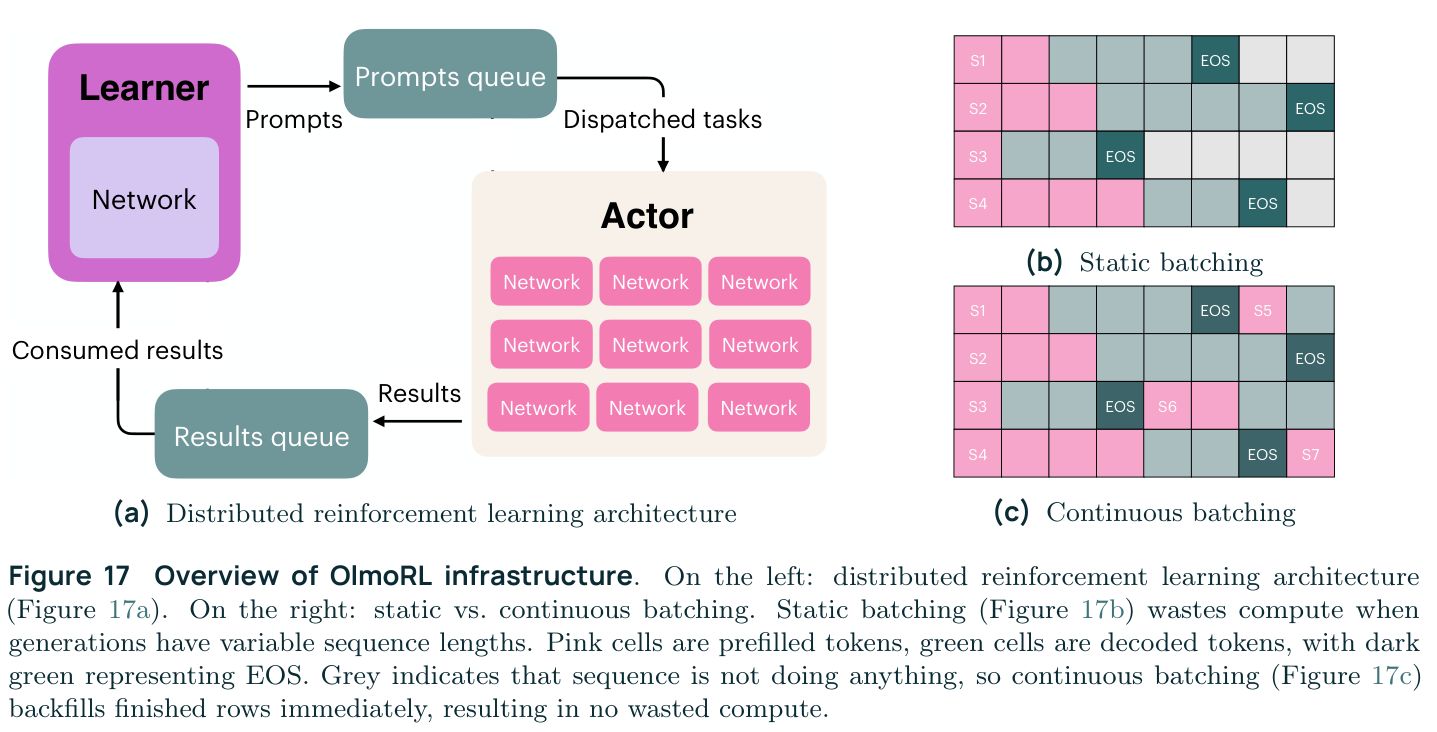
来源:Figure 17,PDF 第 49 页。左侧是 learner、actor 与队列;右侧比较静态与连续批处理。
Learner 将提示送进任务队列,多个 actor 使用独立 vLLM 执行,结果进入结果队列供 learner 更新。不同答案结束时间不同,静态 batch 中已结束位置会空等最长序列。Continuous batching 立即补入新生成,减少空闲槽位。
Active sampling 接在结果消费处,剔除无区分奖励组后继续拉取数据,保持训练所需有效数量。线程、CPU 处理与预取同样影响是否真的发挥连续批处理收益。作者报告初版 continuous batching 在补充预取线程前甚至比静态方式慢,说明接口选择本身不能保证吞吐。
Inflight updates 在生成仍进行时更新 actor 权重,并保留缓存,减少等待与停机。它引入复杂的策略一致性问题,需要与异步训练、概率记录和修正一起理解。报告测得效率收益并未损害所测准确性,不能保证所有模型与任务都无误差;自己的系统应检查更新版本、采样概率和质量变化。
表 23 的两小时、两个 8×A100 节点测量中,逐步改进后的 tokens/second 从 881 到 2949,其中 inflight updates 是重要增量。这是特定基准条件的结果,生产 RL 还受 reward 执行、数据队列和各域轨迹长度影响。优化矩阵反向速度前,应先测是训练、生成、验证还是同步在等待。
多阶段结果需要逐项看
下面保留报告内清晰的阶段对照,均为作者评价,本文未复现。
Olmo 3 Base 7B 阶段 | Math 能力簇 | Code 能力簇 | GenQA |
|---|---|---|---|
Pretraining | 23.5 | 19.8 | 68.5 |
Midtraining | 59.8 | 31.9 | 71.3 |
Long-context extension | 54.4 | 30.6 | 72.5 |
来源:Table 13。中训练显著改善目标簇,扩展长上下文后部分短任务分数下降。这说明课程存在取舍,最后阶段不保证所有数字继续上涨。
Olmo 3 Think 7B 阶段 | AIME 2025 | LiveCodeBench v3 | IFEval | GPQA |
|---|---|---|---|---|
SFT | 57.6 | 67.8 | 77.9 | 45.8 |
DPO | 62.7 | 75.1 | 75.9 | 48.6 |
最终 Think(含 RL) | 64.6 | 75.2 | 88.2 | 46.2 |
来源:Table 15,评价统一设置并报告三次运行均值。DPO 没有提高每项指标,RL 也没有保持所有 DPO 峰值。AIME 等使用相应重复采样评价口径,不能把所有列都解释为相同的单次准确率。
32B 的 3.1 Think 是在初始 3.0 RL 后继续训练得到,报告提到从 750 到 2300 步,改善数学、推理与精确指令,但 AlpacaEval 有所下降。模型版本、训练预算和能力方向一起变化,比较时应避免把 3.0 与 3.1 混成同一检查点。
Instruct:工具行为与直接回答怎样训练
Instruct 从 Think SFT 起步,再训练不包含显式思考轨迹的回答,获得能力 warm-start,同时维持更直接的输出。表 29 在开发 7B 检查点上比较,有 Think SFT 起点的平均为 47.8,无该起点为 44.5;输出长度没有因此明显增长。这是研究配方的实证,不能推导为每个领域都必须先训练长推理模型。
真实工具与模拟工具轨迹
真实轨迹通过科学文献 MCP 工具与搜索/浏览生成,能覆盖实际环境返回与多步互动;SimFC 使用不同 API 和工具集生成模拟用户、工具响应与助手消息,扩大函数多样性。Table 27 中真实轨迹覆盖的函数较少,多步比例较高;模拟轨迹约 200K、42.6K 种函数,覆盖面大但多步复杂度不同。
Multi-turn 指多个用户轮次,multi-step 指一个请求内多次环境交互。统计上不能混写。模拟多轮容易,不代表已经覆盖真实工具失败与状态改变,真实轨迹与模拟轨迹因此承担互补作用。
作者统一 OpenAPI 工具定义、调用格式、assistant/environment 角色与特殊标记,避免不同来源格式相互冲突。BFCLv3 检查函数选择与参数,LitQA2/SimpleQA 的 MCP Agent 检查实际任务完成。前者是接口能力,后者还依赖检索内容与运行框架。
工具效果并不恒为正。Table 31 中,Olmo 3 Instruct 7B 在 LitQA2 从无工具的 24.4 到 ASC 工具的 38.2,在 SimpleQA 从 3.3 到搜索/浏览工具的 79.2;另一些模型在文献任务上接入工具后下降。相关测试是特定子集、最多 10 轮并重复三次,不能将工具本身当作无条件加分。
多轮偏好与长度偏置
Instruct DPO 组合两类信号:强弱模型的启发式配对,以及经过改造的模型裁判配对。只升级所有生成器可能让 chosen/rejected 都很好,反而缺少有意义差异;加入弱候选、选择更差 rejected 后,作者观察到更有效的对比信号。
多轮偏好保持此前轮次相同,只让最后一轮回答不同,以降低“哪一轮更好”的歧义。历史对话由 self-talk 或 synthetic-context 生成,再比较末轮结果。
偏好数据常把长答案与高质量关联,导致模型同时学习不必要长度。作者对 chat 与 multi-turn 子集限制 chosen/rejected 长度差到 100 token,并扫描数据量、学习率与长度过滤设置。此设计面向直接交互,不能推导为复杂阅读博客应省略方法信息。
Instruct RL 使用相对容易的数学/代码与通用任务,不完全沿用 Think 的困难度过滤;最大回答长度在相应 7B/32B 配方为 8K/16K。选择模型时同时看分数、长度与质性案例。作者把简洁与 RL 后表现的联系作为实验观察和解释,未证明越短一定越聪明。
RL-Zero:用公开底座研究奖励学习
RL-Zero 跳过对应后训练阶段,从 Base 出发训练数学、代码、精确指令、通用聊天与混合任务。开放预训练与中训练来源,使研究者能够更明确地检查 RL 是否在利用已有训练内容。
数学提示经过聚类、去重与去污染,再过滤底座 8 次全解出的简单题,形成约 13.3K prompts。训练使用简洁任务模板,减少底座不熟悉的 <think> 等格式;评价也清理特殊格式以匹配。模板变化会影响分数,不能都归入算法能力。
报告将训练生成长度设为 16K、评价为 32K,并使用温度 1.0 观察 pass@k。该版本的训练长度与截断处理变化在附录解释,读者需要按 3.0/3.1 配方区分。
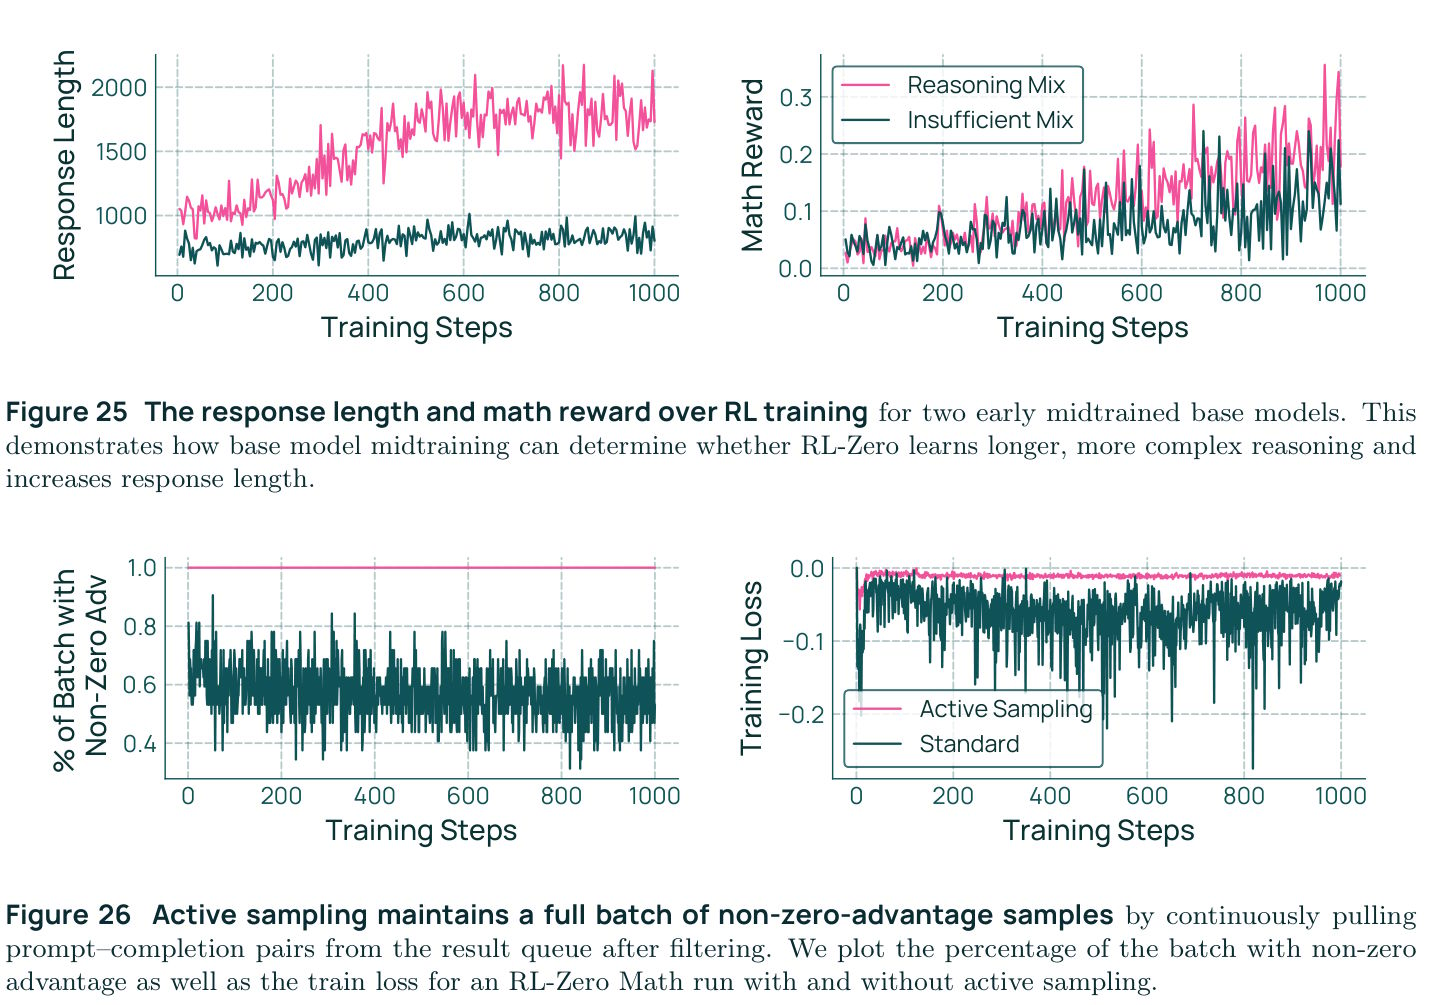
来源:Figures 25—26,PDF 第 65 页。上方比较不同中训练起点的奖励和长度,下方比较 active sampling 的有效 batch 与损失变化。
不同中训练数据决定了后续 RL 是否容易形成有效推理行为。底座缺少相关基础时,奖励与长度可能停滞。Active sampling 则保持非零 advantage 的有效样本比例,使训练损失更稳定。较长推理轨迹是行为证据之一,仍需要答案和留出任务检查,不能单独作为能力指标。
作者还训练随机二值奖励作负对照,未观察到相关评价收益,见 Figure 27。它提供与去污染成功一致的证据,无法单独证明所有可能泄漏都不存在。随机奖励、有效奖励和任务相关评价之间的关系,需要和源数据检查共同判断。
从一条代码题追踪训练信号
下面是依据训练流程整理的教学例子,未实际生成训练样本或运行实验。任务是根据前后程序片段补全一个函数,并在指定输入上返回正确结果。
预训练阶段,模型从自然代码中学习语法、库调用和常见结构。中训练的 FIM 样本把函数体中间部分移走,让模型根据 prefix/suffix 恢复,针对补全能力提供监督。加入经验证的代码解与推理轨迹,可以为后续解释和排错建立基础。
Think SFT 提供完整的题目、解题过程与函数实现,并运行测试筛掉部分错误样本。DPO 对同一提示构造能力差异明显的两个结果,优化相对偏好,不要求新 chosen 比原有所有数据都强。
RL 阶段由学生模型自己生成多个实现,测试得到奖励。组内有正确与错误时,advantage 产生区分;若全部相同,active sampling 继续寻找有信号题组。测试仍应覆盖关键行为,避免模型只学会碰巧通过少数示例。
Instruct 路线进一步学习如何以用户需要的格式输出,何时调用工具、怎样处理结果,以及怎样省去不必要的显式推理。最后在独立代码与 Agent 任务上检查功能、调用格式、恢复行为和成本。每阶段的样本与损失不同,不能用“多喂一点高质量数据”概括全部设计。
对自己的训练,哪些方法可以先迁移
你可以先迁移评价与实验设计:把目标能力拆成任务簇,保留独立测试,选择小规模能显示信号的指标;使用相同起点和 token 预算比较数据;对候选混合做后训练检查,而非只看 Base 损失。
数据侧可以学习分粒度去重、记录来源、受控重复与分阶段课程。领域任务应重新定义语言和质量目标,不能照抄英文比例与筛选器。合成数据应明确教师、生成格式、验证方式和重复口径。
微调侧可以分别比较 SFT、对比偏好和奖励学习,确认新数据到底提供哪种信号。奖励应具有任务依据,监测组内分布与有效样本;同时测通用回归、长度和工具任务。多域混合在报告中能降低部分过度优化,但不能保证所有领域同时达到单域最优。
资源侧先区分训练、生成、验证与同步耗时。报告的初始 32B Think 配方在专用 1024 H100 集群约经历 56 天,含实际运行与相关选模;3.1 的后续训练还额外使用了约 21 天、224 GPU。作者按历史假设价格给出的金额不包含全部研发探索,不能作为你的训练预算承诺。
完整开放路径让这些决策可检查,不代表小规模项目需要照搬整个大集群。可以选择中间检查点和对应数据来源,针对一个有明确评价的能力做小规模对照,再决定扩大数据、改变课程还是改进后训练。
来源与复读索引
Olmo 3 v2:§2 全流程;§3.2—3.4 架构、评价、数据处理与混合;§3.5 中训练与去污染;§3.6 长上下文。
§4 Think 的 SFT、Delta Learning 与 OlmoRL;§5 Instruct 的真实/模拟工具轨迹、多轮偏好与长度控制;§6 RL-Zero 与随机奖励对照。
Appendix A.1 与 Tables 33—35:结构、并行、训练参数;A.5:去污染细节;A.6 与 Tables 47—49:SFT、长度归一化 DPO 与 RL 配置。
数据配方、OLMo-core、Open Instruct、评价 OLMES、去污染 decon。本文依据公开报告解释,未训练或复现该模型。