You Only Edit Once: Incentivizing In-Context Capability of LLMs via Local Demonstration Refinement 论文阅读
摘要
解读 Jev-LDE 如何用 1.7B 编辑器对检索示例执行一次 Keep、Delete 或 Replace,展开可验证奖励、GRPO 训练、分类迁移与运行成本,并核对数学推理退化及复现细节。
Few-shot 上下文学习通常先检索几条示例,再让大模型参考示例回答问题。检索器擅长找相似内容,但相似度并不能直接衡量一条示例能否帮助当前模型判断。重新搜索所有示例组合又需要大量计算,使用目标模型逐组打分时尤其昂贵。
清华大学自动化系的这篇论文将优化范围限制在检索结果附近:保留整个集合、删除一条示例,或替换一条示例。作者用 Qwen3-1.7B 训练编辑器 Jev-LDE,由冻结的目标模型提供答题正确与否的奖励。部署时,编辑器只生成一次动作,目标模型随后预测一次。
论文最有说服力的证据来自分类任务。在三个分类数据集和四个目标模型上,平均 one-shot 准确率由 81.2% 提高至 88.1%,增加 6.9 个百分点。数学推理的收益较弱,部分设置还出现下降。理解这项工作,需要同时看清单次编辑的约束、训练阶段的反馈成本,以及结果适用的任务范围。
论文信息与整体方案
项目 | 信息 |
|---|---|
正式题目 | You Only Edit Once: Incentivizing In-Context Capability of LLMs via Local Demonstration Refinement |
作者与机构 | Jiarong Wen、Qi Wang 等,清华大学自动化系,前两位作者为共同第一作者 |
发表状态 | arXiv 预印本,未核验到正式会议或期刊录用信息 |
阅读版本 | arXiv:2609.33609v2,首次提交于 2026-09-27,v2 修订于 2026-10-10 |
原始资料 | |
编辑器 | 以 Qwen3-1.7B 初始化,用可验证奖励做强化学习后训练 |
目标模型 | 训练反馈仅来自冻结的 Meta-Llama-3-8B-Instruct;评测另包含 Qwen 和 DeepSeek 模型 |
核心约束 | 每个 query 最多一次示例成员编辑,测试时不枚举候选上下文反复调用目标模型 |
代码与权重 | 截至 2026-10-16,作者主页仍标注代码待发布,未确认可下载的官方 Jev-LDE 权重 |
阅读前提 | 理解 few-shot 提示、语义检索,以及强化学习中策略、奖励和优势的含义 |
先看原论文图 3。左侧是检索结果,中间是编辑器,右侧是完成任务的目标模型。
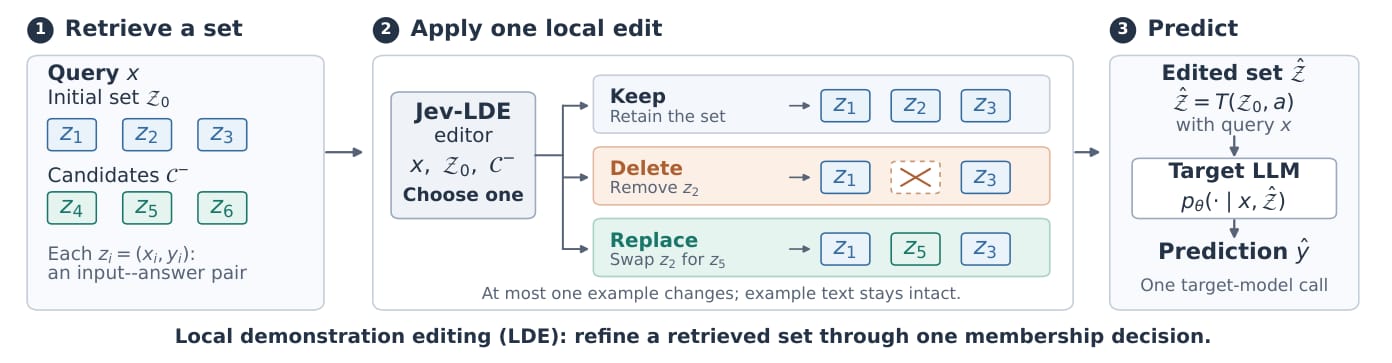
来源:论文 v2,图 3,第 4 页。
检索器提供当前示例和可替换候选。Jev-LDE 读完这些内容后输出一个动作,由程序修改示例集合,再将结果交给目标模型。修改对象是示例集合的成员关系,示例正文和标签保持原样。 论文没有把指令改写、多轮搜索或重新生成示例加入这个动作空间。
这里的 System 1 是对轻量决策角色的描述。Jev-LDE 仍通过语言模型生成结构化动作,不能据此推断它采用了零输出 token 的概率分类接口,也不能和 TypeSafe 的同名 Jev 产品混为一谈。
一、为什么检索到的示例还需要编辑
上下文学习,In-Context Learning,简称 ICL,是在推理输入中提供任务示范,让冻结模型依据这些示范完成新问题。一个 demonstration 通常包含输入和正确答案,分类任务中就是文本与标签。
检索可以解决候选太多的问题。Semantic TopK 按向量相似度取前 k 条,BM25 更侧重词项匹配。它们容易找到内容接近的文本,但当前任务也可能需要相同的判断规则、标签边界或答案格式。
以问题分类为例,问句“上海有多少人口?”的任务是识别数量类问题。提到上海的地点、人物或城市介绍都很相似,却未必展示数量类问题该怎么判断。一条讨论其他城市人口的示例,反而可能更有帮助。
问题还存在于示例组合。单独看来合理的两条示例,放在一起可能内容重复,也可能共同强化错误的标签线索。因此,给每条候选独立打一个相关性分数,无法完整刻画它在当前上下文中的作用。
直接优化组合的代价很高。从 n 个候选中选 k 个,有 种集合。理想目标可以写成:
x 是当前问题,y 是正确答案,Z 是示例集合, 是目标模型。测试时不知道 y,这个目标本身就无法直接计算。即使另找代理评分函数,逐组调用目标模型也会增加推理开销。
LDE 保留检索器已经完成的工作,将问题缩小为:当前集合附近有没有值得执行的一次编辑?
Oracle 实验只证明附近存在可改善空间
作者先在 TREC 的 4-shot 设置下检查单次编辑。在允许使用测试标签挑选动作的 Oracle 实验中,Llama-3-8B 与 Qwen2.5-7B 分别比 Semantic TopK 高 26.0 和 16.8 个百分点。Jev-LDE 在不使用测试标签时,对应提升为 8.2 和 7.4 个百分点。
Oracle 是带答案的事后选择,用来估计局部可修复空间,不是可部署的选例器。随机编辑没有取得同样收益,还会造成明显退化。局部空间中存在好动作,与实际学会识别好动作,是两个需要分别验证的问题。依据:第 2.2 节、图 2。
二、单次编辑的输入、动作和输出
1. 从完整示例库构造局部候选
论文默认用归一化的 BAAI/bge-base-en-v1.5 向量计算余弦相似度。检索面对的是某个数据集训练划分中的完整示例库,编辑器看到的是其中较小的工作集合。
对一个 query,流程是:
从完整示例库检索前 N 条,组成候选集合 C,主实验默认 N=16。
前 k 条形成初始示例集合 ,主实验 k 取 1、2、3、4。
其余 条形成替换集合 。
将任务说明、query、当前示例和替换候选一起交给编辑器。
候选中的标签来自训练示例。当前 query 的正确答案不会交给测试时的编辑器。训练时虽然保存了正确答案,它只用于计算目标模型的反馈奖励。
2. 三类动作限定了改动范围
动作 | 输入标识 | 对集合的影响 |
|---|---|---|
Keep | 不需要示例 ID | 保留原集合 |
Delete | 当前示例 ID | 删除一条,数量变成 k−1 |
Replace | 当前示例 ID、候选 ID | 用一条候选替换原位置,数量仍为 k |
编辑器没有 Add 动作,也不能从候选池之外临时搜索一条新示例。Replace 不重写原文本,只交换集合中的一个成员。
对包含 N 条候选、其中 k 条已经入选的设置,动作数为:
其中 1 对应 Keep,k 对应 Delete, 对应所有合法替换。N=16、k=4 时共有 53 个动作。若允许在同一候选池内重新选择任意 4 条或 3 条,则有 个集合。
53 仍然需要选择策略。论文训练编辑器的目的,就是将这种选择能力放到参数中,减少测试阶段的显式搜索。
3. 编辑器输出结构化动作
原论文图 4 展示了输入与输出的对应关系。
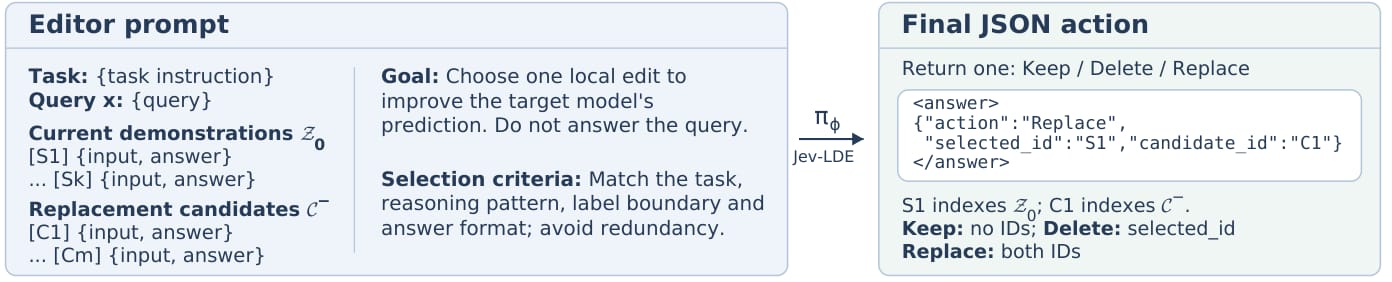
来源:论文 v2,图 4,第 5 页。
提示会要求编辑器关注任务类型、推理模式、标签边界和答案格式,同时避免重复、无关或容易误导的示例。当前示例用 S1 等 ID 编号,候选用 C1 等 ID 编号。
替换动作的输出形式如下:
正式模板将最终 JSON 放在 <answer> 标签中,可以在 <think> 标签中输出推理过程,奖励解析器只读取最终动作。这里的“一次”指一次编辑决策与执行,不等于语言模型只做一次前向计算,也不保证只生成一个 token。
原文规定无效输出在训练中获得零奖励,在评测中保留原始集合。复现时应把 JSON、合法动作与 ID 校验独立记录,避免将格式错误误认为有效的 Keep 决策。
4. 用一个教学例子走完整条路径
下面的示例按论文机制整理,未实际运行 Jev-LDE,也不是作者的实验记录。
任务:把“上海有多少人口?”归到问题类别。标签包括 LOC、HUM、DESC、NUM 等。
初始 3 条示例:
S1:上海位于哪里?→LOCS2:上海以什么著称?→DESCS3:上海的市长是谁?→HUM
替换候选中包含:
C1:重庆有多少居民?→NUMC2:江苏的省会在哪里?→LOCC3:浦东新区是什么?→DESC
一次可能有帮助的动作是 Replace(S1,C1)。编辑后,目标模型看见 C1、S2、S3 和当前 query,再输出分类标签。教学中的预期答案是 NUM。
这条替换引入了数量判断的示范。编辑器无需给出上海人口的真实数值,它的工作是判断哪些带标签的例子更适合当前分类问题。修改后的三个示例中仍保留原有两个成员,没有展开第二轮编辑。
三、编辑器如何从正确性反馈中学习
1. 目标模型冻结,只更新编辑器
Jev-LDE 从 Qwen3-1.7B 初始化。后训练中,Meta-Llama-3-8B-Instruct 始终冻结,负责对编辑后的上下文进行预测,并与已知训练答案比较。
因此系统有两组职责不同的参数:编辑器参数 被优化,目标模型参数 不更新。目标模型可以被视为提供任务结果的黑盒,梯度不需要穿过它传播到编辑器。
2. 先构造确实需要做决策的训练状态
训练 query 和候选示例来自 AGNews、TREC、DBPedia、GSM8K 的训练划分。检索前排除 query 自身,避免把题目连同答案当成示例检索回来。Banking77、SST-2、AQuA-RAT、TACRED 不参与编辑器后训练。
构造状态时,k 取 {1,2,4,8,10},候选总数为 16。每个数据集、shot 预算和采集轮次最多收集 1000 个状态,共进行三轮采集,按数据集、划分、query ID、k 和候选池大小去重。编辑器输入中的每条示例和 query 最多保留 1000 个字符。
接着进行奖励变化过滤。对一个状态,作者以最多八个合法动作进行探测:一个 Keep、最多两个不同 Delete、最多五个不同 Replace。每个动作应用一次后,交给冻结目标模型检查。
只有探测中同时出现成功和失败的状态才保留。如果所有探测动作都正确,或全部错误,这组反馈无法告诉组相对优化应偏向哪个动作。过滤提供的是有区分度的学习场景,没有直接指定唯一的最佳动作。
探测只覆盖部分动作,因此不能把“全部探测失败”解释为整个局部空间无解。过滤也需要目标模型调用,这部分成本发生在训练准备阶段。依据:附录 B。
3. 奖励直接检查编辑后的答案
对于训练样本 ,编辑器采样动作 ,得到编辑集合:
目标模型对该上下文预测 ,奖励为:
答对为 1,答错为 0,无效动作也为 0。分类比较会先规范化标签,数学任务使用各自的答案提取与匹配规则。
奖励没有要求动作必须优于原始集合。只要 Keep 后答对,Keep 也能拿到正奖励。它也没有额外奖励“看起来更合理”的推理文字。优化目标围绕下游答案,允许不同编辑获得相同正反馈。
4. GRPO 比较同一状态下的多次尝试
正式后训练对每个状态采样 G=8 个 completion。每个 completion 独立给出一次动作,由目标模型分别提供奖励。这里的八次采样与前面的八动作过滤是两个阶段,不能合并为测试时的八次搜索。
GRPO,即 Group Relative Policy Optimization,用同一组奖励计算均值和标准差:
是相对优势,、 分别是这组奖励的均值与标准差,小的正数 保持分母稳定。
例如,一组教学奖励为 [1,0,1,1,0,0,1,0],均值为 0.5。成功动作获得正优势,失败动作获得负优势,训练会提高前者的输出概率。多个成功动作都可以保留,符合这项任务没有唯一正确编辑标签的特点。
更新时,GRPO 还会比较当前策略与采样旧策略的 token 概率比,通过裁剪限制单步变化。论文按每条 completion 的 token 均值、再按序列取均值聚合损失,避免单纯因为动作说明更长就得到更大权重。最终更新的仍然是编辑器。
5. 影响复现的后训练配置
配置 | 论文设置 |
|---|---|
编辑器 / 反馈模型 | Qwen3-1.7B / 冻结的 Meta-Llama-3-8B-Instruct |
每状态 rollout | 8 个 completion,温度 1.0,top-p=1.0 |
反馈模型解码 | 温度 0,top-p=1.0 |
训练轮次与更新 | 1 epoch,752 次更新,使用最终 checkpoint |
学习率 / weight decay |
|
prompt / generation batch |
|
输入 / 输出长度上限 |
|
概率比裁剪边界 | 下边距 0.20,上边距 0.28 |
梯度裁剪 | 1.0 |
KL 与熵项 | KL reward、actor KL loss 均关闭,熵系数为 0 |
GPU 数量 | 2,表中未给出可用于通用成本推算的完整硬件条件 |
来源:附录 B、表 4。作者报告前 100 次更新的平均二元奖励为 0.475,后 100 次为 0.713。这是训练过程中已过滤状态上的反馈,不能当作未知测试任务的准确率。
四、推理时怎样接入已有系统
训练结束后,调用顺序固定:
检索初始示例与候选。
用编辑器生成一次 completion,解析为一个动作。
程序执行至多一次成员编辑。
目标模型依据新上下文输出一次答案。
评测中编辑器和目标模型都使用温度 0。编辑器不会先询问目标模型“换成这一条是否更好”,也不会用当前测试题的标签筛选动作。
下面是依据论文整理的教学伪代码,接口名用于说明数据流,未作为官方实现运行:
这份伪代码展示严格校验的集成方式。论文原始评测对无效输出采取保留原集合的策略,严格复现其数字时需要遵守并单独统计该处理规则。
“无需重新训练”指的是已经完成后训练的编辑器在迁移评测中继续使用同一 checkpoint,目标模型也保持冻结。建立 Jev-LDE 的过程本身包含强化学习训练和大量目标模型反馈调用。
五、主要结果支持了什么
1. 分类收益集中在有限示例预算下
主实验包含 TREC 问题分类、DBPedia 主题分类和 Banking77 意图分类,四个目标模型分别评测 1、2、3、4-shot,共 48 种配置。
下表仅摘出 one-shot 比较,数值为准确率百分比,每格按“Semantic TopK → Jev-LDE”排列。
目标模型 | TREC | DBPedia | Banking77 |
|---|---|---|---|
Qwen2.5-7B-Instruct | 65.4 → 80.6 | 89.7 → 94.8 | 88.6 → 88.4 |
Meta-Llama-3-8B-Instruct | 52.8 → 65.6 | 86.1 → 93.0 | 91.1 → 91.6 |
Qwen3-8B | 67.0 → 81.4 | 90.0 → 95.3 | 89.8 → 90.3 |
Qwen3.5-9B | 72.0 → 87.8 | 90.3 → 96.3 | 91.2 → 91.5 |
来源:表 1。十二个 one-shot 配置的平均准确率约为 81.2% → 88.1%。该平均值跨模型和数据集计算,不是某个单独任务的分数。
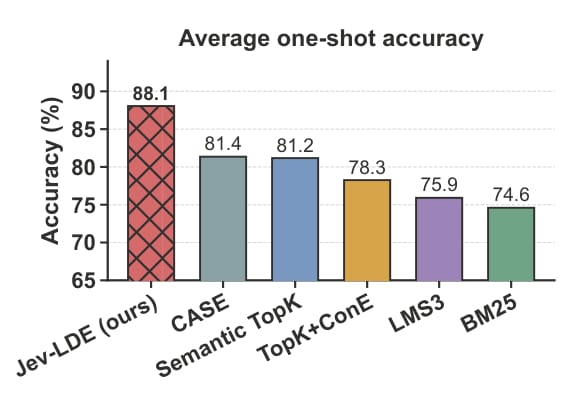
来源:论文 v2,图 1,第 1 页。
完整主实验中,Jev-LDE 在 46/48 个配置上超过自身的 Semantic TopK 初始化,在 44/48 个配置取得最好或并列最好结果。上表同时保留了 Qwen2.5 的 Banking77 小幅下降,避免用整体均值遮住反例。
附录 E 又测试了 8-shot、16-shot,将候选总数改为 30。在 24 个配置中,18 个提升、1 个持平、5 个下降,下降幅度为 0.03–0.39 个百分点。这个扩展同时改变了 shot 预算和候选池大小,不能直接当作“仅改变 k”的消融。
2. 有迁移证据,但任务距离不同
编辑器训练反馈只来自 Llama-3-8B。换成三个 Qwen 目标后,36 个主分类配置中有 35 个改善。Banking77 没参与后训练,16 个配置中有 14 个改善;SST-2 的展示设置全部改善。
DeepSeek-V4-Flash 的补充实验包含 TACRED 关系分类和 TREC-50 细粒度问题分类,提升分别为 0.3–2.2 和 2.4–4.4 个百分点。TREC-50 与 TREC 共享问题和训练划分,应视为近域标签细化,不能和全新任务分布等同。
作者推测,编辑器学到的任务匹配、冗余判断与标签区分具有一定复用性。论文没有把这些因素逐个隔离,因此这是一种解释,尚不能确定具体收益分别来自哪项能力。
3. 数学任务给出了清楚的边界
GSM8K 上,跨 1–4-shot 的平均变化为 Qwen2.5 的 −0.1 个百分点、Llama-3 的 +0.7 个百分点。AQuA-RAT 上,对应平均变化为 −0.8 和 −1.9 个百分点。
这些结果支持分类场景下的局部上下文修复,尚不足以支持数学推理、代码生成或开放式生成任务也能获得类似收益。多给推理预算是否更好,是作者提出的可能解释,没有在这组实验中通过严格对照完成验证。依据:第 4.1 节与附录 D 表 5。
六、消融、运行成本与理论边界
1. 训练后的编辑策略具有实际作用
图 7 左侧使用同一 one-shot TREC 设置,目标模型固定为 Llama-3-8B:
保留原示例:52.8%。
未后训练的 Qwen3-1.7B 编辑器:31.2%。
直接提示 Llama-3-8B 选择动作:57.8%。
后训练的 Jev-LDE:65.6%。
随机局部动作:23.2%。
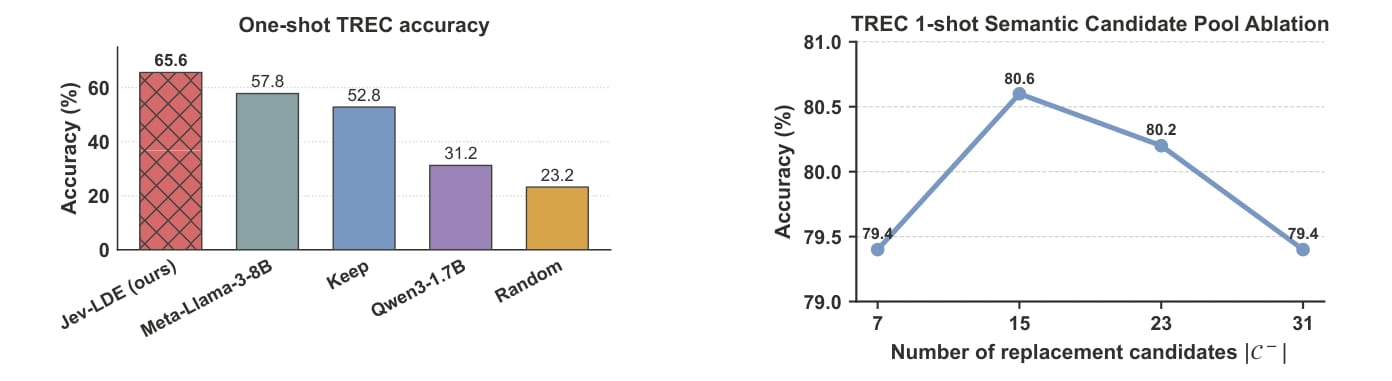
来源:论文 v2,图 7,第 9 页。左图的模型名指编辑器,目标模型相同;右图的目标模型换成 Qwen2.5-7B。
未训练的小模型比 Keep 明显更差。把论文提示直接交给一个通用小模型,并不能保证获得 Jev-LDE 的收益。后训练组比直接提示的大编辑器高 7.8 个百分点,支持在这组设置中学习决策策略具有价值。
这里还存在一项需要复现核对的细节:正文第 4.2 节的 one-shot 讨论称 Delete 被排除,而附录 A 对随机策略明确列出包含 Delete 的 17 个动作。两处表述不一致。随机动作还会将空上下文引入比较,应在官方代码发布后核对实际实现;目前不能擅自统一两处定义。
2. 候选更多不一定更好
图 7 右侧横轴是替换候选数 ,分别为 7、15、23、31。由于这里 k=1,对应候选总数 N 为 8、16、24、32。准确率分别为 79.4%、80.6%、80.2%、79.4%。
“候选池 16 条”包含已经选中的一条,因此实际有 15 条替换候选。把这两个数字混用,会改变动作数量和编辑器输入。
适度的局部池在这组实验中更有效。扩大候选也增加阅读负担和决策选项,论文没有证明更大池一定提高上限。
3. 运行成本是增加了一次小模型决策
图 8 对比 one-shot TREC、Qwen2.5-7B 的端到端评测时间。
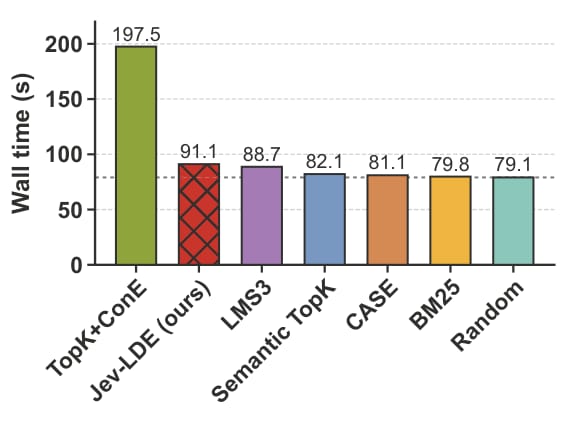
来源:论文 v2,图 8,第 9 页。
Semantic TopK 为 82.1 秒,Jev-LDE 为 91.1 秒,约增加 11.0%;TopK+ConE 为 197.5 秒。对应的 TopK 与 Jev-LDE 准确率是 65.4% 和 80.6%。
时间统计覆盖完整测试流程,包括检索、候选构建、选择或编辑,以及目标模型推理,取五次运行均值。它不是单个 query 的响应时延,也不能直接转换为任意云端 API 的费用。
相对于纯检索,LDE 增加了编辑器调用及部署资源。相对于需要反复用目标模型评分的方法,它减少了测试期目标调用需求。训练状态探测和 GRPO rollout 的费用没有包含在这项测试期增量里。
论文还将编辑器接在 BM25、CASE 和 TopK+ConE 后面,在 24 个 TREC 组合上均改善了各自初始化。不过,完整基线比较中不同方法保留各自的候选范围:TopK+ConE 使用语义 Top-30,LDE 默认 Top-16,其他方法按原有协议访问完整池。公平性来自共享测试数据、提示和指标,不能描述为所有方法都使用同一个局部候选集合。
4. 理论分析解释局部搜索的条件
第一个命题研究一个简化的多数投票模型。在奇数 k、二元判断、候选判断不随上下文变化,以及给定其他判断后每个检索判断的正确概率至少为 等条件下,可以得到最小修复距离的几何尾界:
D 是从当前集合到同一候选池内某个正确集合所需的最少替换数。条件 $0<D<\infty$ 已经排除了无法通过池内选择修复的情况。这个结果说明在给定模型假设下,距离较远的可修复错误概率受到限制。
真实 LLM 的示例贡献会依赖上下文,多分类任务也超出了二元多数投票设定。因此,这个命题为局部编辑提供直觉依据,不能证明所有模型、所有 query 都只需编辑一次。
第二个命题针对预先固定的有限策略类、独立标注 query 和均匀动作采样,给出近最优策略的反馈需求上界。固定误差与置信水平时,充分反馈量随动作数线性增长。
它解释了限制动作空间可能降低学习难度,但没有给出实际 Qwen3 编辑器、奖励过滤和 GRPO 优化的统一收敛保证,也没有直接证明跨数据集迁移。理论过程与实际训练管线应分别理解。依据:第 3.3 节、附录 F。
七、复现与 DIY:先验证哪些环节
截至阅读日期,作者主页写明将在论文最终版本时开放推理代码。当前可以按附录搭建对照流程,但没有经过核验的官方安装命令或编辑器权重下载地址。只有基础 Qwen3-1.7B,并不意味着已经拿到了训练后的 Jev-LDE。
1. 固定基线和数据划分
先选择一个带可靠标签的分类任务,划分训练示例库、编辑器训练数据与留出评测集。训练 query 自身不能出现在它的 demonstration 中,评测题及答案不能用于状态过滤或奖励训练。
先跑不编辑的 Semantic TopK 或 BM25,记录准确率、每 query 的输入长度、目标调用次数和完整延迟。保留预测明细,后面才能统计哪些原本正确的题被编辑破坏,哪些错误被修复。
2. 将编辑器接口做成独立模块
为当前集合和候选建立稳定 ID,明确 selected_id 与 candidate_id 所属范围。输出只允许三类动作,每次应用最多一次成员变更,替换时保持其余位置不动。
通用模型的提示版编辑器可以作为额外基线,需要按原任务验证,不应直接标为 Jev-LDE。还应分别统计无效 JSON、非法 ID、Keep、Delete、Replace,以及各动作后的任务结果。
3. 需要训练时,分别记录准备成本与优化成本
用带标签训练 query 构建局部状态,按论文的探测协议筛出有奖励差异的状态。保留探测预算、过滤比例和训练来源,避免只汇报最终学习效果。
随后按组采样动作,用冻结目标模型计算奖励,只优化编辑器。训练日志至少包括奖励均值、有效动作比例、各动作占比、目标模型调用量和 checkpoint。原文未披露最终保留状态总量等细节时,复现记录应明确自己的实际配置。
4. 用独立任务检查迁移和退化
先在原目标上比较 Keep、随机编辑、提示版编辑和训练版编辑,再换未提供训练反馈的目标模型。若希望验证跨任务能力,需要真正留出数据集,不能只更换同一批问题的标签粒度。
至少报告准确率增量、被修复与被破坏的样本数、格式错误率、延迟及费用。医学、金融等高后果场景还需任务专用验证,论文的平均分类收益不能替代安全评估。
5. 判断是否适合自己的 RAG 或 Agent
若系统依赖少量带标准答案的示例、检索结果整体可用、错误常集中于个别成员,LDE 的局部修复思路值得做受控实验。它尤其适合测试期无法承担多次目标模型评分的场景。
普通 RAG 的上下文往往是证据文档,删掉一段可能破坏事实支持。论文中的 demonstration 带有输入和答案,和一般检索文档的角色不同。将方法迁移到文档 RAG,需重新定义奖励、引用完整性与删减约束,当前分类实验没有验证这一步。
在研究资料整理中,可以先尝试带明确标签的任务,例如对实验记录、文献条目或用户意图进行分类。直接扩展到无线信号理解、长链工具规划或开放式论文写作,需要另行构造数据与评测,不能沿用这里的收益数字。
八、读完后应保留的判断
LDE 将检索后的示例修复单独建模,给一个小型策略明确、受限的动作空间,再用下游真实正确性训练它。这个设计把训练阶段的多次探索转化为测试阶段的一次决策。
最强证据集中在分类和较小的示例预算上。固定候选池之外的缺失内容、多条示例需要协同修改的错误,以及推理密集任务,仍是当前方法的边界。论文报告的五次评测使用同一已训练编辑器和固定数据,并不等于五次独立后训练,也不足以评估训练随机种子的稳定性。
复用时最先要检查的是错误结构:好示例是否已在局部候选里,任务是否有可靠反馈,编辑引入的收益能否覆盖额外调用与退化风险。把这几项测清,再决定是否训练专门编辑器。
来源
阅读版本 PDF:2609.33609v2,含正文、表 1–7 及附录 A–G。
作者技术解读与交互示意,用于核对作者解释和代码开放状态。
阅读与链接核验日期:2026-10-16。文中数值均来自作者报告,未实际训练或复现 Jev-LDE。五张图片均为论文 v2 原图的主体裁剪,保留原坐标、图例和数值;教学例子及伪代码已单独标明。