Agent Lightning v1.0: Towards Harnessed Agentic RL 论文阅读
摘要
从精确token轨迹讲到样本合并、rollout优势、三种损失归一化与动态调度,完整拆解代理式Agent强化学习、编码数据清洗和实验边界。
一个能修改仓库、运行测试、调用子 Agent 的系统,训练时也需要这些能力参与交互。把业务 Agent 的循环重写到强化学习框架里,需要重新实现上下文管理、工具协议、环境生命周期和失败处理,两套实现还可能逐渐产生差异。Agent Lightning v1.0 选择保留实际使用的 Agent 执行框架,通过模型 API 代理记录交互,再把记录转换为强化学习样本。
这里的 harness 指管理工具、上下文、环境和执行流程的外壳。论文称这种训练方式为 harnessed agentic RL:部署时使用的 harness 直接参与训练。论文的主要贡献是解释这条服务边界带来的统计与工程问题,并给出具体实现。最容易被忽略的是,一个任务的执行轨迹可以产生多个训练样本,样本数量取决于重新分词、上下文压缩和分支,不能让这些实现细节无意中改变任务的学习权重。
阅读依据是 arXiv:2608.17528v1,2026 年 8 月 18 日提交,全文 21 页,作者来自 Microsoft、复旦大学、浙江大学和爱丁堡大学。它是 Agent Lightning 的 v1.0 系统论文,与 2025 年的初版论文需分开阅读;当前材料属于预印本。对应代码在 microsoft/agent-lightning。下面覆盖正文的方法、三个实验和附录 A 的系统设计,并区分作者报告与迁移到自己项目时需要验证的选择。
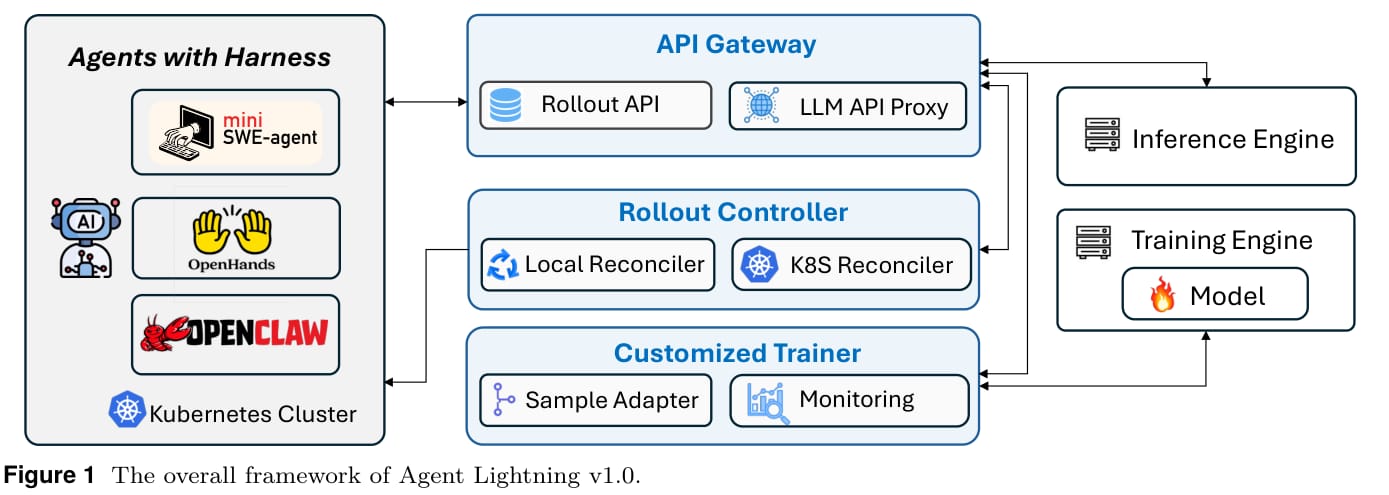
图 1|论文原图 Figure 1,PDF 第 1 页。左侧运行 Agent harness,中间负责代理、生命周期和样本转换,右侧负责模型推理与更新。工具执行资源与训练 GPU 可以独立部署。
一次任务、一次模型调用、一个训练样本分别是什么
先把三个对象分开。rollout 是 Agent 为一个输入完整执行一次任务,例如尝试修复一个软件缺陷。model call 是执行过程中的一次模型请求,例如读完测试错误后让模型决定下一条命令。training sample 是送进训练后端的 token 序列及损失掩码。一个输入可以采样多个 rollout,一个 rollout 可以调用模型多次,也可以被转换成多个 training sample。
传统的线性 Agent 训练通常由训练器拥有交互循环。模型生成动作,环境返回观察,观察继续追加到 token 历史。论文用以下关系表达连续性:
其中 是这一步的提示 token, 是上一步模型实际生成的 token, 是新观察。工具返回虽然不应计算策略损失,仍然作为后续生成的条件进入序列。只要历史一直追加,一次 rollout 很自然地对应一条长序列。
实际 harness 可以删除旧消息、总结上下文、转交子 Agent、修改工具结果展示格式。训练器在模型端点看到的是:
它看不到所有中间状态,也不能假设 包含此前完整历史。论文把潜在状态写为 harness 状态与环境状态的组合。模型只根据 harness 本次构造的精确提示生成响应。这仍可用部分可观测马尔可夫决策过程描述,训练样本的构造却需要重新定义。
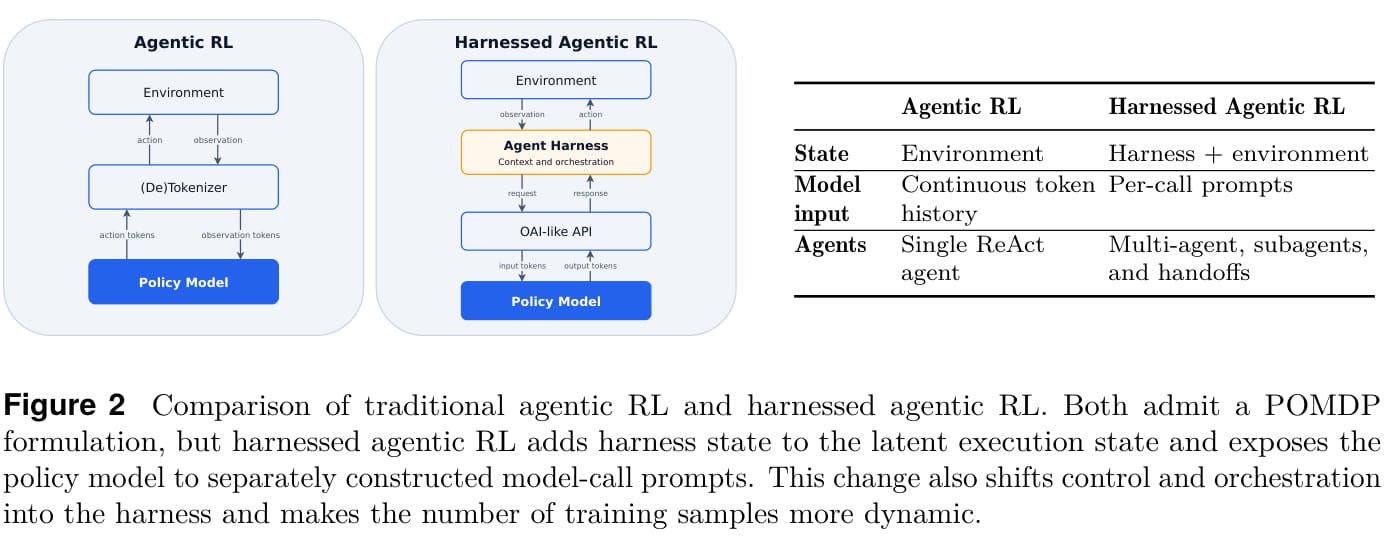
图 2|论文原图 Figure 2,第 3 页。控制权转到 harness 后,训练器需要忠实记录每次调用的条件,而不能把执行过程一律当成不断追加的 token 历史。
对自己的 Agent 项目,第一步是确认训练器究竟能够观察什么。只有最终回答和最终分数,无法恢复各次调用的采样概率;只有文本聊天记录,也未必能恢复模型实际生成的 token。这些记录是策略更新的输入,缺失后不能靠事后拼接获得等价轨迹。
重新分词为什么会让轨迹合并出错
论文要求合并前检查一个精确条件:
表示 token ID 层面的完整前缀匹配。下一次提示必须真实包含上一次提示和原始生成 token,才能把新观察与新动作追加到同一训练序列。比较文本相等还不够。
原图给出 having 的例子:上一轮实际采样出 h、aving 两个 token,转换为字符串后仍是 having;下一轮对完整消息重新分词,可能得到 hav、ing。读者看到的文字一致,token 边界已经改变。上一轮记录的 log probability 属于原始采样 token,不能直接套到重新分词后的 token 上。
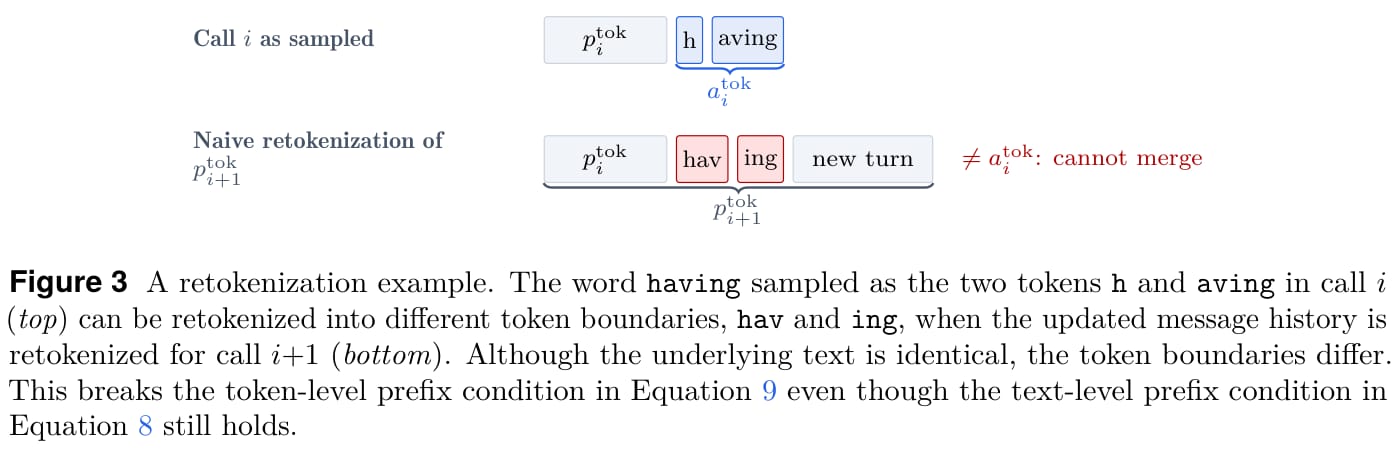
图 3|论文原图 Figure 3,第 4 页。示例说明文本前缀连续不保证 token 前缀连续。
论文观察到三类原因,涉及不同处理层:
原因 | 变化发生在哪里 | 训练时的影响 |
|---|---|---|
聊天模板不满足可组合性 | 对完整历史渲染时增删分隔符、换行或标记 | 分段渲染后拼接不等于完整历史渲染;论文举出 Qwen 旧 |
解码后重新分词发生漂移 | token 转文本再转 token | 相同字符串可能对应不同 token 序列 |
推理输出被转换 | 工具调用或结构化输出处理器解析、修复、重新序列化 | JSON 空格、分隔符或结构发生变化,甚至文本本身也不再相同 |
一种处理办法是把原始采样 token 强行替换回下一轮提示。这会提高合并比例,但需要问:下一轮响应究竟是在什么提示下采样的? 如果采样使用的是重新构造的 ,训练却替换成 ,就改变了该动作的条件,形成 off-policy discrepancy。恢复上一轮 token 的操作也可能破坏下一轮的真实性。
v1.0 采用 best-effort sequence merging:只有观测到的 token ID 满足精确前缀关系时才合并;不满足时关闭当前序列,另起一条。它保留 rollout 真正消费的提示,不为提高合并率改写提示。代价是共享前缀可能重复计算。
论文同时讨论两种替代路线。每个调用独立训练最容易保证 token 正确性,但长前缀被多次计算,成本较高。树状训练可以只计算精确公共前缀,通过分支感知的因果掩码让 token 只看祖先和本分支之前的 token,理论上复现独立序列的结果;它需要树形 packing、定制掩码或内核、分区与分布式梯度处理。v1.0 使用普通稠密因果训练内核,在正确性与后端复杂度之间做了明确取舍。
这也解释了为什么“一个 rollout 被拆成多条序列”会经常出现。除重新分词外,子 Agent 的独立提示、主 Agent 的上下文总结都会打断前缀。在编码实验中,平均只有 36% 的 rollout 能保持一个训练样本,每个 rollout 平均产生 2.41 个样本。把拆分视为罕见异常,会影响后续算法设计。
优势值应由任务执行计算,避免被拆分数量改变
GRPO 为同一输入采样多个 rollout,再比较各自的奖励。为了理解论文的设计,先用均值中心化的优势示例:;实际训练的标准化和数值设置还应与 GRPO 配置一致。
同一个问题有两次执行。第一次成功,奖励 1;第二次失败,奖励 0。第一次由于重新分词拆成三个训练样本,第二次保留一个样本。每个样本继承所在 rollout 的最终奖励。
统计单位 | 进入均值的奖励 | 奖励均值 | 成功与失败的中心化优势 |
|---|---|---|---|
rollout | |||
training sample |
两次执行的结果没有变化,重新分词却改变了所有样本的优势。成功执行如果多产生几个样本,整个组的基线就被抬高。子 Agent 数量与上下文压缩策略也能以同样方式影响基线。
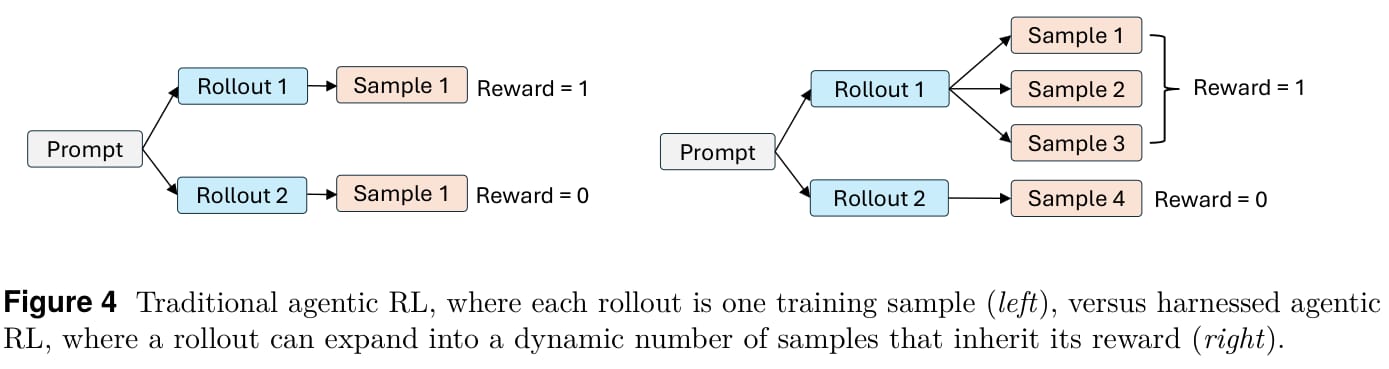
图 4|论文原图 Figure 4,第 7 页。右侧成功 rollout 被拆为三个样本,失败 rollout 保留一个。计算优势时应仍将它们识别为两次执行。
作者选择在 rollout 层计算奖励组的统计量和优势,然后传给这个 rollout 内的训练样本。理由是,意外的 token 划分变化不应改变一个执行结果的价值。这与细粒度信用分配是两件事:给同一次执行的所有调用相同结果信号,并没有识别究竟哪一步导致成功。论文明确保留了跨样本信用分配的问题,不能把 rollout 级优势描述成已经解决长期因果归因。
这对带多 Agent 分支的系统尤其相关。任务失败可能源于主 Agent 的错误决策,也可能源于一个子 Agent 的检索错误;统一任务奖励是可实现的起点。若要分别奖励子 Agent,需要额外的归因定义与证据,不能根据它产生几条序列来决定权重。
损失怎样归一化,会决定训练更偏向哪些轨迹
正确计算优势后,还要定义 batch 中的梯度平均方式。设一个 batch 有 个 rollout;rollout 被拆成 个样本,第 个样本有 个响应 token。每个响应 token 的策略损失记为 ,提示和工具观察不计算动作损失。
论文比较三种归一化。
按全 batch 响应 token 平均,对应论文 Equation 14:
每个响应 token 权重相同,长 rollout 的整体权重更大。把同一批 token 无损拆分为几条样本不会改变分子和分母,但长负样本可能占据较大权重。作者在训练后期观察到这会造成不稳定。
先平均每个样本的 token,再平均所有样本,对应 Equation 15:
这给每个样本相同权重,导致一个 rollout 拆得越多,占据的总权重越大。即使这些拆分来自模板与分词细节,也会改变优化方向。
先池化每个 rollout 的响应 token,再平均 rollout,对应 Equation 16,是 v1.0 的选择:
每个任务执行占据相同总权重,在一个执行内部按响应 token 平均。一个 rollout 多调用几次模型,或者因重新分词拆成更多样本,都不会单凭样本数增加整体权重。长轨迹内部的每个 token 权重更小,这是这种选择附带的长度权衡。
把论文的具体例子走一遍:A 有两个样本,响应长度 50、100;B 有三个样本,各长 30;C 有一个样本,长 40。记各样本的 token 损失和为 。
token 平均的分母是 ,A、B、C 的总权重分别为 。
sample 平均共有 6 个样本,A 占 ,B 占 ,C 占 ,同时每个样本内部按自身长度平均。
rollout 平均先分别除以 150、90、40,再对三个值平均,A、B、C 各占 。
这些目标不等价。第三种方式贯彻作者希望每次执行等权的设定;它也不构成对所有任务都最优的数学证明。需要结合任务长度分布、负样本比例和训练曲线验证。
代理、控制器、训练器怎样组成一次完整更新
系统分成三个组件,核心代码约 3,500 行是作者报告的实现规模,不包含所有依赖和运行环境。
组件 | 它拥有的状态与职责 | 它不需要重新实现的部分 |
|---|---|---|
API Gateway | rollout、模型端点、追加式事件;代理模型调用与推理准入 | Agent 的业务循环 |
Rollout Controller | 启动执行、观察运行状态、同步终态;支持 Kubernetes 和本地进程 | 优化器与策略损失 |
Customized Trainer | 基于 VERL 注册任务、收集事件、转换样本、计算优势与更新 | 工具如何执行、上下文如何总结 |
附录 A 进一步定义数据对象。rollout 有独立 ID、输入、元数据和 queuing → running → succeeded/failed 状态。model 对象保存名字和推理端点。每次模型交互生成 model_request 事件,包含提示 token ID、响应 token ID、响应 log probability;任务结束通常上报一次标量 reward 事件,也支持自定义事件。
代理路径包含 rollout_id 和 attempt_id,因此请求可以自动归入正确执行尝试。这里使用 OpenAI 兼容协议描述 API 形状,不要求调用商业 OpenAI 模型;实验训练的是自己托管的策略模型。模型、tokenizer 与概率记录都必须与训练对象匹配。
下面是按论文整理的教学伪代码,用于理解数据流,省略具体 VERL 调用和分布式实现,不能直接当作官方 API 示例运行:
实际后端还要保留响应 mask、采样概率和策略版本信息,避免把提示、环境输出当成策略动作。flatten 只是把序列展开成物理 tensor batch,不能抹掉它们所属的 rollout 和输入组。
动态样本数也影响 GPU 调度:执行前只知道 rollout 数量,执行结束才知道实际序列数量和长度;GPU 数、数据并行、张量并行和流水线配置通常固定。训练器需要平衡 token 工作量,并确保同一 rollout 的样本进入同一次 optimizer update。如果把一部分放在本轮、一部分放在更新后的下一轮,就会引入执行内部的策略版本偏移。
同卡异步:减少等待,也要管住推理与更新的边界
同步 RL 要等 batch 中最慢的 rollout 完成后更新。长任务、慢工具和重试会拖住 GPU。传统异步方式把 rollout 与更新分到两套 GPU 池,可以重叠工作,但小团队需要更多 GPU,并管理两个速度不同的队列。
v1.0 采用 collocated async RL:推理和权重更新分时共享同一组 GPU。收集到足够完成的 rollout 后开始更新,无需等待所有仍在执行的任务结束。切换时 Gateway 停止接纳新的推理请求,等待已经进入推理的请求完成;后续请求暂停,到系统返回 rollout 阶段再继续。harness 的业务循环因此不必主动处理 GPU 阶段切换。
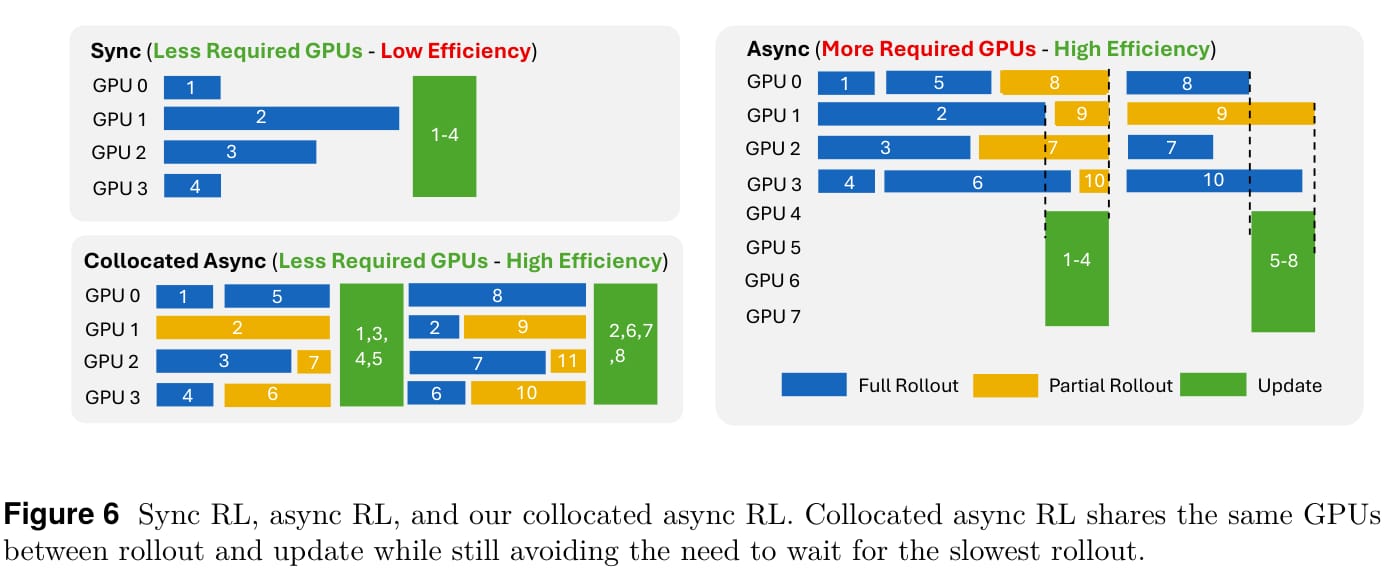
图 5|论文原图 Figure 6,第 10 页。橙色表示部分 rollout,绿色表示权重更新。共享 GPU 池通过阶段切换避免等待最慢的完整执行。
作者报告相对同步训练约 2 倍端到端加速,并称其相对分池异步方案需要更少 GPU。这个数字依赖任务时长分布、工具耗时和硬件安排,不能直接承诺自己的项目也有相同比例。切换暂停对 harness 不可见,仍需关注长时间执行跨越权重更新后产生的策略陈旧问题;论文的“同一次优化更新保留 rollout 边界”要求与任务实际使用模型版本应一起检查。
论文没有在正文给出足以独立复现所有吞吐数字的 GPU 型号、完整并行配置、每阶段耗时和硬件成本表。复现资源应从对应代码与配置核对,不能把“modest compute”自行改写为固定卡数或固定预算。
网络可靠性也属于训练语义。Gateway 的控制端点设计为幂等,网络失败后重复请求不会重复创建同一效果。模型生成请求本身不能按同样方式幂等,每次重试可能产生不同响应。作者在样本构造时,对同一 rollout 中提示完全相同的重复 model_request 仅保留最后一次,丢弃较早、被替代的调用。
这条去重规则用于处理论文场景中的重试与覆盖。如果自己的 harness 会有意对同一个提示做多次独立有效探索,需要单独区分重试和有效调用,否则保留最后一次可能丢失实际行为。应通过事件与尝试标识明确语义,这属于迁移时的工程检查。
执行方面,Controller 将任务作为 Kubernetes Job 调度,自托管环境可以避免商业沙箱按调用计费。K8s Reconciler 通过 watch 获取低延迟变化,并周期性 list 补齐遗漏事件;本地进程后端直接持有进程句柄,周期轮询即可。Gateway 状态是系统依据,Kubernetes 观测可能延迟,控制器持续协调使它们恢复一致。附录明确其保证是尽力而为的最终一致性,不能理解成跨服务的强一致事务。
编码 Agent 的 6K 训练数据是怎样得到的
作者选择 Qwen3.5-9B 与 mini-SWE-agent,以 SWE-smith 的可执行软件修复任务训练。SWE-smith 包含 59,136 个任务、128 个 Python 仓库,任务通过向真实仓库引入缺陷构造,带问题描述、补丁与验证测试。作者引用的 Docker 镜像总量为 295 GB;镜像存储较小也不等于并发执行与测试没有 CPU、内存成本。
数据管线的重点是让每条样本产生有意义的学习信号。
删除问题描述为空的任务,原始数据中有 18,033 条属于这种情况。
删除镜像里缺少对应问题分支的任务,作者发现 1,265 条。
删除测试数超过 200 的任务,防止巨大测试套件拖垮执行吞吐;文中举出的一个仓库需要运行超过 7,000 个测试。
对剩余候选用初始 Qwen3.5-9B 各运行 4 次。四次都成功的任务被移除,成功与失败混合的任务留下,约得到 5,000 条。
再加入约 1,000 条四次都失败的较难任务,防止训练集过易。最终训练约 6,000 条,另有约 400 条测试任务。
这些计数不应逐项简单相减,因为过滤条件可能重叠;论文也使用近似规模描述最终划分。混合成功和失败的任务能让组内奖励产生区分,四次全成功的组难以提供有效相对信号。全失败任务仍被少量保留,以覆盖更困难的区域。这是依赖初始模型能力的数据选择方案,更换模型后应重新评估难度分布。
训练期间作者观察到模型利用 Git 历史找金标准代码,或通过 wget、curl、pip、Python 网络库下载上游源码。这些路径可能让测试通过,却没有学会依据当前问题与本地代码修复缺陷。其防护包括禁用 Git 命令、隐藏 .git,再用 Kubernetes 网络策略阻止普通外连,仅允许白名单服务。
这种限制定义了该实验的有效解题范围,不能无条件照搬到所有 Agent 产品。若部署任务本来允许联网检索,训练与评价应清楚定义允许的信息来源;若目标是评估本地软件修复,就需要防止答案直接从上游泄露。任务奖励、环境约束和真实目标应保持一致。
实验分别证明什么,哪些数字不能混在一起
论文验证了搜索、通用指令与编码三个场景,模型、算法、数据和奖励不同。
场景 | 模型与训练 | 设置及评价 | 作者报告结果 |
|---|---|---|---|
搜索 Agent | Llama-3.2-3B-Instruct,GRPO | HotpotQA 训练;每个提示 4 次 rollout,训练 batch size 512;每 10 步评价;六个问答数据集各抽 50 条,以 exact match 奖励 | 验证奖励 25.1% → 41.7%,增加 16.6 个百分点 |
通用指令 Agent | Qwen3-4B-Instruct-2507,RLOO | 使用 LLM-in-Sandbox harness;Instruction Pre-Training 数据 80%/20% 划分;batch size 8,每个提示 8 次 rollout,每 20 步评价 | 验证奖励 51.9% → 70.2%,增加 18.3 个百分点 |
编码 Agent | Qwen3.5-9B,GRPO | mini-SWE-agent;经过上述过滤的 SWE-smith;在 SWE-bench Verified 做外部评价 | 初始 41.8% → 第 208 步 56.4%,增加 14.6 个百分点 |
搜索评价涉及 HotpotQA、2WikiMultiHopQA、MuSiQue、Bamboogle、TriviaQA 与 Natural Questions,每个数据集只有 50 个抽样实例。它支持“这套流程在该设置下可训练搜索行为”的结论,对小规模抽样分数仍应保留统计波动的认识。不同场景的奖励百分比不代表同一种能力,不能平均成统一 Agent 得分。
编码实验进一步比较三种设置,它们使用同一个底层 GRPO 目标:sample 级优势加 token 平均损失;rollout 级优势加 token 平均损失;rollout 级优势加 rollout 级 token 平均损失。
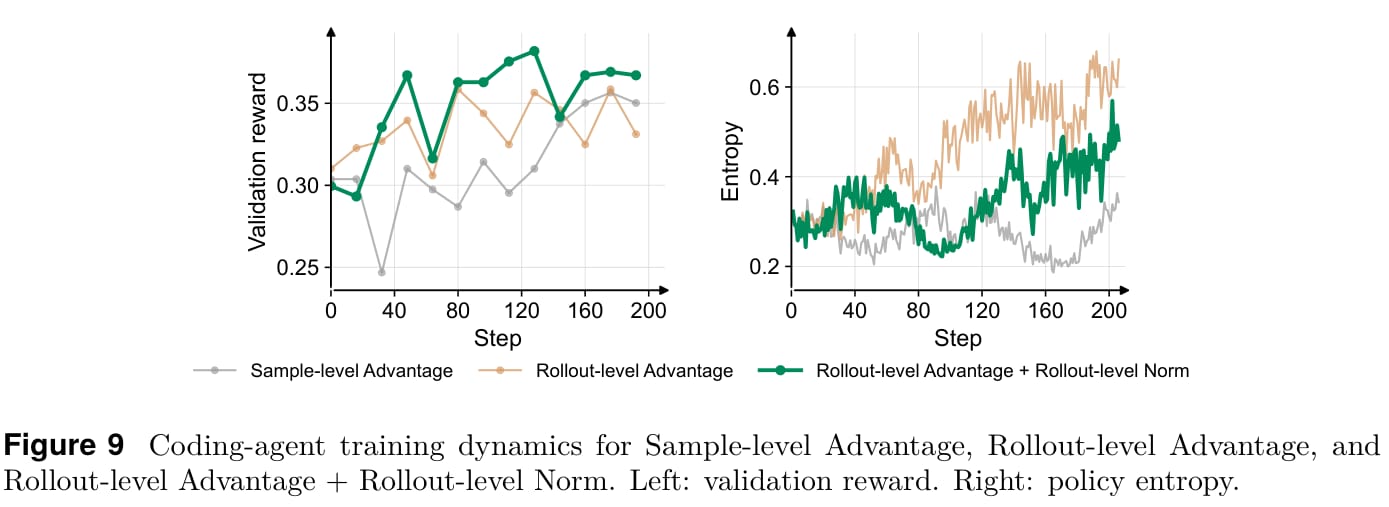
图 6|论文原图 Figure 9,第 13 页。左图为验证奖励,右图为策略熵。仅修改优势的方案出现更明显的熵增长,同时修改归一化的方案更稳定。
作者报告,第三种方案最高观察到的内部验证奖励为 38.2%,出现在第 128 步;基线为 35.0%,仅修正优势的方案为 33.1%。这组数据说明修改优势与修改损失权重应一起验证,单独采用更合理的基线不保证曲线更好。
38.2% 是过滤任务上的验证奖励,56.4% 是 SWE-bench Verified 的评价结果,二者对应不同集合与检查点。 不能把它们排列成同一测试从 38.2% 提升到 56.4% 的过程。论文未报告这一消融的多随机种子置信区间,单次曲线支持该配置的经验结论,尚不足以证明所有模型和 harness 都必须采用同一归一化。
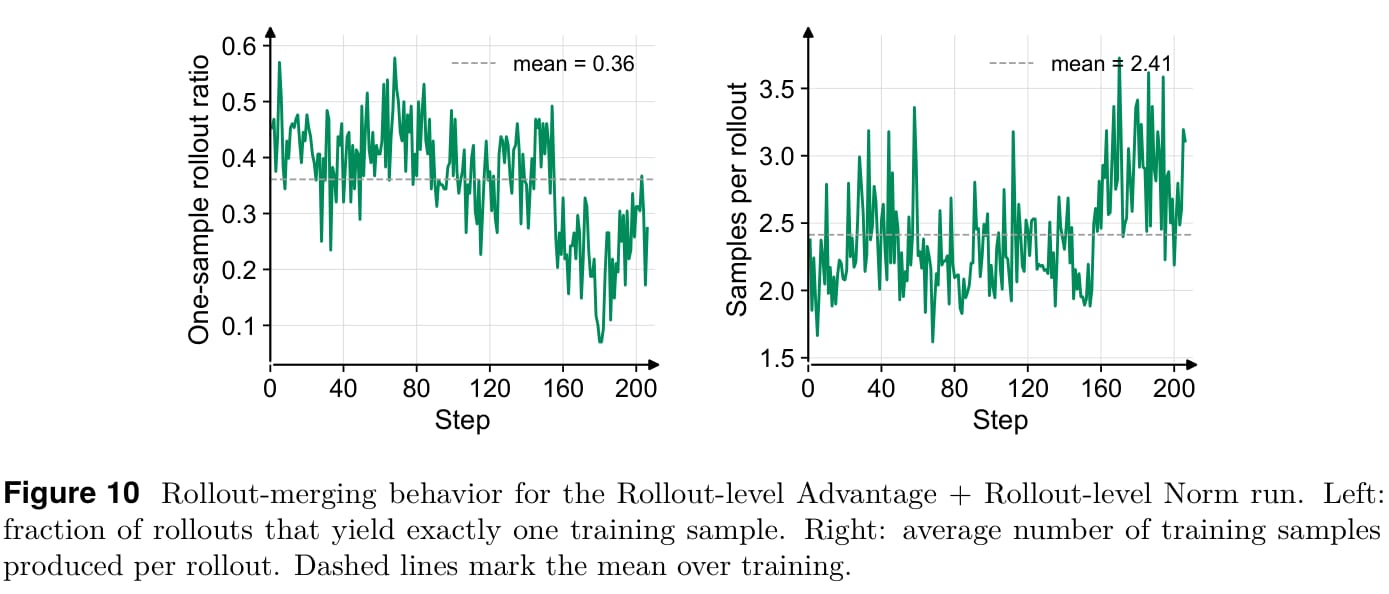
图 7|论文原图 Figure 10,第 14 页。左侧平均 36% 的 rollout 只产生一个样本;右侧平均每次执行产生 2.41 个样本。统计单位的变化在该实验中频繁出现。
在自己的 Agent 与模型训练中怎样落地
这篇论文适合已有 harness、可自行托管和更新模型的项目。它提供的 API 代理路径不自动赋予第三方闭源模型权重更新能力。准备训练前,至少要有可重置任务环境、可靠奖励、模型概率与 token 记录、能完成更新的训练后端。
可以先选择一种能清楚判定完成状态的任务,如在隔离仓库修复缺陷并通过独立测试。保持与实际使用一致的聊天模板、工具协议和上下文政策。给输入、rollout、生成尝试分别建立身份记录,保存模型实际消费的提示和实际采样输出。先观察轨迹的拆分比例、响应长度分布、失败类型和奖励分布,再检查相对优势是否仍按原输入组统计。
接下来应检查训练器的损失代码究竟在哪个维度执行 mean。样本平均、token 平均和 rollout 平均在动态轨迹下会产生不同权重,仅修改变量名或把 reward 复制给每条样本不能解决这个问题。同一 rollout 的序列归属、损失 mask 和优化更新边界都要保留。
观察指标应覆盖四层:任务是否完成;模型生成了什么、耗费多少 token 与调用;样本转换是否改变原始条件;系统有没有静默失败、重复事件和状态停滞。论文的监控记录包含输入、状态、模型请求、奖励、token/turn 统计、自定义事件和 Kubernetes 执行日志。作者也利用这些记录发现奖励作弊,说明查看高分轨迹本身是训练验证的一部分。
如果任务尚未具备可信的执行奖励,应先完善评测和环境。若主要问题是提示与上下文政策,可以先从前面的 Manus 和 GEPA 阅读中建立可测的系统,再决定是否更新模型权重。若有强教师的逐 token 概率,On-Policy Distillation 提供另一种信号路线;它与这里基于任务结果的 agentic RL 有不同接口和成本,不能把两者的采样与奖励代码直接混用。
学完这篇后,应能沿着同一个例子解释:任务输入如何创建多个 rollout,harness 如何调用代理,代理为什么记录精确 token,哪些调用可以合并,结果奖励怎样变成 rollout 级优势,loss 如何保证任务权重,以及 GPU 更新为什么需要保留执行边界。56.4% 是验证这套选择的一个结果,这条从执行到优化的链条才是可迁移的知识。
原文定位与复现材料
正文第 1–2 节解释 harnessed agentic RL、重新分词、优势、归一化与后端调度;第 3 节解释系统边界、同卡异步、网络和执行管理;第 4 节给出三类实验、数据过滤与奖励作弊防护;附录 A 说明 Gateway 对象、控制器和训练器。公式分别对应原文 Equations 9、14–16,教学例子取自原文的优势与损失讨论。
阅读与复现入口:论文 v1、完整 PDF、官方代码与训练工作流。执行代码前需要核对与论文匹配的版本及实际配置;本文未独立运行这些训练,也未补造论文未披露的硬件、时间或超参数。