
Harness² 技术阅读:Agent 如何改进自己的执行框架
摘要
结合论文与固定版本源码,拆解 Harness² 的八类可编辑组件、Propose–Probe–Compose、跨任务经验库、实验与失败案例,并说明 Linux 安装、免费演示、模型费用及自定义 Agent 接入边界。
一个 Agent 能调用终端、读取文件,也能写出一份看似完整的报告,却仍可能漏掉输入材料、算错跨表数据,或者生成一个打不开的交付文件。模型能力影响结果,围绕模型运行的提示、工具、技能、记忆和检查流程也影响结果。后面这一层,通常称为 harness,执行框架。
Google Cloud AI Research 与 Northwestern University 的研究者提出了 Harness²:面对一个新任务,先观察现有 Agent 的执行过程,再提出配置修改、试跑候选方案、根据行为差异组合修改。任务结束后,保留有证据支持的配置与经验,供后续任务按需参考。整个过程保持模型权重不变。
它研究的是推理期间的系统改进。论文报告了专业办公、网页、代码和法律任务上的收益,也给出了选择失误、错误经验传播和计算开销等反例。要理解它的价值,需要同时看两层递归怎样配合,以及系统在没有标准答案时究竟掌握了什么证据。
来源与整体认识
项目 | 信息 |
|---|---|
研究原文 | |
作者与机构 | Ruiyao Xu、Yanfei Chen 等;Northwestern University、Google Cloud AI Research |
阅读版本 | arXiv:2610.14224v1,2026-10-09 提交;预印本,未据此认定会议或期刊录用 |
官方代码 | google-research/harness2,Apache-2.0 |
代码快照 |
|
改进对象 | Agent 的执行配置、可执行辅助组件,以及供后续改进使用的经验库 |
不变部分 | 模型权重;单个任务内的改进机制;跨任务的阶段指令与决策规则 |
项目定位 | Google Research 名下的研究代码;仓库明确说明其不属于 Google 正式支持的产品 |
先看官方的流程总览。左侧完成当前任务的改进,右侧整理这次改进为什么有效,再将可复用经验提供给后面的任务。
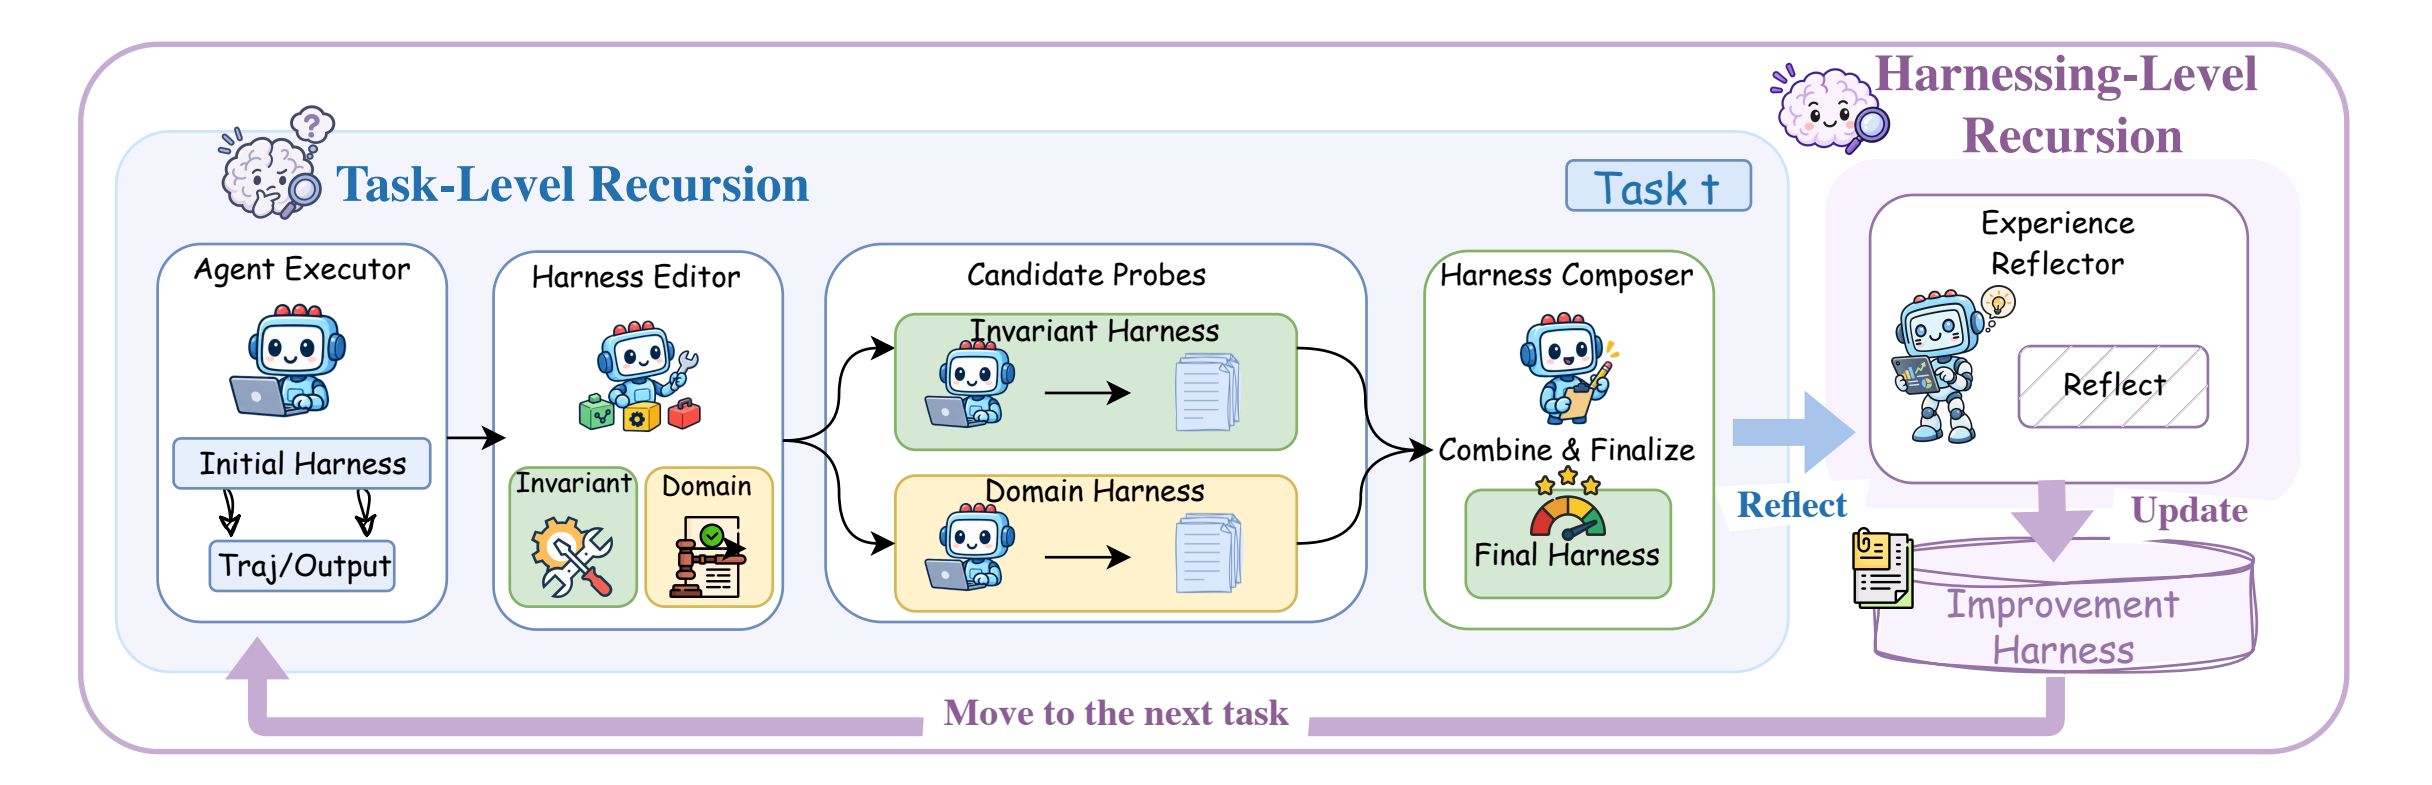
来源:官方仓库 assets/harness2_pipeline.png,对应论文图 3 的流程。原图,非本文生成。
图中的执行者、编辑者、组合者和反思者是不同职责。它们可以使用不同模型,也可以复用同一个模型。多个角色的存在,并不意味着必须部署多个训练好的新模型。
一、先分清模型、执行框架和改进框架
执行框架到底包含什么
模型根据当前上下文生成内容或工具调用。执行框架决定上下文放什么、工具怎样暴露、哪些操作需要检查、何时启动子任务,以及如何接收结果。相同模型配上不同框架,可能走出不同的工作流程。
Harness² 将可编辑空间分成四类,共八个组件:
运行位置 | 组件与文件示例 | 作用及生效时机 |
|---|---|---|
上下文构造 | C1 | 顶层角色和工作流程,每次调用提供 |
上下文构造 | C2 | 跨任务约束与交付要求,每次调用提供 |
上下文构造 | C3 | 当前执行配置携带的持久知识,每次调用提供 |
上下文构造 | C6 | 专门的多步骤流程,触发后按需加载 |
工具接口 | C4 | 工具的选择条件、输入规范和使用提示 |
工具接口 | C7 | 解析、转换、核对等确定性操作,通过终端执行 |
编排 | C5 | 将部分工作交给独立上下文的子 Agent |
中间件控制 | C8 | 在工具调用或回合边界执行程序化控制 |
这里有两个容易混淆的区别。技能描述的是专门流程,脚本负责可确定执行的工作;中间件则位于工具循环里,可以在运行时强制检查条件。仅在提示中写“结束前检查文件”,仍依赖模型遵守。程序化检查可以明确拒绝不合格的完成请求。
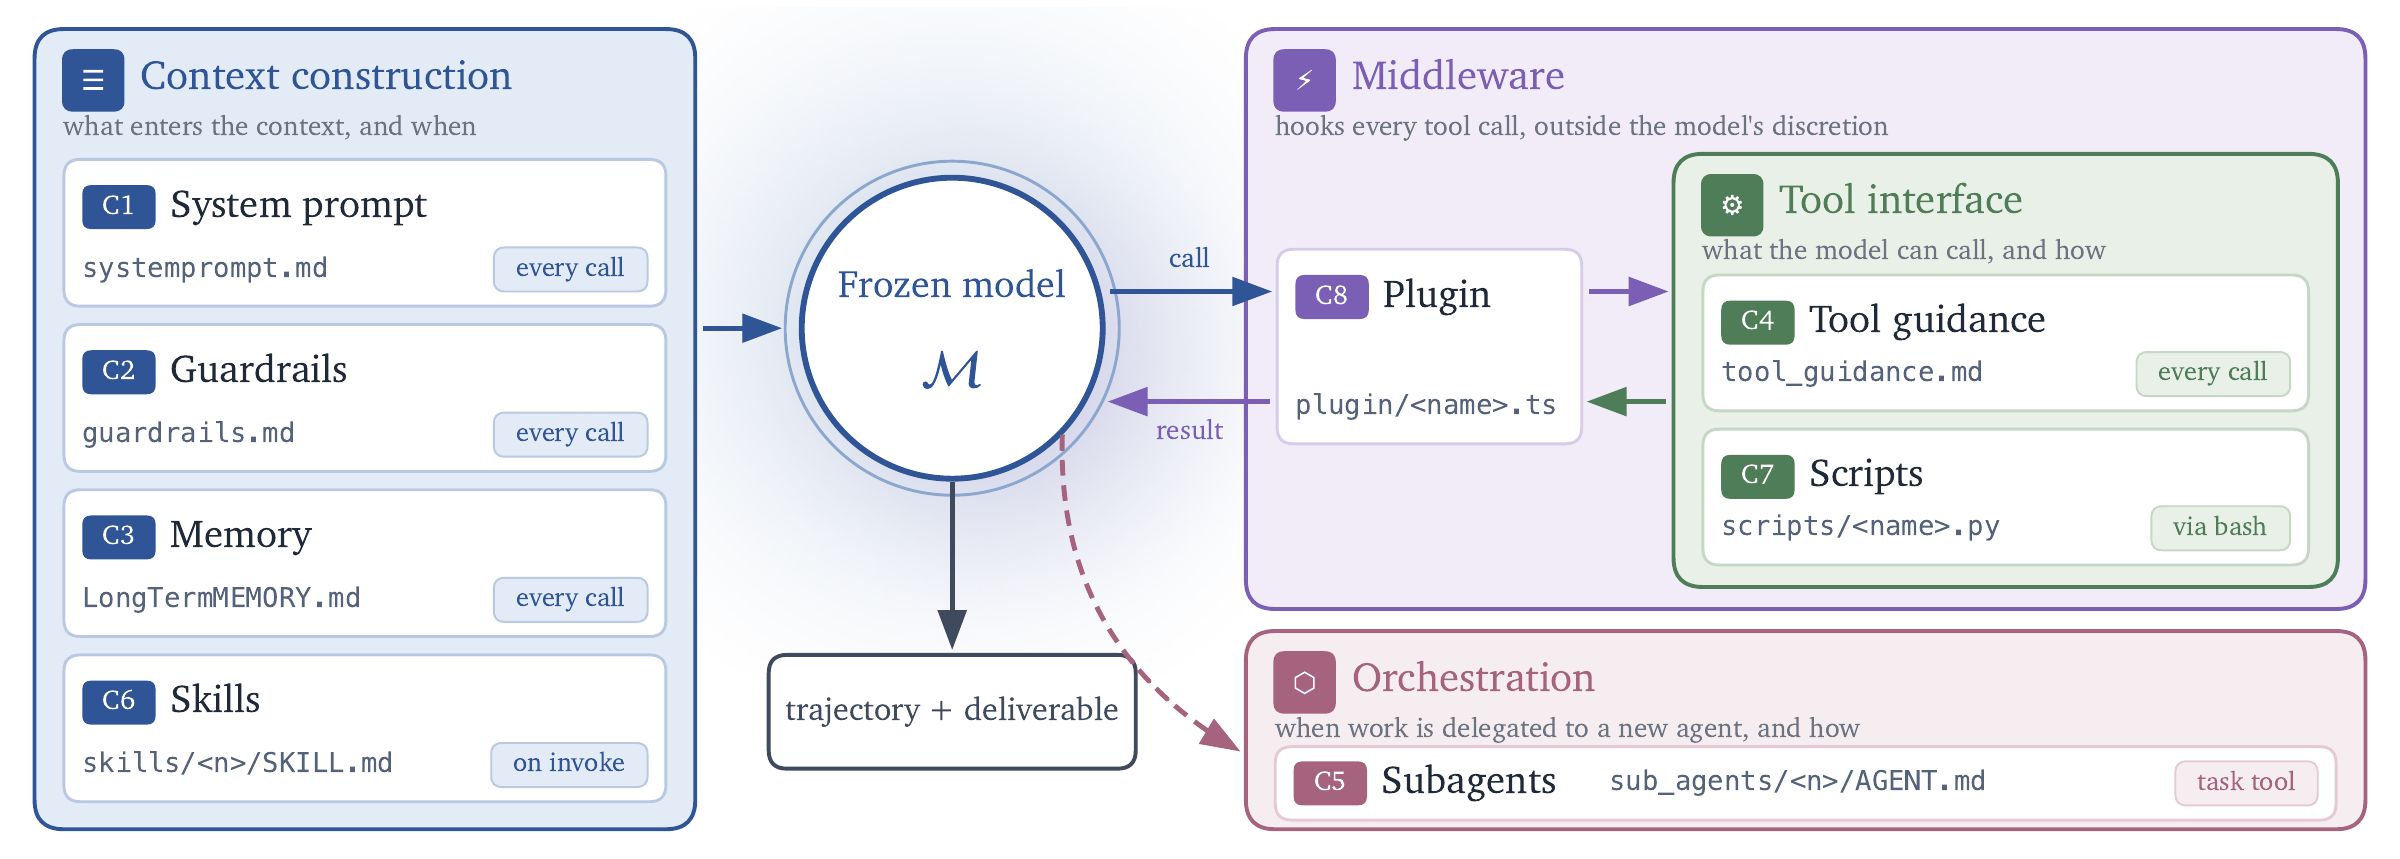
来源:官方仓库 assets/components.png,对应论文图 2;具体文件与激活方式见论文附录 D.3、表 5。
图中示意的是 OpenCode 接口。论文说明,Codex 接入时常驻指令会映射到 AGENTS.md,相应组件路径也会调整。不能把上述文件名当作所有 Agent 工具都原生识别的统一协议。
两套框架各自负责什么
执行框架 H 负责完成当前任务,例如读取预算表、整理材料、生成文件。改进框架 R 负责指导怎样诊断执行问题、提出修改,以及参考哪些历史经验。
在任务 t 内,系统固定 R,只搜索当前执行框架 H 的修改。交付后,再根据本次完整记录更新 R 中的经验库。下一任务从共同的基础执行框架 H₀ 开始,参考更新后的经验进行改进。
这个起点很重要。上一任务可能需要法律检索,下一任务需要网页开发,直接继承整套专用规则容易造成干扰。Harness² 将历史配置放进经验库,由新任务的编辑过程决定复用哪些部分。
RSI 在这里意味着什么
Recursive Self-Improvement,递归自我改进,指系统对自己的持久组成做出修改,修改又影响后续的工作或改进过程。Harness² 将这一想法落实在执行文件和经验库上。
它没有执行梯度下降,没有训练奖励模型,也没有改变底座权重。模型仍通过已有接口完成任务。所谓改进,体现在下一次运行会读取什么规则、调用什么脚本、如何组织工具,以及改进者会参考什么经验。
二、任务级递归:怎样在没有标准答案时修改配置
1. 先运行一次,留下可以比较的参照
系统用当前配置完成任务,保存执行轨迹与交付物。轨迹包含做过哪些操作、读到什么结果、在哪里报错;交付物是生成的文档、代码或其他实际产物。
参照运行能够揭示行为。例如 Agent 完全没有打开某个附件,或者只确认文件存在、没有重新打开文件检查内容。观察这些问题不一定需要标准答案。
但参照运行本身无法告诉系统报告里每句话是否正确。论文把执行记录写成 e = (τ, y),τ 表示轨迹,y 表示交付物。这两部分都是后续比较的输入。
2. Propose:让两个编辑方向分别提出修改
两个编辑者读取任务、当前配置、参照轨迹、当前任务已有记录和经验库,提出可执行的候选配置。
通用方向,Invariant。 处理跨领域重复出现的流程问题,如漏读输入、工具参数错误、上下文管理混乱、未检查交付物。
领域方向,Domain-specific。 处理当前任务的知识和工作约束,如预算口径、法律材料组织方式、特定数据格式或业务流程。
分工的作用是让候选有不同的诊断角度。一个候选可以增加文件核对脚本,另一个候选可以补充预算表之间的对应规则。它们最终修改的是文件,系统可以查看实际差异。
候选必须能运行。论文附录说明,会检查技能触发条件、脚本是否可编译、技能引用的辅助文件是否齐全等。原始实现对无效候选允许一次修正尝试,仍不合格时保留原配置并记录该阶段失败;结构检查通过也不代表内容正确。
3. Probe:用同一任务试跑候选
系统在匹配的模型和环境设置下执行候选配置,将其轨迹、文件和参照运行对比:新增脚本是否真的执行?漏读的输入是否被读取?修改有没有让另一项要求丢失?
例如原执行只处理了支出,候选执行开始同时处理冲销记录。这个差异支持“修改改变了数据处理行为”,还需要进一步检查冲销符号、数据来源和最终数值。
行为变化与答案正确性需要分别判断。 两次运行可能共享同一个错误假设,也可能因为采样波动而偶然变好。论文明确保留了这个限制。
4. Compose:按证据组合修改,再执行最终配置
组合者读取基础配置、候选差异、全部可用轨迹和交付物,决定保留哪些修改。它可以合并互补修改、解决冲突、只采用一个候选,也可以维持当前配置。
组合不等于把所有建议拼接进一个很长的提示。如果候选 A 改善了来源核对,候选 B 增加的领域规则却没有证据,组合者可以仅保留 A 的相关修改。
最后,组合后的配置还要实际执行,产生新的交付物。系统保存组合决定及其证据,供后续反思使用。单步流程可以概括为:
上述流程依据论文第 2.2 节整理,用于说明控制流。
5. 并行与串行:预算 k 到底控制什么
并行模式先收集 k 次基础运行,提出并试跑 k 个通用候选和 k 个领域候选,再进行 k 次独立组合。每次组合都能读取完整候选池,组合结果分别执行。论文实现执行一次种群更新,k 增大表示探索更宽。
串行模式同样先收集 k 次基础运行,再连续执行 k 轮修改。后一轮读取上一轮改进后的配置和累积证据,逐步修正。
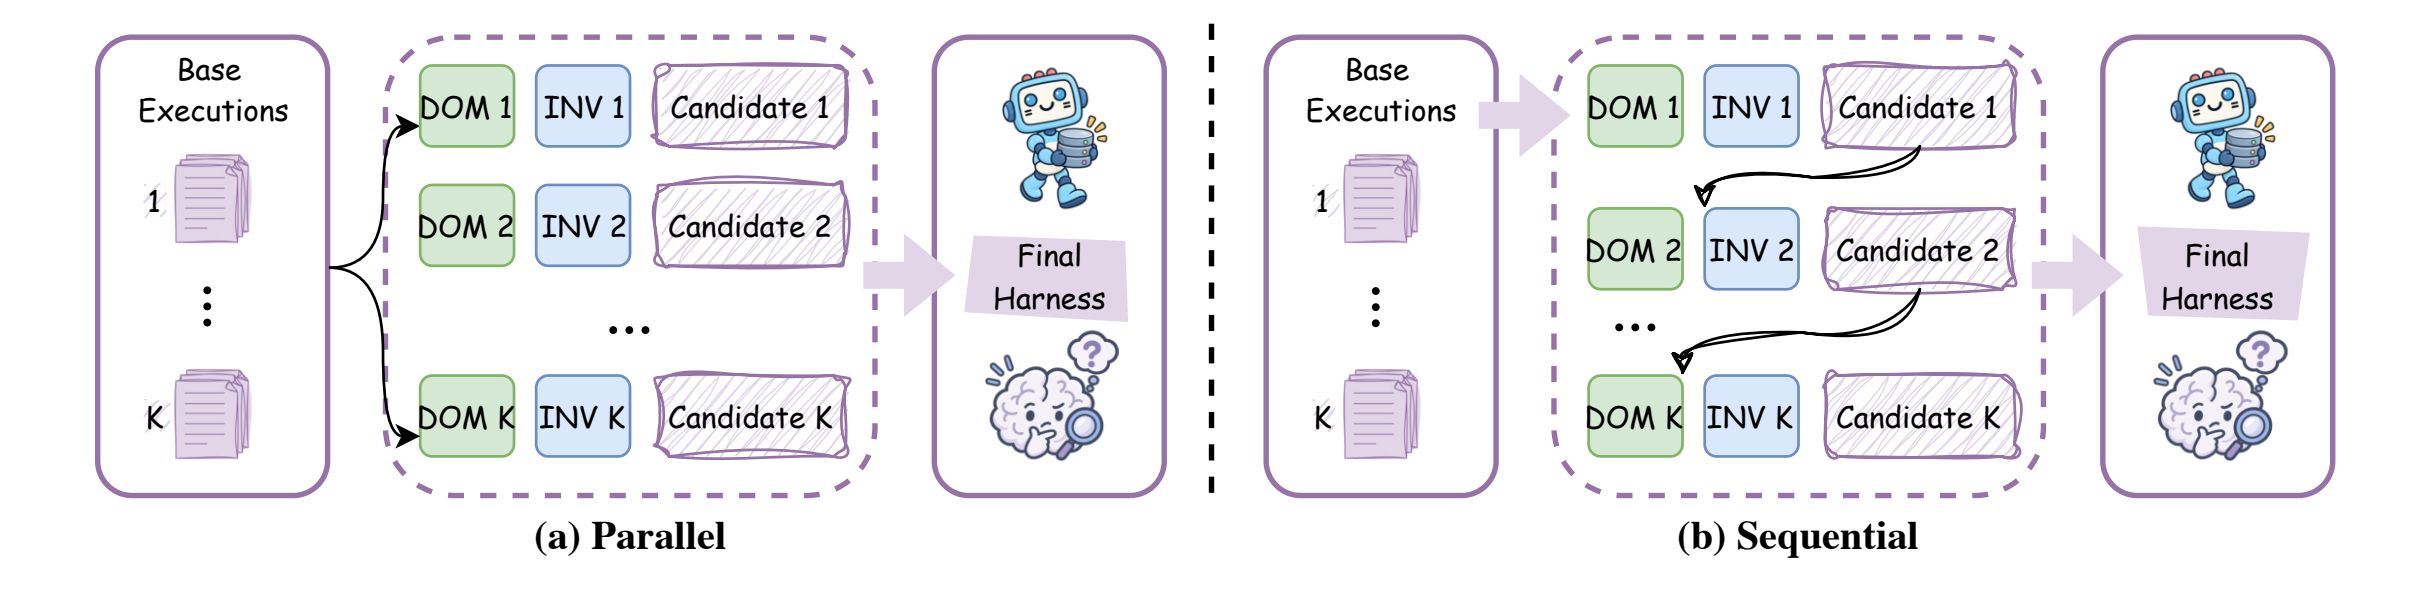
来源:官方仓库 assets/harness2_recursion_modes.png,对应论文图 4。并行增加候选宽度,串行增加改进深度。
当 k > 1 时,选择者对匿名化的候选交付物进行比较。它能看到任务和来源材料,不能看到评分标准,也不能另写一个新答案。它选择一个已有产物,并采用对应配置。k = 1 时跳过这个最终选择阶段。
代码 core/recursion.py 给出的基础调度量是 4k 次执行、3k 个改进阶段。因此 k = 1 已经涉及多次执行,k = 5 的基础执行量达到 20 次;最终选择、反思、必要重试以及每个 Agent 内部的多回合调用还会增加工作量。k 不能直接解释为 API 调用次数。
三、跨任务递归:什么经验值得留下
任务结束后,反思者读取完整的改进记录:参照运行、候选修改、试跑结果、组合依据和最后采用的产物。它要提炼的是某项修改在什么条件下改变了什么行为。
一条经验库记录同时保留:
采用的完整可执行配置,便于复用代码、技能和提示组件。
EXPERIENCE.md,记录触发情形、经验、支持证据和置信范围。可浏览的索引,供后续任务按需打开相关条目。
“交付前要更认真”缺少可操作信息。“处理包含正负交易的流水时,检查汇总脚本是否过滤负数;本次去掉正数过滤后,原先遗漏的抵扣进入总额”则给出了情形、修改和证据。
原始实现允许在证据不足时不新增条目。任务被选择,也无法单独证明其修改能迁移。经验库不是每次执行后自动堆积一篇反思文章的容器。
在同一领域内,任务按顺序处理,只读取之前任务留下的记录。库按基准、执行器、模式、预算和随机种子等配置隔离。论文中的前向任务流、跨基准迁移和利用后续任务经验的回顾实验属于不同设置,不能混为持续在线学习。
还要区分两种“记忆”:C3 是某个执行配置自身携带的知识文件;改进经验库服务于编辑和组合过程。二者位置和用途不同。
四、用一个真实案例把流程连起来
论文图 9 给出 JobBench 中的制作管理任务:根据排期、人员和预算文件,生成彼此一致的交付材料。基础运行得分为 43.1。
轨迹暴露了两个流程问题:不同文件中的数字没有对齐,输出写完后没有重新打开验证。
通用编辑提出工作流程修改:先清点输入,追踪数字的权威来源,结束前运行核验脚本并重新打开产物。领域编辑补充排期、场地、用工和预算的核对方法,以及金额字符串、条件性支出等处理提示。
组合者保留了涉及护栏、技能、脚本和工具提示的四项修改。改进后的运行补齐材料并核对跨文件数字,作者的事后评测得分为 77.8,增加 34.7 分。
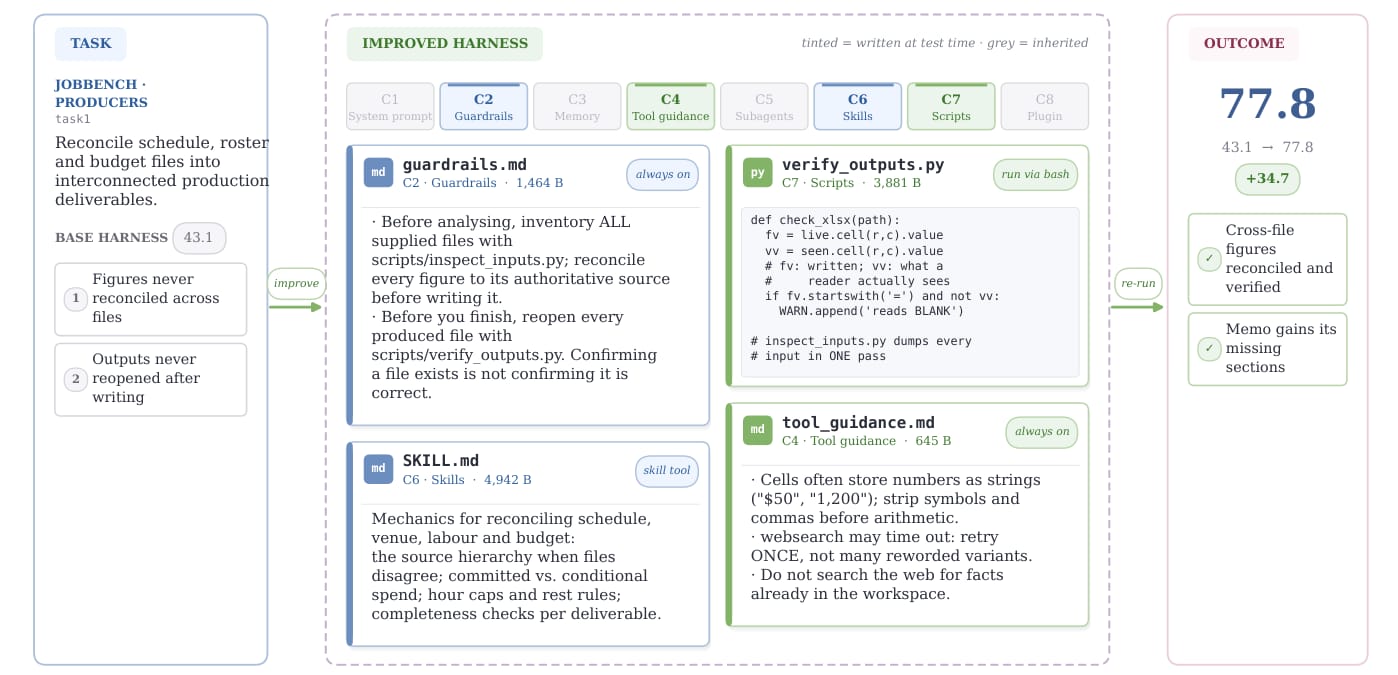
来源:论文 v1 图 9,第 12 页,裁去页面中与图无关的正文,保留完整图体。43.1 → 77.8 为作者案例结果。
这个案例将修改落到了具体组件。输入没读全对应清点流程,金额口径不一致对应领域技能,文件可用性对应重新打开和机械核验。改进者执行修改时看不到后来评测得到的 43.1 和 77.8,图中的分数用于事后展示。
再看一个更小的例子。官方本地 demo 让脚本汇总含正负数的交易流水:
基础脚本只累加正数,得到 105.25;去掉这个过滤条件后,总额应为 85.15。demo 的编辑与选择由预先写好的确定性逻辑实现,选择逻辑还会按源流水计算总额。它适合观察真实的执行、文件差异和经验保存流程,不能承担“真实 LLM 无标准答案自我改进”的验证任务。
五、实验的收益、比较条件和反例
先看评测在测什么
论文使用两个冻结执行模型 Gemini 3.5 Flash、GLM-5,分别搭配 OpenCode 和 Codex,共四种执行配置。默认编辑者和最终选择者使用 OpenCode 中的 Claude Opus 4.8。每项主结果报告三次独立任务流的均值与标准差,任务顺序会打乱。
基准 | 本文结果对应的评测规模 | 指标含义 |
|---|---|---|
WorkBuddy-Bench | Code 40、Web 35、Office 25 个测试任务 | 每个任务通过检查的比例;检查包含程序规则及模型/视觉裁判项,Avg. 为三个领域的宏平均 |
JobBench | 固定划分中的 34 个测试任务 | 根据带权评分标准计算任务得分 |
LAB | 固定的 100 个法律测试任务 | Partial:逐项标准的通过率,不能当作整题完全正确率 |
这些测试集规模来自论文附录 B。当前仓库运行器可以读取更大的上游任务集,直接使用默认下载数据跑一遍,不等于复现论文的固定划分。复现应记录任务 ID、数据版本、模型和配置快照。
论文所说“不使用标准答案”,限制的是编辑、选择和反思可接触的反馈;实验结束后仍有基准裁判评估产物。无标签改进和无评测是两个不同概念。
单步收益有多大
下面摘录 OpenCode 配置,展示两个执行模型的变化。数值来自论文表 1、表 2,省略标准差以方便阅读,完整统计见原表。
执行模型 | WorkBuddy Avg.:基础 → k=1 | JobBench:基础 → k=1 | LAB Partial:基础 → k=1 |
|---|---|---|---|
Gemini 3.5 Flash | 72.4 → 77.5,+5.1 分 | 31.5 → 36.0,+4.5 分 | 79.9 → 81.9,+2.0 个百分点 |
GLM-5 | 64.2 → 75.7,+11.5 分 | 20.6 → 24.2,+3.6 分 | 59.6 → 71.4,+11.8 个百分点 |
截图中的三个最大增益分别来自不同基准及模型条件,不能合并成某个模型在所有任务上的统一提升幅度。
在 WorkBuddy 上,GLM-5 加上改进后的配置可以超过 Gemini 的基础配置。这说明系统设计可以改变这个基准中的相对结果;默认编辑者使用了另一模型,整个改进过程还投入了更多计算,因而不能推导出 GLM-5 本身已经普遍超过 Gemini。
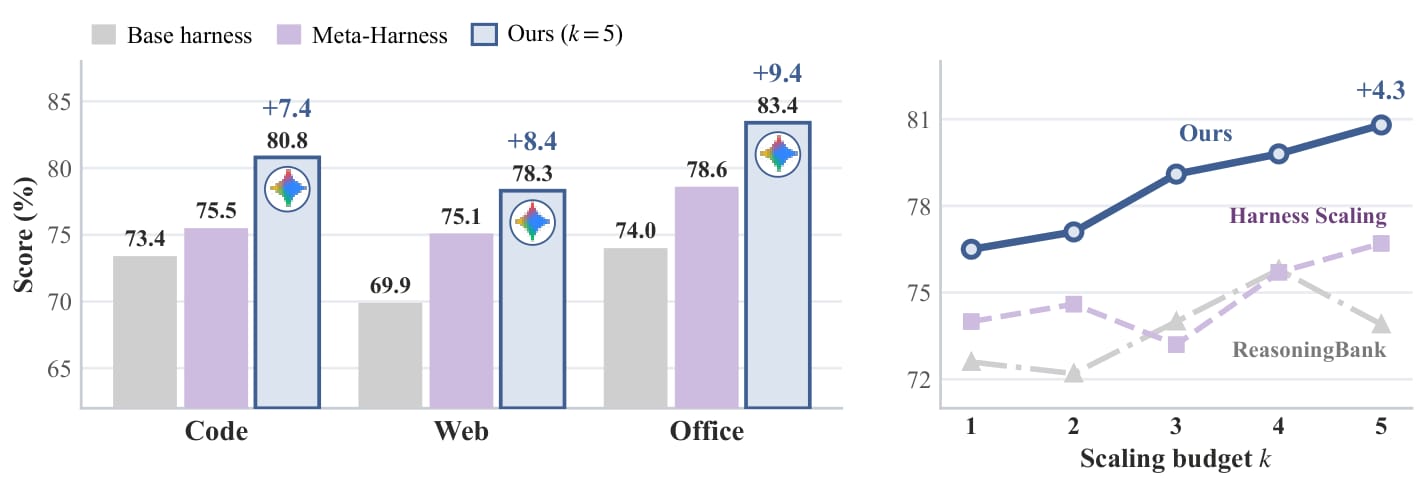
来源:论文 v1 图 1,第 1 页。左侧是 Gemini 3.5 Flash + OpenCode 在并行 k=5 时的结果;右侧展示 Code 领域随预算变化的趋势。
论文也有例外:LAB 的 Gemini + Codex 配置中,k=1 的 Harness² Partial 为 75.6,低于 Meta-Harness 的 76.5。平均改进成立,并不意味着每一配置都优于全部比较方法。
三个设计环节是否都必要
在 Gemini + OpenCode、k=1 条件下,作者移除不同机制,结果如下:
配置 | WorkBuddy Avg. | JobBench |
|---|---|---|
完整 Harness² | 77.5 | 36.0 |
不读写改进经验库 | 74.4 | 34.2 |
两个通用编辑者替代通用/领域分工 | 74.6 | 32.3 |
保留候选试跑,省略组合阶段 | 75.9 | 34.1 |
来源为论文表 3。移除分工的实验保留了候选数量和探测预算,支持分工本身对这些结果有贡献。经验复用和组合过程也各有作用。
迁移有效,但收益随对象变化
JobBench 得到的经验库用于 WorkBuddy 的单步改进,Code、Web、Office 分别额外增加 0.6、0.5、2.9 分。附录 E.3 还把为 Gemini 3.5 Flash 改进的配置直接交给 GLM-5、Gemini 3.7 Flash、Claude Opus 4.8 使用:均有收益,幅度差异较大。
例如 Code 领域中,GLM-5 从 58.5 到 75.8,Gemini 3.7 Flash 仅增加 0.3 分。跨模型可复用有实验支持,“模型无关且到处同样有效”超出了这些证据。
作者另测了编辑者与执行者使用同一模型的情况,五个受测模型在对应基准上均有提升,表明这一流程在实验中并非必须依赖更强编辑者。这个补充设置使用 OpenCode、k=2,不能直接替换主表 k=1 的条件。
错误也可能被选中、固化和传播
附录 E.6 列出的失败案例很有用:一次 Code 任务的候选池中已经存在得分 95 的产物,选择者却选中了得分 55 的产物;另一次改进将未经核实的缓存假设写进规则,连检查脚本都沿用同一个假设,因而检查通过仍没有解决任务。
这些分数是事后评测结果,当时的选择者看不到。案例暴露了两个风险:交付物写得完整、表达流畅,可能干扰选择;编辑者和验证脚本共享错误前提时,增加检查未必增加独立证据。
因此,重要任务仍需要与执行者分离的检查来源。可执行测试、来源核对、人工审核和严格任务约束,能够补充仅靠模型判断的薄弱环节。
六、成本和安全要放在使用步骤之前
更少的执行步骤,不等于更低的总成本
论文的 #Steps 统计执行者会话中的模型回合数,不包含全部提案、试跑、组合、选择和反思成本。某个最终执行更短,整个改进过程仍可能更贵。
论文图 6 按最终交付前消耗的总 token 比较成本与收益,包含执行和改进开销。它不是端到端耗时图,也没有证明任意预算下都存在固定收益。并行可以利用并发缩短等待时间,总计算量仍在。
当前发布代码有需要主动处理的边界
官方 EXPERIMENTS.md 明确提醒:公开基准的评分标准可能被联网执行者访问。文档记录过一次发布验证,Codex 执行在没有相关指示的情况下下载了 JobBench 评分标准。
这条记录意味着发布运行器存在泄漏通路,需要限制执行者访问基准答案、评分材料及相关数据托管站点。它不足以单独证明论文中的所有结果都已泄漏,也不能忽略。复现时要报告网络限制。
安装阶段需要联网下载依赖,评测阶段的执行者网络策略可以另行设置。只在提示里写“不要访问答案”无法替代进程和网络层隔离。
仓库还说明 Codex 执行采用关闭沙箱的设置。执行配置能够加入 Python 脚本和 TypeScript 插件,所以应在独立 Linux 环境或容器里运行,只挂载任务必需文件。生产密钥、个人目录、公开发布权限和支付等有副作用的接口应留在可编辑范围之外。
七、下载和使用:从免费本地演示开始
下列命令依据核对时的官方代码与文档整理。没有在本次任务中运行任何付费模型基准,也没有把仓库接入当前博客的生产执行链。 开源代码免费,模型 API、云服务和计算资源是否收费取决于实际使用方式。
1. 准备 Linux 环境和源码
官方以 Linux、Python 3.12 为基准环境;包声明兼容 Python 3.12、3.13。Windows 使用者宜先进入 WSL2 的 Linux 发行版,再执行以下 Bash 命令。原生 Windows 缺少 fcntl,直接运行会遇到导入错误。
固定提交是为了对应本文快照。之后选择新版本时,应重新核对安装指南和运行参数,不混用不同提交的说明。
2. 运行不需要模型密钥的 demo
这个 demo 通过真实 Python 执行完成两笔流水任务,分别走并行和串行流程。查看输出中的 demo.json、各次执行产物和经验库,可以追踪“改了哪些文件、执行出了什么、保存了什么经验”。
本次已在 WSL2 的 Linux 环境实际执行这一演示,并行与串行均使用 k=2。最终记录为两个任务完成、零失败;两种模式选择的流水总额均分别为 85.15 和 20.25,经验库也保存了去掉正数过滤的修改依据。执行途中中断后用相同命令恢复,运行器跳过了已经完成的第一项任务。
本次实际用 Python 3.10.12 直接调用源码中的 python3 -m harness2.cli.demo,参数与上述演示命令相同,未执行包安装或基准环境安装。这只能证明该演示模块在本机运行成功;正式安装仍遵守官方 Python 3.12/3.13 的要求。
这是确定性演示的软件流程核验,没有调用模型 API。它不代表已复现 WorkBuddy、JobBench 或 LAB 的真实模型结果。
3. 确实需要模型评测时,再配置提供方
真实基准还需要 Node.js 20+、Google Cloud CLI 和对应基准依赖。LAB 需要 Pandoc、Poppler;WorkBuddy 需要 Docker。Vertex AI 运行要求账号具备所选模型的访问权限。
需要配置的变量包括 GOOGLE_CLOUD_PROJECT、GOOGLE_CLOUD_LOCATION、HARNESS2_SOLVER_MODEL、HARNESS2_IMPROVER_MODEL、HARNESS2_JUDGE_MODEL。执行者和改进者使用 OpenCode 的 provider/model 写法,裁判字段使用文档规定的裸模型 ID。不要凭显示名称猜测实际 API 模型 ID。
快照中的 README 提到复制 .env.example,但本次核对的提交未包含该文件。可以根据 SETUP.md 的变量表创建本地 .env,或设置相应环境变量;不要照抄不存在的模板路径,也不要提交凭据。
配置完成后进行 Google Cloud 的 Application Default Credentials 授权:
再安装一个基准并检查环境:
harness2-check 检查依赖、凭据和配置,不调用模型,也不验证每个模型是否真的可用。模型访问权限要到首次实际调用时才得到验证。
4. 先预览任务,再限制为一个领域的一项任务
确认环境隔离、模型访问和费用后,去掉 --dry-run 才会执行模型改进:
--max-tasks 限制的是每个领域的任务数。没有 --only-domains 时,--max-tasks 1 仍可能覆盖多个领域。改进、评分和汇总必须使用相同基准、执行器、任务选择、k、模式和种子。
若要比较串行和并行,或更换模型,应使用独立的 HARNESS2_RUNS_DIR。同一命令支持恢复既有进度,不能把不同实验条件写进同一个结果目录。种子控制任务顺序,不保证远程模型采样完全确定。
5. Codex 执行器是额外的适配通路
仓库通过 Responses API 形式的端点连接 Codex 执行器。使用 Vertex 模型时,可安装 bridge 可选依赖,由本地 LiteLLM 桥接服务提供兼容接口;这不涉及修改模型权重。
桥接服务提供需要填写的连接参数,后续 setup、check、run、judge、report 统一传 --substrate cx。WorkBuddy 容器使用桥接时涉及对外监听,应限制访问来源。一次实验中不要混用 OpenCode 运行与 Codex 评分配置。
当前博客仅将这些步骤整理为阅读材料,没有启动该桥接服务,也没有修改你现有 Codex 或 MCP 的配置。
八、怎样 DIY 到自己的 Agent 工作流
从适配器边界入手
仓库将方法、执行器和任务环境分开。core/spec.py 的 BenchmarkAdapter 定义任务侧接口:任务列表、领域、输入材料、基础配置、执行方式、轨迹和交付物读取。substrate/ 定义执行器的配置表面;core/ 处理提案、组合、选择与经验保存。
如果接入自己的数据处理 Agent,需要明确这几个接口:如何在隔离目录运行一次任务,如何获得可比较的轨迹,哪些文件属于交付物,修改的脚本能否通过结构检查,以及结果是否真的可用。仅复制几个提示词,无法自动获得整套执行与比较流程。
公开 CLI 当前面向已提供的三个基准。自定义任务需要实现并接入适配器,仓库没有“一条命令让任意 Agent 自动升级”的已验证通用入口。
一个适合博客研究助手的最小改造
下面是依据论文机制设计的教学方案,未接入本博客,也未做效果测试。
任务可以定义为:给定一组已下载的论文、官方链接和目标主题,生成一篇带证据索引的阅读文章。基础运行只写本地稿,不调用公开发布接口。
通用候选检查工作流程:输入是否读全,图表编号能否对应,是否先保存再回读,图片是否能解码。领域候选检查专业内容:对于无线感知,核对跨域划分、受试者是否重叠、指标定义和传感设置;对于 Agent 文章,核对模型、工具、预算和裁判条件。
候选执行全部停留在隔离目录,比较同一组输入下的稿件与证据。组合时保留能改善可验证缺口的技能或检查脚本。经验库保存适用条件,例如某类 PDF 双栏表格必须回看原页,不能只依赖文本提取顺序。
发布放在独立的最后阶段。试跑产生多个候选,若每次都允许直接调用博客写接口,会产生重复草稿或多次公开修改。研究改进和对外写入需要明确分开,只有选定并验收的结果才能提交。
需要自己补上的工程约束
问题 | 最小约束 |
|---|---|
候选修改影响真实账号或文件 | 使用只读输入、隔离输出和最小权限,不让编辑器修改生产凭据或发布协议 |
编辑者和检查器共享错误假设 | 引入独立来源、固定测试或人工抽查,检查覆盖率与准确性分别记录 |
经验库越积越长 | 保留来源、适用条件和版本,定期核对过时条目;自动整理仍需另行设计 |
计算开销失控 | 先固定低预算,在同模型、同任务和相近成本下比较,记录全部阶段用量 |
相同任务被重复执行产生副作用 | 用可恢复任务记录和明确的最终提交点,探测阶段不执行公开写入 |
这些是本文提出的落地约束,不能据此声称当前开源框架已自动解决权限隔离、成本优化或经验治理。
技能、插件和 MCP 在这里各有位置。技能可以保存编辑步骤和领域知识;插件可以在工具循环里执行检查;MCP 可以提供受控工具连接。Harness² 的完整循环还需要调度、重复执行、差异比较、证据保存和经验管理,单独安装其中一种组件并不会自动补齐这些能力。
九、使用时保留哪些判断
Harness² 对现有 Agent 工作流最直接的启发,是将配置修改也纳入可检查的实验:记录原来的行为,写出修改依据,在相同任务上试跑,保留实际差异,再决定是否复用。任务结果和改进经验都有来源,后续才有机会纠正过时或错误的规则。
对于可低风险重复执行、能保留输入和交付物的研究、办公与代码任务,这种方法值得做受控比较。涉及支付、删除数据或公开发布的任务,应先拆出不会触发真实副作用的探测环境。法律、财务等高风险结果还需要相应专业审核。
论文暂未给出自动决定最优预算、自动清理长期经验库或保证每次选择正确的方案。把这些问题保留为需要验证的工程条件,比将“自我改进”理解成持续、可靠、零成本的能力增长更有助于实际使用。
来源与核验范围
论文摘要与版本记录、v1 PDF、v1 HTML:方法见第 2 节,结果见表 1–3、图 1、5–9;评测、实现、迁移与失败分析见附录 B、D、E;限制与后续方向见附录 F、G。
官方仓库及许可证:核对源码、图片、包版本和研究项目声明。
安装与模型连接说明:Linux 环境、凭据、基准依赖与 Codex 桥接。
实验、网络访问和恢复指南:预算、任务限制、数据版本与评分泄漏风险。
本文读取了论文正文与影响理解的附录,并检查了相关实现。基准实验数字均为作者报告,不代表本文复现。本次实际执行范围为确定性本地 demo、产物与经验库核对;其余模型调用步骤依据官方资料整理,未实际调用。