
LoRA Without Regret 技术阅读
摘要
完整讲解 LoRA 的容量、目标层、batch size 与学习率耦合,保留数学 RL、参数化不变性及 FLOPs 推导,说明怎样为自己的微调建立公平对照。
LoRA 微调效果不好时,原因可能来自适配器容量、目标层、学习率或 batch size。John Schulman 与 Thinking Machines Lab 的这篇实证文章将这些变量拆开,比较监督微调与数学强化学习中的 LoRA 和全参数微调。主要结论是:在研究覆盖的后训练条件下,覆盖合适的层并调好超参数,容量充足的 LoRA 可以接近全参数微调;容量受限、目标层过窄或不合适的优化设置会产生差距。
文章同时讨论了学习率为什么不能直接沿用全参数配置、低秩适配为何仍有较大的梯度传播开销,以及稀疏奖励任务可能需要较少更新容量的原因。对于自己的模型,最有用的阅读方式是把这些结论转成对照实验,检查当前配置限制了哪一环。
信息 | 内容 |
|---|---|
原文 | LoRA Without Regret |
作者与日期 | John Schulman 与 Thinking Machines Lab,2025-09-29 |
类型与 DOI | 实证技术文章;10.64434/tml.20250929 |
阅读版本 | 英文全文,包括参数化、不变性、信息量与 FLOPs 分析;归档 PDF 19 页 |
模型与数据 | Llama 3、Qwen3;SFT 使用 Tulu3 与 OpenThoughts3,RL 使用数学任务 |
关键变量 | rank、学习率、batch size、目标层、数据规模和训练长度 |
主要边界 | 主监督结果以 log loss 衡量;数学 RL 结果不能自动扩展到所有 Agent 奖励与任务 |
来源 |
LoRA 实际改变了哪个计算
考虑一个线性层,原权重为 W,输入 x,输出 y。LoRA 冻结 W,在它旁边增加一个先降维、再升维的更新分支:
若 W 的形状为 d×k,A 的形状为 r×k,B 为 d×r,则更新矩阵 BA 的秩最多为 r。r 决定可训练分支的宽度,α/r 是缩放系数。可训练参数量由 dk 变为 r(d+k),但模型仍需要原有权重进行前向计算。
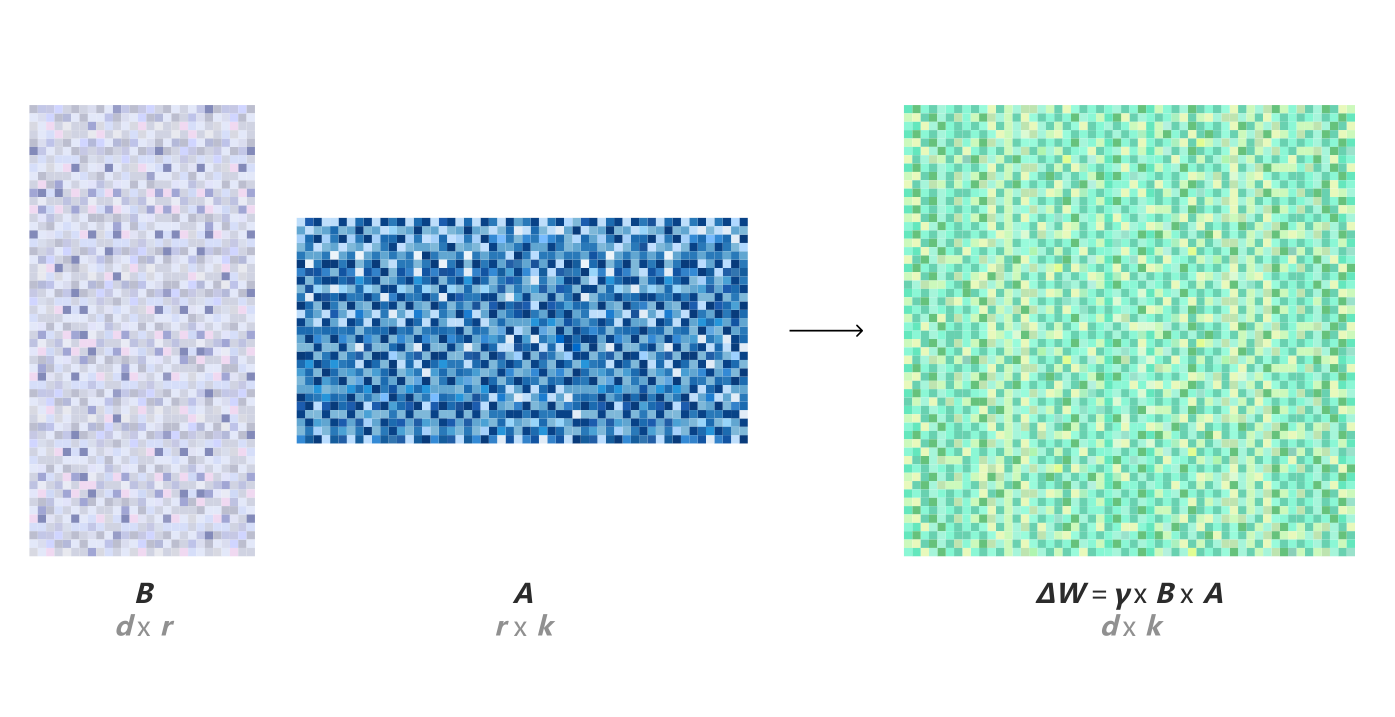
来源:原文,开头的 LoRA 矩阵示意;归档 PDF 第 1 页。图中两个低秩矩阵相乘形成对原权重的更新。
标准初始化让 A 随机、B 为零,因此初始 BA 为零,模型开始时保持原有输出。训练更新 A 和 B,冻结的 W 不产生权重更新。这个结构减少梯度与优化器状态的存储,适配器也更容易保存、传输和切换。冻结基础权重还可以支持多个任务适配器共享同一个底座,但具体推理收益取决于服务实现。
需要区分参数效率与计算效率。训练的参数少,仍要计算基础网络并传播输入梯度。后面 FLOPs 分析会说明这种区别。另一个区别是低秩更新与低比特权重:本文研究的 LoRA 不能直接被当作所有 QLoRA 量化设置的效果结论,量化会增加另一组变量。
实验怎样避免把坏配置误判成方法差距
作者扫描 rank 1 到 512,并对每种设置扫描学习率。主监督实验采用常数学习率,没有 warmup 或 cooldown,使用 Llama 3 与 Qwen3 模型、Tulu3 指令数据和 OpenThoughts3 推理数据。研究重点是训练集大小、更新容量与学习进展的关系。
监督微调可用目标 token 的负对数似然理解:
这里是说明 log loss 含义的教学写法,T 为参与训练的目标 token 数。损失下降说明模型对目标序列分布拟合得更好,并不能独立证明工具任务完成率或事实准确性提高。作者选择 log loss,是为了更清楚地观察学习曲线与容量关系,博客阅读时应保留这一评价口径。
原文图 1 的每条 rank 曲线,按每个训练步选取扫描学习率中的最低损失。它是不同学习率结果形成的点对点下包络,并非一条固定学习率训练轨迹。这个细节会影响复现预期:图中的最优曲线不能直接转换成某个单次运行的配置。
对你自己的数据,需要建立容量和优化两组检查。若只选一个较小 rank、沿用全参数学习率,再与充分调参的全参数微调比较,就无法判断差距来自参数化、容量还是学习率。公平对照应让不同设置拥有合理的调参机会,并报告训练数据、步骤、目标层和评测条件。
Rank 与数据容量:低秩适配何时开始受限
下图横轴是训练进展,纵轴是测试负对数似然,越低越好。重点观察不同 rank 的曲线何时开始与全参数曲线拉开,而非只看最后一处差值。
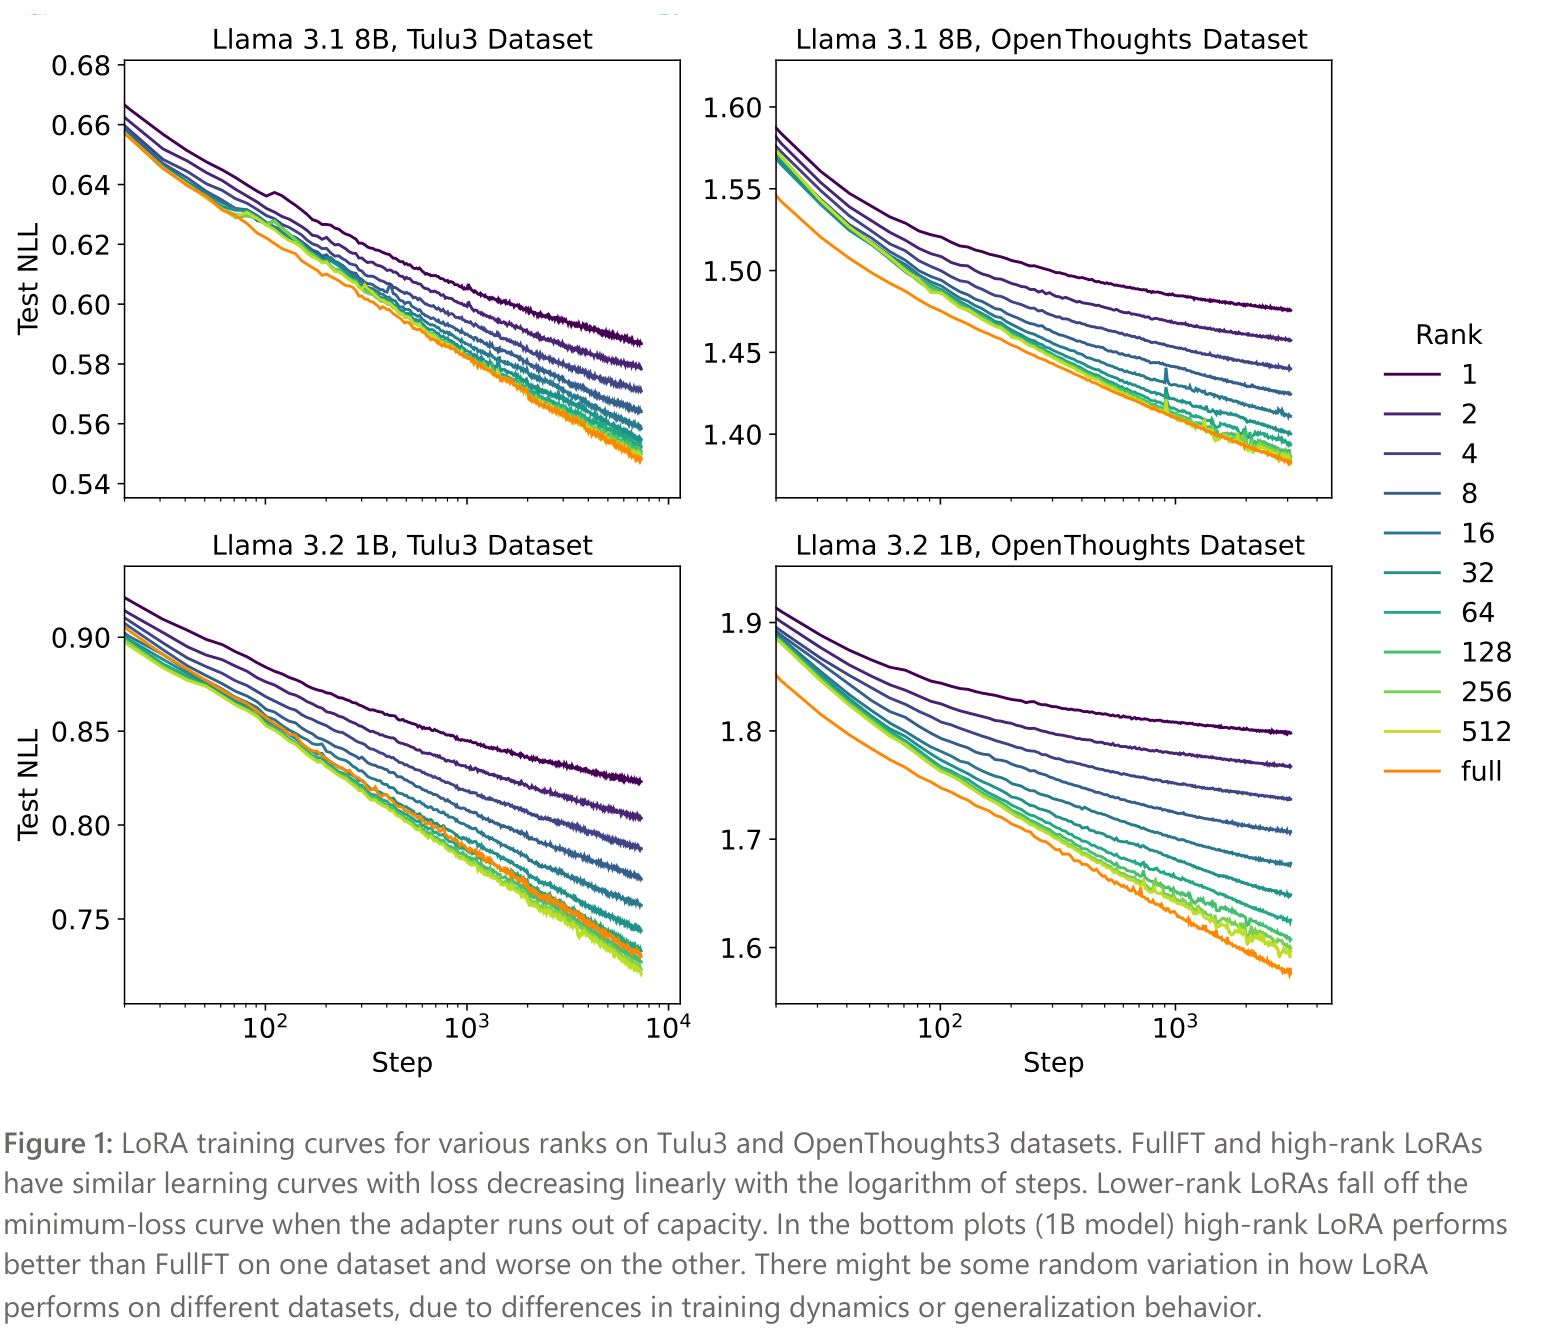
来源:原文 Figure 1,归档 PDF 第 4 页。比较 Llama 模型在 Tulu3 与 OpenThoughts3 上的测试损失,保留面板标题与 rank 图例。
高 rank LoRA 与全参数微调在研究设置中拥有相近的学习曲线。中低 rank 也可能在训练早期接近,但随着样本与训练进展增加,更新容量逐渐不足,学习效率下降。作者特别强调,容量限制表现为曲线逐步偏离,不必表现成突然出现一个完全无法下降的固定损失地板。
因此,训练初期相同不代表长训练后相同。一个小数据集的结果,也不能保证大量新领域知识训练时仍成立。所谓 low-regret 区域取决于需要学习的信息与适配器容量之间的关系,文章没有给出可以精确计算最优 rank 的通用公式。
Rank 增加也不是免费操作。更多参数意味着更多梯度、优化器状态、适配器文件和计算。在相同目标层上扫描 rank,比一开始把 rank 拉满更容易解释收益。若数据重复很多、有效新信息有限,增加 rank 的作用也可能较小,仍需要观察验证集表现。
Batch size:增加 rank 不能解决所有优化问题
原文在 OpenThoughts3 的 10,000 样本子集上比较 batch size。下图左侧展示训练过程,右侧展示最终损失随 batch 改变的趋势。
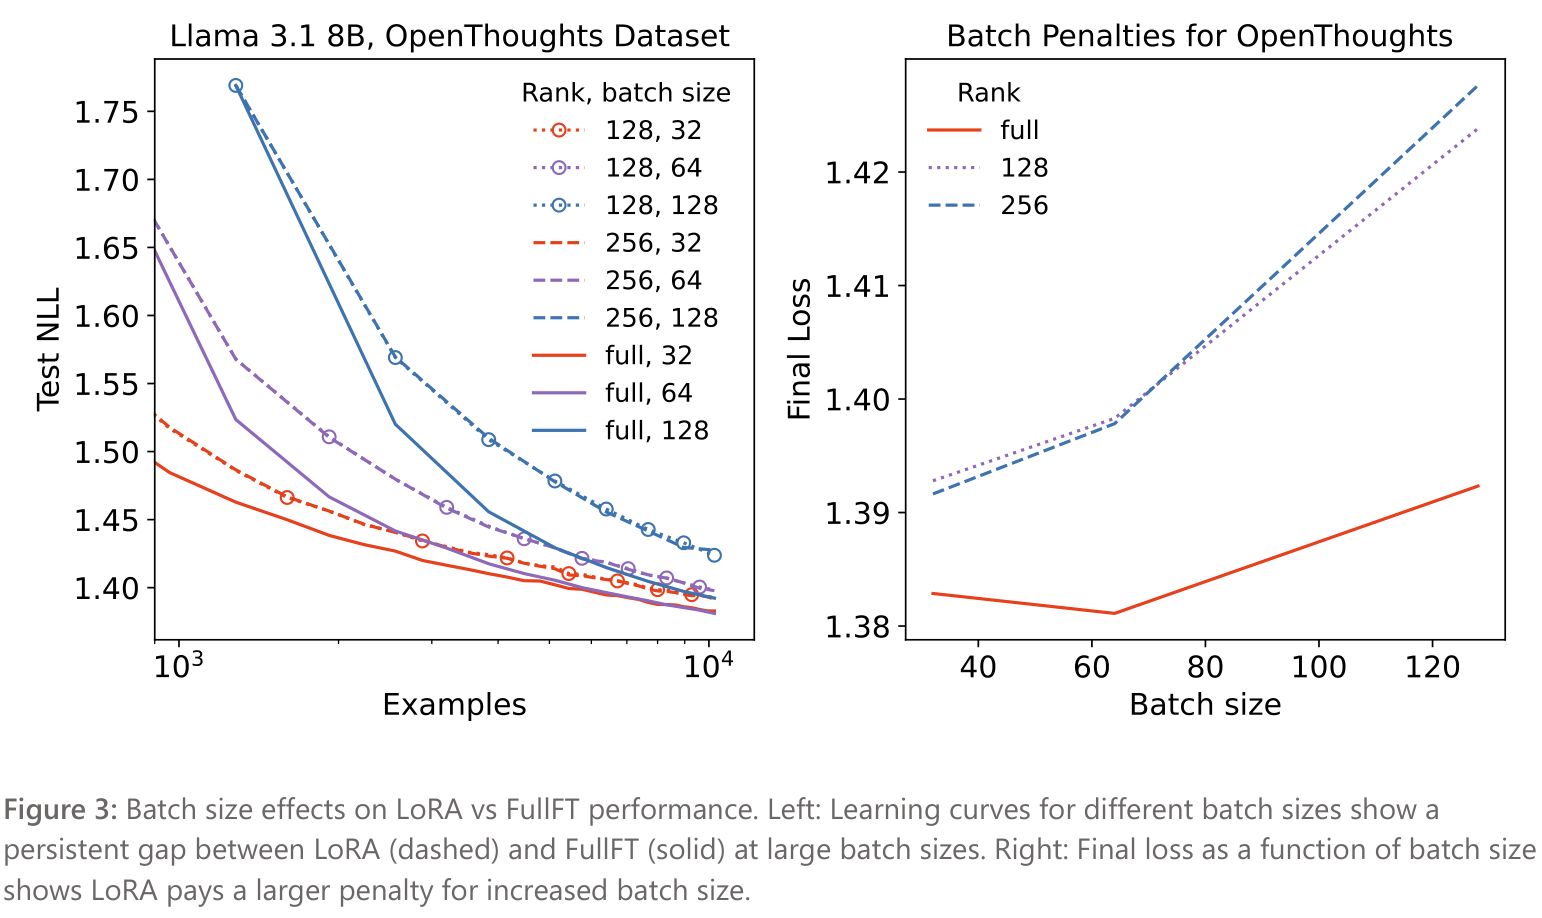
来源:原文 Figure 3,归档 PDF 第 6 页;虚线和实线分别对应 LoRA 与全参数微调,具体颜色和 rank 见图例。
较大 batch 下,LoRA 与全参数微调的差距持续存在;较小 batch 下差距更小,部分设置中会随训练收缩。作者认为这与乘积参数化 BA 的优化动力学有关,增大 rank 没有消除该现象。机制解释属于作者提出的可能原因,不能当作已经证明所有数据集上的结论。
Batch 的单位也要保持一致。LLM 样本长度差异很大,样本数、token 数、梯度累积和有效更新次数都可能改变训练。比较时应同时记录有效 batch、目标 token 与更新步数,不能只报告每张卡的微批大小。
这给出了一个排查顺序:先检查目标层和学习率是否合理,再观察 batch 是否造成学习效率损失,然后才判断 rank 是否不足。把所有差距都归因于低 rank,会错过与参数化和优化有关的问题。
目标层:只覆盖注意力可能限制学习
LoRA 常被挂在注意力投影上,但文章比较了 attention-only、MLP-only 与更广覆盖。原文图 4 同时给出 dense 与 MoE 模型结果:
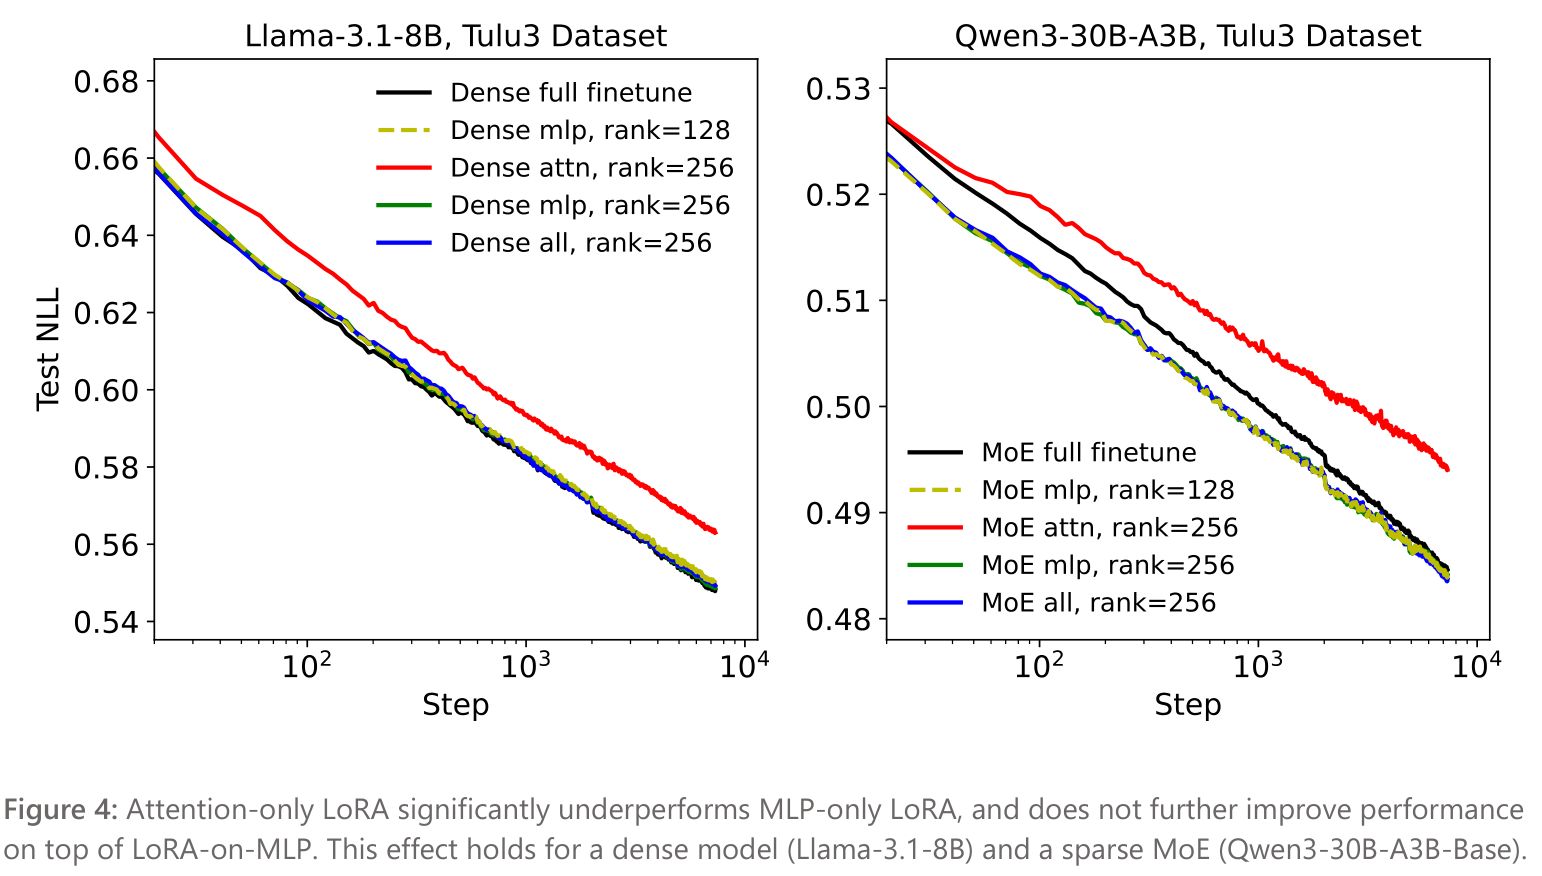
来源:原文 Figure 4,归档 PDF 第 7 页。左侧为 Llama-3.1-8B,右侧为 Qwen3-30B-A3B,均在 Tulu3 任务条件下比较。
Attention-only 明显落后于覆盖 MLP 的设置。作者还比较了参数量相近的条件,避免将差距完全归因于可训练参数总数。Llama-3.1-8B 中,attention rank=256 约有 0.25B 参数,MLP rank=128 约有 0.24B;后者仍学习得更好。对应模型与层定义不能省去,这些数量并非所有 8B 模型的统一参数量。
原文 Llama-3.1-8B 设置 | 可训练参数量 |
|---|---|
MLP,rank=256 | 0.49B |
Attention,rank=256 | 0.25B |
All,rank=256 | 0.70B |
MLP,rank=128 | 0.24B |
这些实验支持先检查是否覆盖了包含大量参数的 MLP 或 MoE 层。作者在若干设置中发现,MLP-only 与 MLP 加注意力相近,额外加入注意力没有继续带来明显收益。它不能推导为所有任务都应该移除注意力适配器;任务、底座和预算改变后仍需对照。
MoE 实验还需要说明 rank 的口径。作者对各 expert 使用独立适配器,按活跃 expert 数对单个 expert 的 rank 做缩放,使参数比例更可比。专家并行、张量并行和适配方式仍是原文列出的开放问题。直接将 dense 模型的目标层字符串复制到 MoE,不保证得到相同实验条件。
讨论部分用经验神经切线核解释目标层影响:小幅微调下,梯度内积决定样本间的局部学习关系,包含多数参数的层对这一关系有很大影响。覆盖这些层时,LoRA 与全参数微调的近似更接近。作者给出的是解释路径,读者应将它与实验事实分开,避免把近似当作任意训练规模下的严格等价证明。
数学 RL:为什么很低的 rank 也能有效学习
原文的数学 RL 使用基本策略梯度目标与重要性采样修正,并采用类似 GRPO 的组内奖励中心化。对同一道题采样多个答案,减去组内平均奖励,得到用于更新的 advantage。
可以将原文目标整理为:
分子来自更新中的策略,分母来自生成样本的策略,比例用于修正分布差异。A_t 表示 advantage,衡量当前样本相对比较基准的奖励。模型采样、奖励计算和梯度更新是不同步骤,LoRA 只是将梯度更新限制到适配器参数。
作者在 MATH 与 GSM 数学任务上用 Llama-3.1-8B base 比较,避免部分 Qwen 模型已有强数学预训练能力使新增学习难以区分。在这些条件下,甚至 rank=1 也能接近全参数微调的峰值表现。这里的结论需要保留噪声范围,原文没有证明每个 rank 在每次训练中都精确相同。
进一步实验使用 Qwen3-8B-Base 与更大、更难的 DeepMath 数据,将训练和评估的采样长度限制到 8192 token。下图的学习曲线为每个设置选择效果最好的学习率,右图显示学习率范围。
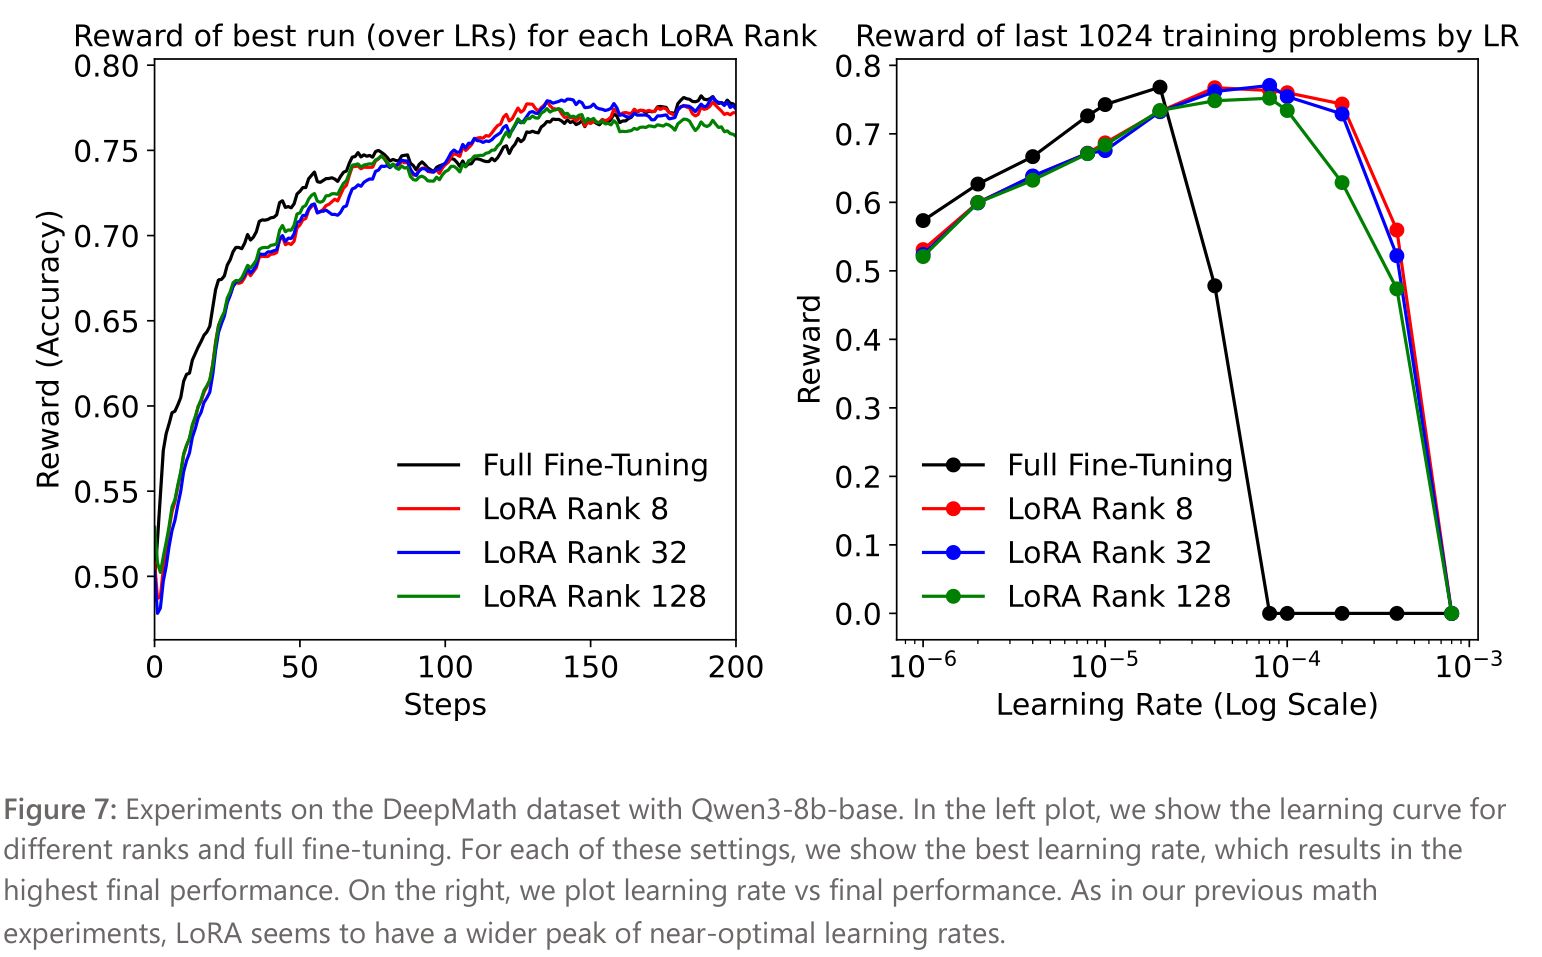
来源:原文 Figure 7,归档 PDF 第 10 页。底座、数据和长度限制见原文 Reinforcement learning 部分。
调好学习率后,不同 rank LoRA 与全参数微调表现接近,LoRA 的有效学习率区间在图中较宽。作者还在留出的 AIME 2024 与 2025 题目上观察到类似结论:
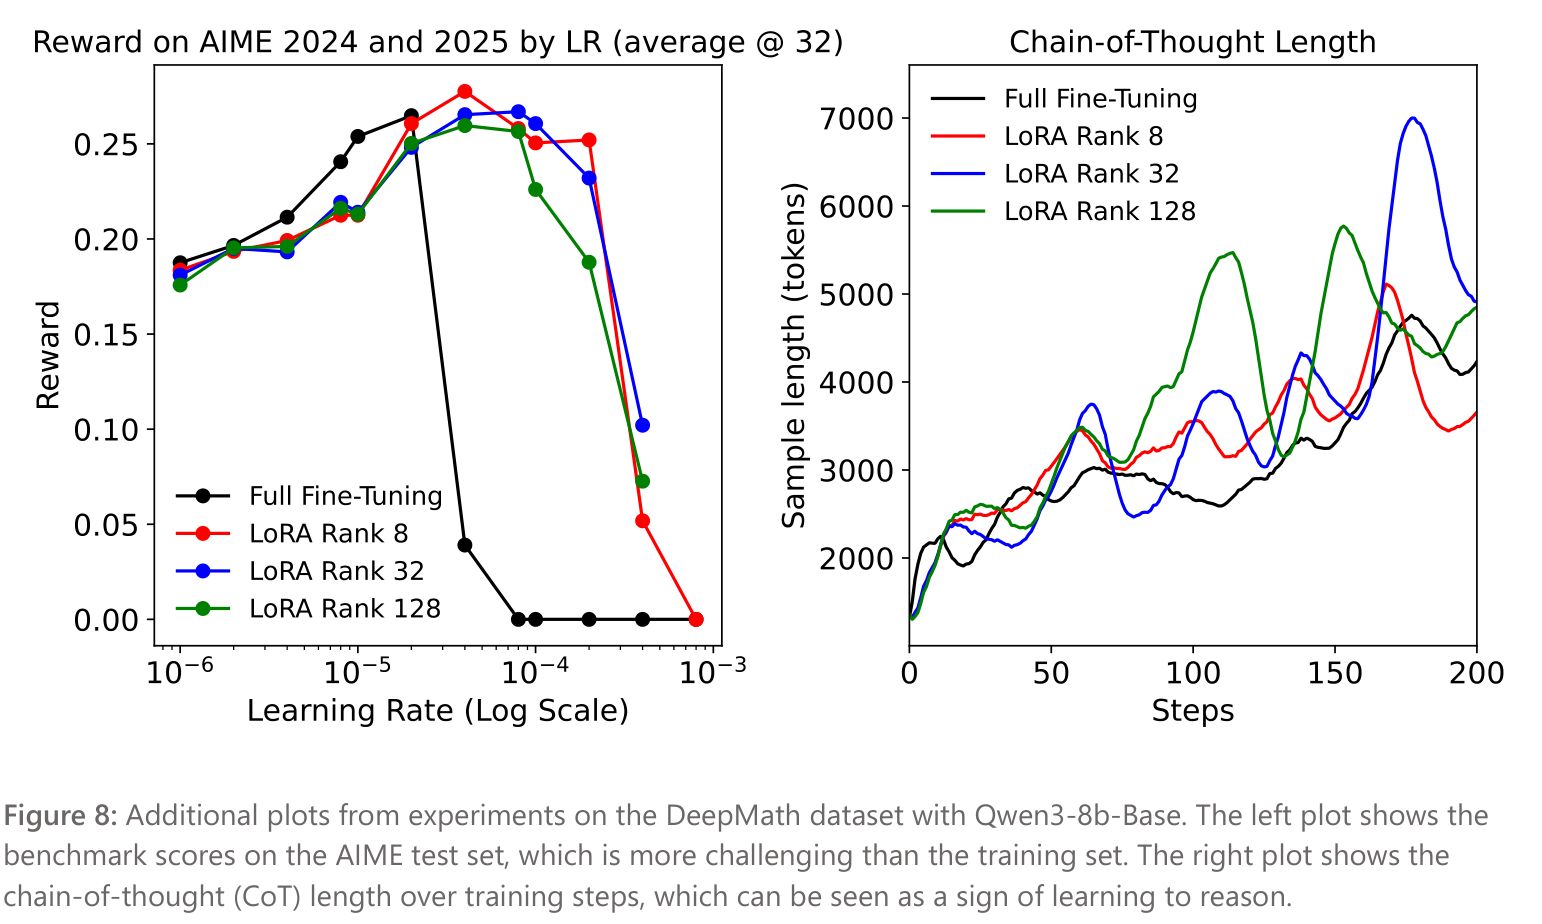
来源:原文 Figure 8,归档 PDF 第 10 页。左侧是 AIME 评价,右侧是训练过程中生成轨迹长度,不能把长度增长单独当作推理能力的充分证明。
信息量论证的适用范围
作者提出,监督序列提供的信号随目标 token 数增加,而只使用末端标量奖励的策略梯度,每个 episode 新获得的监督信息较少。以约 10,000 道 MATH 题、每题 32 个样本为例,若每次答案只提供一 bit 成败信息,得到约 320,000 bit;rank=1 的相关适配器已经有约 3M 参数。作者据此解释更新容量为何可能足够。
参数不是与 bit 一一等价,现实数据也有冗余。文章讨论的容量计算是估计,不是决定 rank 的可靠计算器。原文还明确,RL 的信息量说法限于相应策略梯度信号,模型式 RL 或其他更丰富监督可以从轨迹提取更多信息。
进一步分析在给定训练历史与当前策略的条件下,梯度估计中依赖未知奖励函数的部分来自 advantage。若 advantage 量化到 M 个区间,其熵至多约为 log₂ M,因而限制每条轨迹新增奖励相关信息。原文中的区间变量与 LoRA 矩阵 B 同名,本文改记为 M 以免混淆。
这条论证也有失败边界。如果当前策略从来得不到有区分度的奖励,advantage 不提供有效变化,容量再充足也无法保证学习。长轨迹、多轮工具过程、密集奖励或多模态监督,可能改变信息结构。因此 rank=1 数学 RL 结果不能变成所有 Agent 训练的默认 rank。
学习率、α 与初始化要一起理解
α/r 为什么减弱早期 rank 依赖
原文使用 α=32 和标准 α/r 参数化。BA 可以拆成 r 个 rank-1 外积相加,除以 r 后形成平均。在各分支采用与 rank 无关的初始化条件下,首次更新的期望可以近似保持同一量级。
这个表达解释早期学习曲线为何接近。它没有保证整个长训练过程与 rank 无关:A 和 B 会共同变化,容量限制也会逐渐出现。文章观察到较长训练中仍存在 rank 相关性,极小 rank 的最优学习率与其他设置略有不同。
改变缩放约定会改变这个比较。若更换 α、使用其他 rank 缩放方式,或者对 A 与 B 使用不同学习率,原文同一配置下的经验比例不能原封不动复制。检查框架最终采用的参数化,比只看配置里一个数字更重要。
参数化不变性:哪些超参数实际上耦合
原文考虑四个量:α、A 的学习率 η_A、B 的学习率 η_B,以及 A 的初始化尺度 s_A;B 从零开始。作者在 Adam 且 ε=0 的分析条件下给出一种两参数变换。对正数 p、q:
适配器表示和更新可以在这些变化中保持相应训练动力学不变,因此四个表面参数中包含冗余自由度。原文选择的两个解释量是初始更新规模 α·s_A·η_B,以及 A 显著偏离初始化所需的时间尺度 s_A/η_A;这里把 rank 视为固定条件。
这有助于理解为什么只调 α、只调某个学习率,可能同时改变有效更新幅度与学习时间尺度。实际 Adam 的 ε、正则和实现细节可能偏离分析条件,文章中的不变性不能自动保证所有训练代码具有完全相同轨迹。
作者使用标准随机 A、零 B、相同 A/B 学习率和 α=32,没有在其试验中找到优于这组默认参数化的设置。这不表示 LoRA+ 等变体没有价值,文章仍把其他初始化方法和 MoE 适配方式列为待研究问题。
10 倍学习率是实证起点
文章在其 SFT 与 RL 扫描中观察到,LoRA 的最优学习率常约为对应全参数设置的 10 倍。基于 14 个 Llama 与 Qwen 模型的 Tulu3 扫描,拟合得到 LoRA 系数约为 9.8;不同模型族对 hidden size 的依赖不同。
作者没有给出充分理论解释该固定比例的结论。短训练还有约 15 倍的初步观察,较长训练接近 10 倍。B 从零开始时,初期主要通过 B 改变更新矩阵;随着 B 增大,A 的改变开始产生更大影响,等效学习速度会发生变化。
因此可以把已知合理的全参数学习率与 10 倍附近作为扫描线索,同时扫描邻近值,观察验证损失与任务结果。它是研究条件下的经验,不是任意模型、优化器、数据和量化配置的强制倍数。
约三分之二 FLOPs 是怎样得到的
考虑原文用于推导的 N×N 权重。前向 Wx 需要 N² 次乘加,反向传播到输入需要另一次同量级矩阵运算,计算原权重梯度又需要一次,总计约 3N²。
冻结 W 后仍需要前向和输入梯度,但省去了完整权重梯度。A 和 B 各自的前向与反向增加约 3Nr,合计:
当 r 远小于 N,比例略高于三分之二。这是主矩阵计算的理论计数。通信、激活、优化器、内核效率、量化和 RL 中的采样开销都会影响墙钟时间,因此不能据此直接宣称训练耗时减少三分之一。
一个教学算例使用 1024×1024 权重与 r=8。全权重有 1,048,576 参数,A/B 共 16,384 参数;原文计数模型中的 FLOPs 比约为 0.682。参数规模减少幅度远大于 FLOPs 减少幅度,说明显存与算力收益要分别测量。该算例不代表实际某个模型的整机测试。
怎样为自己的微调建立有解释力的对照
先固定底座、tokenizer、数据版本、目标 masking、训练长度和验证集。检查适配器是否真正覆盖预期层,并确认可训练参数统计与配置一致。训练格式不一致或目标 mask 错误,可能比 rank 更早决定结果。
然后设置一组预算可承担的 rank,与包含 MLP 的目标层进行对照。如果能运行全参数微调,可将它作为参考;无法运行时,也可以比较不同目标层和容量配置,保持对结论范围的说明。
学习率应随参数化一起记录,包括 α、缩放方式、A/B 学习率、初始化和优化器。不同设置均进行合理扫描,避免让单个坏学习率主导比较。Batch 扫描再判断优化问题,容量扫描观察长训练曲线是否持续拉开。
观察到的问题 | 可以优先检查的变量 | 需要保留的证据 |
|---|---|---|
早期就明显落后 | 目标层、学习率、初始化与训练格式 | 前期验证曲线、实际可训练参数 |
早期接近,后期偏离 | rank 与有效数据容量 | 同 token 或更新步数的曲线 |
增大 rank 仍无法缩小差距 | batch 与优化动力学 | 学习率和 batch 的联合对照 |
损失好看,任务表现差 | 评价口径、数据分布与实际目标 | 独立任务结果、回归任务 |
RL 没有进展 | 奖励区分度、采样与基座能力 | rollout 奖励分布、组内 advantage |
Agent 微调还应测工具格式、参数正确性、多轮任务完成与错误恢复。主监督结果在 log loss 上相近,并不保证这些维度都相同。领域数据之外保留已有可靠任务,检查适配器是否改变通用行为。
本文没有在你的模型上运行上述实验。可先选择一个代表性数据子集,完成目标层、学习率和容量的基础对照,再决定是否扩大训练。最终配置应由验证曲线与独立任务共同支持,不能仅凭文章标题或某一张最优曲线选择。
来源与复读位置
Thinking Machines 原文,2025-09-29,DOI 10.64434/tml.20250929。基础设置、rank、batch 与层选择见归档 PDF 第 1—8 页。
数学 RL 与 DeepMath/AIME 结果见第 8—11 页;α/r、参数化不变性、学习率拟合与训练长度见第 11—15 页。
eNTK、信息量范围、FLOPs 推导和开放问题见第 15—18 页。本文保留其近似与实验边界,没有把信息量估计当作 rank 预测定律。
Hugging Face TRL 配套指南可用于定位复现实验。实现细节需匹配实际使用版本,本文未声称运行该指南。