
AgentBench: Evaluating LLMs as Agents 论文阅读
摘要
梳理 AgentBench 八种环境、固定权重总体分数、历史截断与五类终止原因,区分网页单步指标和完整任务、正常结束和成功,并说明如何建立可复核的 Agent 评测。
模型能回答一道题,仍可能在执行任务时选错动作、忽略反馈,或者在多轮交互中丢失目标。AgentBench 把评测放进环境:模型接收任务和观察,提出动作,环境返回新状态,最后按实际结果计分。它把操作系统、数据库、知识图谱、游戏和网页任务放进共同的评测框架。
这篇论文最值得学习的是如何定义 Agent 的任务、指标与失败。八个环境使用不同计分方式,总分通过固定权重归一化;终止原因另外记录格式错误、非法动作和超出轮次等问题。这样既能比较所测模型,也能定位一个任务失败在接口、推理还是长期执行过程。
论文信息与评测范围
项目 | 信息 |
|---|---|
论文 | AgentBench: Evaluating LLMs as Agents |
作者 | Xiao Liu、Hao Yu、Hanchen Zhang 等 |
阅读版本 | arXiv:2308.03688v3,2025 年 10 月 4 日 |
发表信息 | ICLR 2024,见 PDF 首页 |
本版覆盖 | 8 个环境、29 个 API 或开源模型 |
资料 |
阅读版本在原论文之后更新,表中包含 Claude 3 Opus 和 GLM-4 等追加结果。模型成绩对应论文中的特定版本与协议,不是当前模型排行榜。
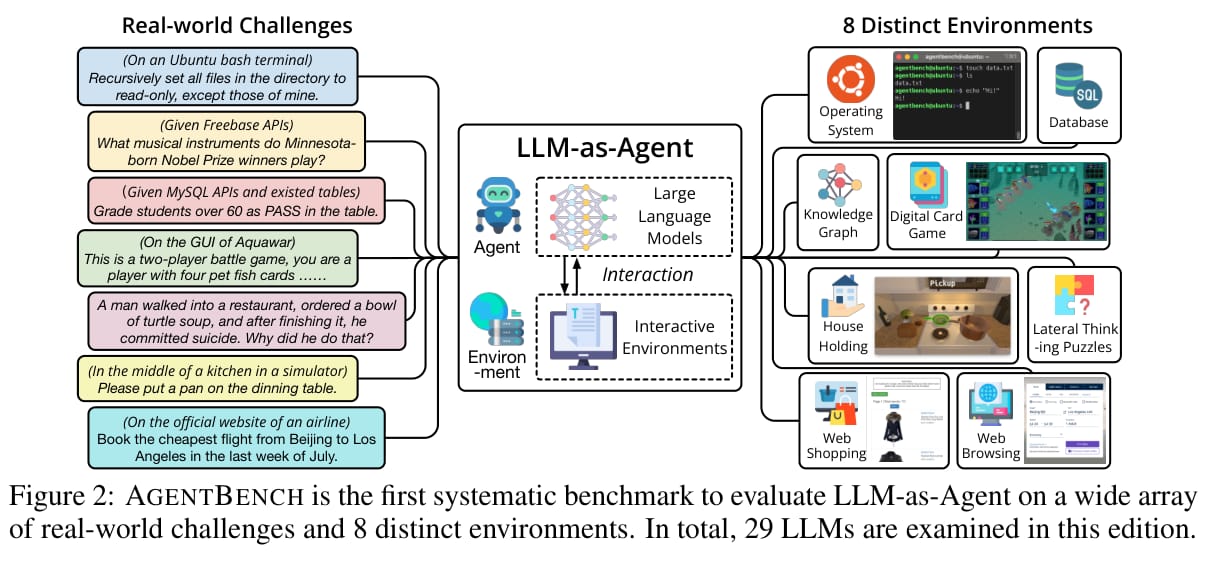
图源:原文图 2,PDF 第 2 页。中间是模型与环境的观察—动作循环,两侧是任务和环境类型。评测聚焦文本输入的语言 Agent,并不统一测试视觉、机器人控制或长期多 Agent 协作。
一次交互评测比静态问答多了什么
论文把任务描述成部分可观察的决策过程。环境有真实状态,Agent 只能得到部分观察,再从允许的动作中选择下一步。动作改变环境,返回新观察,直到结束或超出限制。
因此,答案格式只是第一层条件。命令能够解析,不代表执行合法;执行合法,也不代表达到了任务目标。例如,数据库任务可能要求修改记录,最终检查需要判断表中状态,而不只比较一段 SQL 文本。
AgentBench 为不同模型使用较简单的 CoT 与动作提示,不增加复杂搜索、多次完整尝试或反思策略。主评测关注底座在统一代理协议中的表现。若另外接入技能库、工具选择器或搜索,应单独报告系统配置,不能直接把成绩当作底座自身能力。
八个环境的指标各有含义
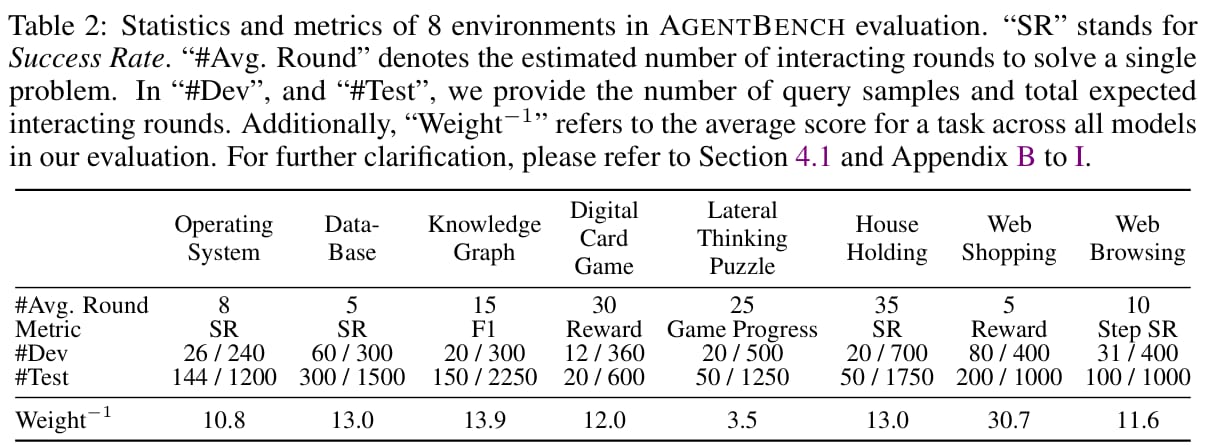
图源:原文表 2,PDF 第 6 页。样本数和预计交互轮次并列给出,Weight 的倒数是用于归一化的任务参照均值。
环境 | 任务侧重 | 表 2 的主要指标 | 测试样本 |
|---|---|---|---|
OS | 在 Ubuntu 环境查询信息或执行操作 | 成功率 SR | 144 |
DB | 用 SQL 查询或改变数据库 | 成功率 SR | 300 |
KG | 用接口在知识图谱上求解问题 | 答案 F1 | 150 |
DCG | 理解卡牌规则并选择对战行动 | Reward | 20 |
LTP | 通过提问推进海龟汤谜题 | 游戏进度 | 50 |
HH | 在 ALFWorld 完成家庭任务 | 成功率 SR | 50 |
WS | 在 WebShop 搜索并选择商品 | Reward | 200 |
WB | 根据网页状态选择元素和操作 | 单步成功率 Step SR | 100 |
开发集共有 269 个样本,测试集共有 1,014 个样本。表 2 的预计平均轮次约为 5—35 轮,完整评测需要比样本数更多的模型调用。使用前应同时查看每种环境的上限与终止逻辑。
特别需要区分网页的单步与整项任务。附录 I 说明,Step SR 检查当前步骤的元素和操作是否正确;Task SR 要求整个序列全部成功。表 3 中 GPT-4 的 WB 29.0 是主要单步指标,不能写成 29% 的网页任务全部完成。
网页任务使用 HTML 快照和候选元素筛选,再让模型选择操作。它与在任意实时网站上独立浏览、完成真实交易的全流程条件不同。评测结论应保留候选筛选和资料形式。
提示词和历史截断也是协议的一部分
AgentBench 用 user 消息传递任务和环境反馈,用 agent 消息传递思考与动作。对于只能进行文本续写的模型,程序加上角色前缀和输出提示。所有主评测采用 temperature=0。
历史过长时,协议保留初始指令和较新的消息,将输入控制在约 3,500 个估算 token 内,并加入消息省略提示。估算方法与模型实际 tokenizer 并不相同,因此不能把它理解为每个模型严格使用相同数量的真实 token。
这项设计让多种模型能够进入同一评测,也会改变 Agent 获得的历史证据。较早的失败尝试或环境发现可能被截去。因此,失败分析既要查看模型行为,也要查看该轮实际发送了哪些消息。
总分 4.01 为什么不是成功率
八个任务的原始指标和难度不同,直接求平均可能让较容易或分数较高的环境主导排名。第 4.1 节用参照模型集合在每个环境上的平均分建立归一化权重,再固定这些权重。
设模型在环境 的得分为 ,对应参照均值为 ,总体分数可以写成:
只要各分数采用同一量纲,这与按固定倒数权重计算平均一致。某个环境的归一化分数高于 1,表示超过该环境的参照均值。总分没有 100% 的上限,也没有“全部任务有多大比例完成”的直接解释。
表 1 的星号标明一些模型在任务权重确定之后追加评测。新增模型沿用固定权重,有助于保持分数可比。若自己重新计算全部均值,需要声明这会改变总体分数定义。
分环境结果比单一排名更有用
原文表 3 中的部分结果如下,分环境数值保留表中的百分制或分数尺度。
模型版本 | OA | OS,SR | DB,SR | HH,SR | WS,Reward | WB,Step SR |
|---|---|---|---|---|---|---|
gpt-4-0613 | 4.01 | 42.4 | 32.0 | 78.0 | 61.1 | 29.0 |
Claude 3 Opus | 3.11 | 22.9 | 51.7 | 70.0 | 27.9 | 26.0 |
GLM-4,论文标注版本 | 2.89 | 29.2 | 42.3 | 34.0 | 61.6 | 27.0 |
gpt-3.5-turbo-0613 | 2.32 | 32.6 | 36.7 | 16.0 | 64.1 | 20.0 |
GPT-4 的总体分数较高,却没有在每个环境都最高。Claude 3 的数据库成绩更高,GPT-3.5 在所列 WebShop 指标中也高于 GPT-4。应用选择应看相关环境和协议,再做自己的验证。
论文中较强的 API 模型与所测、不超过 70B 的开源模型存在差距。这是所选模型集合中的观察,不能推广为所有时间、所有开源模型的能力边界。模型训练资料、输出格式、上下文管理和任务分布都影响结果。
正常结束与成功应分开统计
论文定义五种典型终止情况。
类型 | 含义 | 排查方向 |
|---|---|---|
CLE | 上下文长度超出模型限制 | 实际输入、截断规则与上下文容量 |
IF | 输出不符合约定格式 | 格式指令、结构化输出与解析 |
IA | 格式正确,但动作不合法 | 动作范围、参数和当前状态 |
TLE | 达到任务轮次上限或长期重复 | 计划、状态更新、反馈使用和预算 |
Complete | 交互正常结束 | 继续检查任务自己的最终评分 |
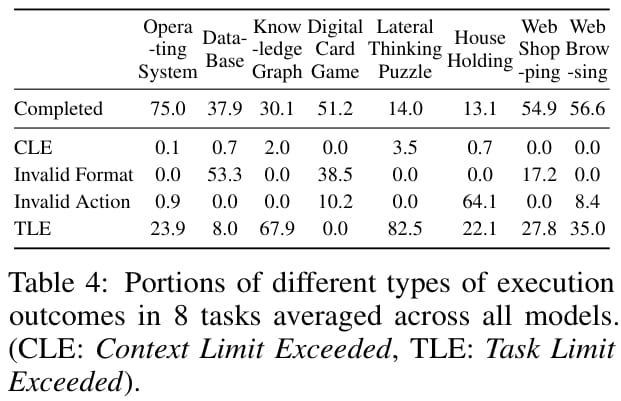
图源:原文表 4,PDF 第 8 页。比例在所测模型之间平均,不能用它替代某个模型的失败分布。Completed 表示正常结束,不保证目标达到。
数据库的格式错误比例为 53.3%,家庭环境的非法动作比例为 64.1%,海龟汤的任务上限超出比例为 82.5%。同样的“任务失败”,对应不同的改进方向。
格式错误高时,先检查接口契约。非法动作高时,需要检查当前可用动作和状态约束。超出轮次可能来自探索困难、反复执行无效计划,也可能来自预算设置。不能仅根据 TLE 标签认定模型完全没有推理能力。
评测工具怎样支持多环境运行
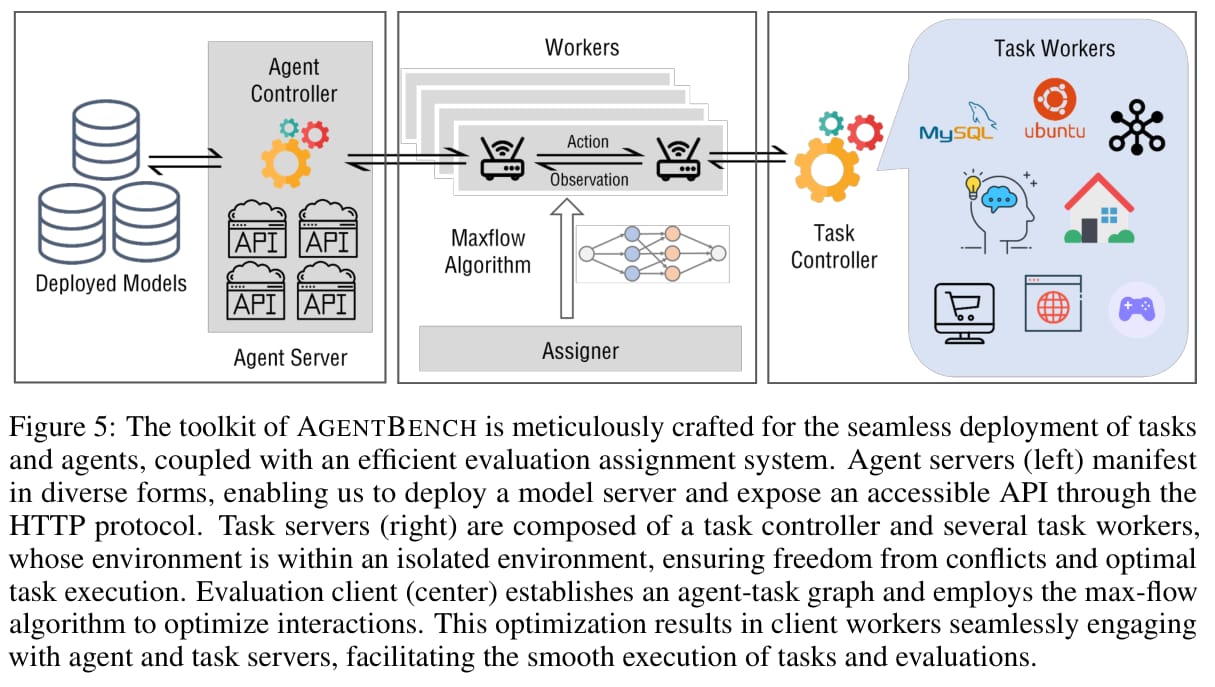
图源:原文图 5,PDF 第 21 页。模型接口与任务环境分开部署,通过 HTTP 连接。客户端分配任务,任务执行器保留环境隔离。
附录 A 将工具拆成 Agent Server、Task Server 和 Evaluation Client。模型端提供推理接口,任务端提供环境和检查,客户端安排评测组合。复杂环境用 Docker 等方式隔离,减少依赖冲突。
客户端还用最大流分配不同模型和任务执行器的工作量,并提供中断后恢复评测的能力。这些设计服务于评测吞吐与可恢复性,没有改变模型本身的推理过程。
对自己的项目,可以借鉴这种分离:环境初始化与最终检查独立,Agent 只通过声明的接口行动,轨迹保存实际输入、动作、反馈和结束原因。模型与工具升级后,旧任务仍能按同一协议重跑。
怎样用它建立自己的评测
先选与实际业务接近的任务,并定义初始状态、可用动作、最终验收和预算。若任务是“生成并保存一份结果”,需要检查结果内容及保存状态,不能只检查 Agent 是否输出结束标记。
其次固定模型版本、提示词、历史管理、候选工具和重试策略。比较新组件时,只改变该组件,并把调用成本和时延一起报告。加入 Reflexion、搜索或多角色协作后,应称为完整系统评测,另列原始协议的成绩。
最后保留失败分类和代表轨迹。一个总体分数用于快速比较,一张分环境表用于理解任务差异,具体日志用于定位原因。以上是从 AgentBench 协议延伸的项目做法,本文没有重新运行基准。
限制与阅读重点
AgentBench 覆盖八种文本环境,仍无法包含全部真实工作。网页快照、模拟购物与家庭环境都有各自条件,真实业务还可能遇到工具故障、权限变化和未见状态。受限基准上的成功不能直接等同于持续生产可用。
论文对代码训练、对齐资料和参数规模的分析,也包含跨模型观察。它们能够提出解释和后续研究问题,但没有完全控制训练数据、架构和优化过程,不能当作单因素因果证明。
这篇论文为前面各种 Agent 方法补上了评测视角:有记忆、反思、搜索或多个角色之后,仍要回答任务怎样计分、在哪一步失败、额外花了多少资源。首次阅读先看图 2、表 2 和第 4.1 节,再读表 4 与相关环境附录,最后用同样的协议审视自己的成功案例。
来源:AgentBench 论文 v3,第 2—4 节、表 2—4、附录 A 与 I。项目日志与组件比较方案属于阅读后的工程建议。