GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning 论文阅读
摘要
完整拆解 GEPA 的反思变异、逐实例 Pareto 候选选择和谱系合并,保留任务反馈、算法细节、预算口径与失败结果,说明提示优化如何接入 Agent 改进。
GEPA 将一次 Agent 或工作流运行留下的文本轨迹转成提示词优化信号。模型如何检索、工具为什么报错、哪些约束没有满足,都可以帮助反思模型提出新的模块指令。优化器再用任务结果检查这些指令是否有效,并保留擅长不同实例的候选,避免只沿着一个平均分最高的方案反复修改。
论文的核心是反思式提示变异、按实例表现选择候选,以及利用演化谱系组合互补模块。模型权重保持冻结,改动发生在系统的提示词集合中。实验说明这条路线在部分任务上有较高样本效率,也保留了数学任务中 GRPO 更好、合并策略可能退化等结果。它适合帮助开发者判断:当前问题能否通过更明确的任务规则与反馈解决,何时仍需要调整权重或系统结构。
信息 | 内容 |
|---|---|
论文 | GEPA: Reflective Prompt Evolution Can Outperform Reinforcement Learning |
作者 | Lakshya A. Agrawal、Shangyin Tan、Dilara Soylu 等;Omar Khattab 等参与 |
来源 | ICLR 2026 Oral;首次预印本于 2025-07,本文读 arXiv:2507.19457v2,2026-02-14 |
阅读范围 | 正文 §1—7,算法 1—4,附录 C—E 的反思、合并、任务和训练设置,以及相关结果说明 |
优化对象 | 由一个或多个 LLM 模块组成的系统的提示词,底座权重冻结 |
输入 | 初始系统、训练任务、评价函数、文本反馈函数和 rollout 预算 |
输出 | 在候选选择集上总体表现最好的提示词系统 |
原文与代码 |
任务奖励中丢掉了哪些可用信息
一个代码 Agent 编译失败,得到奖励 0;另一个 Agent 返回格式错误,也得到 0。两次失败对梯度算法可能表现为相同标量,但环境还包含不同错误位置、模块输出和约束说明。这些文本有助于判断下一次应该修改什么。
论文区分系统执行轨迹与评价轨迹。前者包含模块输入、输出、工具调用和可取得的推理信息;后者来自检查结果,例如编译器错误、失败测试或 rubric。GEPA 将评分之外的这些信息送给反思模型,让它形成新的指令候选。
这种信号需要与真实评测相连。反思模型可以提出原因,也可能误判;文本反馈丰富,不代表建议必然有效。因此 GEPA 在每次修改后重新运行系统,用任务分数决定是否接受候选。反思负责提出改变,执行评价负责检验改变。
系统表示:哪些东西参与优化
论文将复合 AI 系统写成 Φ=(M,C,X,Y)。M 是 LLM 模块集合,C 是控制流,X/Y 是整体输入输出 schema。每个模块包含提示词 π_i、权重 θ_i,以及模块自身的输入输出定义。
例如一个多跳问答系统可以有查询生成、检索、材料摘要和最终回答模块。第二跳查询模块输入原问题与第一跳摘要,输出新的查询;控制流将它交给检索器,再把新材料送到回答环节。
所有模块的提示词组成 Π,权重组成 Θ。论文用统一目标讨论提示与权重优化,以便比较不同方法:
x 是任务输入,m 是评价元数据,例如正确答案、rubric 或测试;μ 返回任务分数,B 为运行预算。GEPA 实际只修改 Π,Θ 固定。GRPO 等比较方法则在权重空间优化。系统定义、评价与预算需要共同记录,不能只根据最终分数判断哪种优化方式总是更好。
Rollout 在本文中指一次系统运行及其评价,不等于一次底座调用。复合系统的一次 rollout 可能包含多个模块和工具。反思模型本身还会被额外调用,因此 rollout 数少不自动等于全部 token、时间或费用同比下降。
GEPA 的一轮优化如何执行
下图把候选池、评分矩阵、反思变异和合并接到同一循环。先跟踪中间的训练小批与新候选,再看左侧候选选择如何为下一轮提供起点。
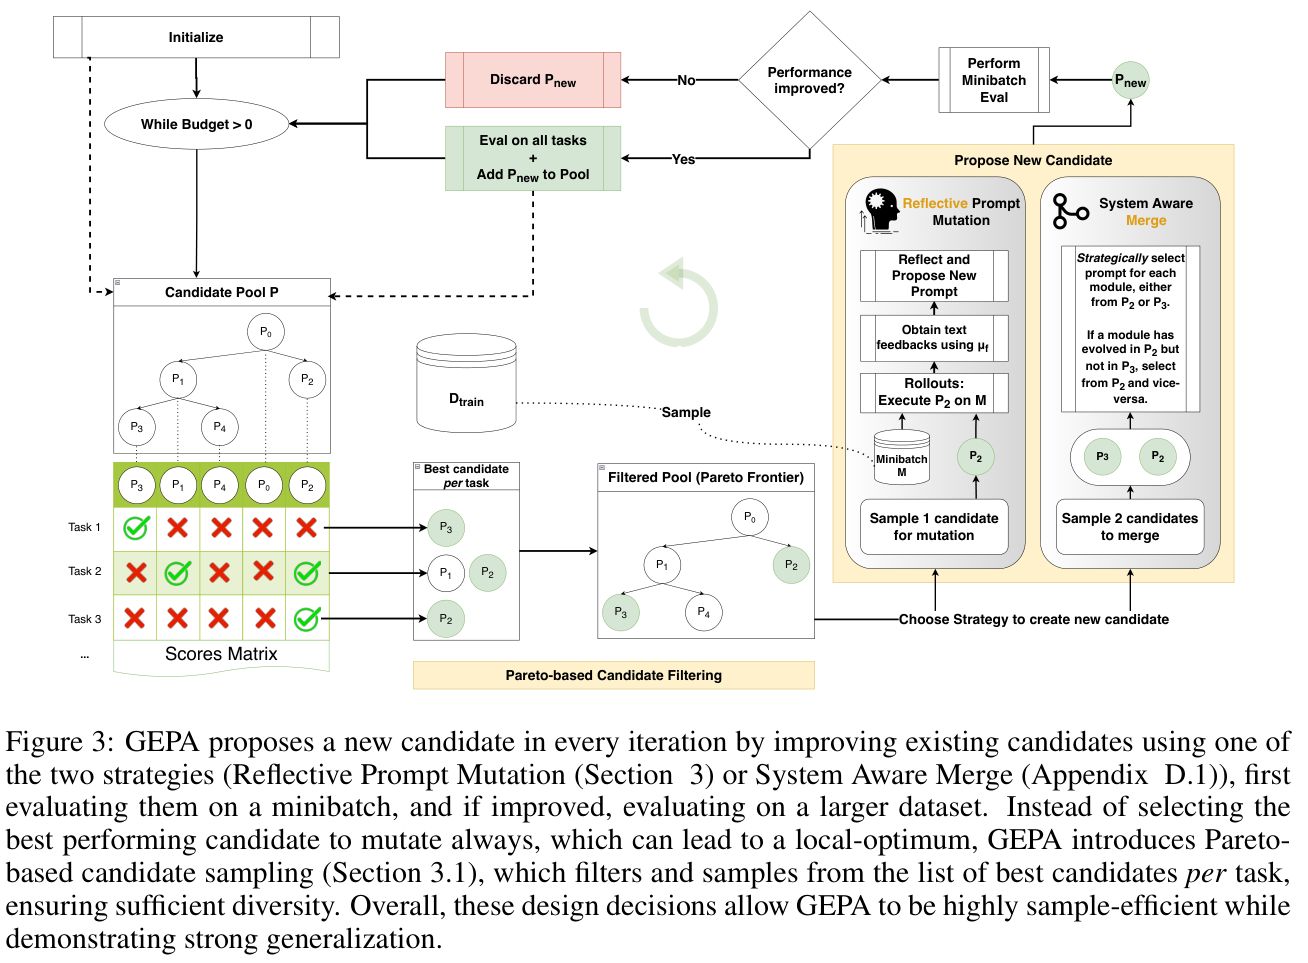
来源:论文 v2,Figure 3,PDF 第 5 页。
初始化候选与两类任务用途
初始候选池 P 只含种子系统。优化器先记录它在候选选择集上的逐实例分数,再进入演化循环。算法区分 D_feedback 与 D_pareto:前者提供轨迹和反馈,用于生成新指令;后者提供选择分数,用于保留候选与最终选择。
论文实验使用训练集作 D_feedback、验证集作 D_pareto。反思阶段可以读取训练内容与反馈,验证内容不直接送进提示词生成过程;分数仍会被反复用于搜索选择。最终测试集单独保留,检查未见实例上的泛化。
候选选择集需要支付执行成本。原文指出,GEPA 很大一部分 rollout 花在验证而非反思采样。这也是它把评价预算作为核心资源的原因,不能只统计发生反思的那几条轨迹。
选一个候选,再选一个模块
从候选池中按实例表现选择演化起点,再按论文的 round-robin 策略选需要修改的模块。这样可以逐步改变不同模块,维持其他部分不变。
只改一个模块有助于解释局部变化,但最终评价仍针对整个系统。查询更好可能提高回答质量,也可能改变后续输入,让其他模块遇到新状态。局部指令看起来合理,仍需端到端检查。
收集轨迹与文本反馈
选中的系统在 D_feedback 的小批任务上运行。反馈函数 μ_f 返回数值与文本,并在可用时给出模块级反馈。多跳检索可以指出哪些相关文档仍未找到;格式任务可以指出满足与违反的约束;代码任务可以保留编译错误。
模块级信号不是所有任务都天然具有。只有最终答案评分时,反思模型需要从轨迹推断责任,归因可能更困难。论文允许人工解释作为辅助反馈,但这也增加了数据和人员依赖。
用反思模型提出新指令
反思输入包含当前模块提示、任务例子、输入输出、评分和反馈。附录 C 的 meta-prompt 要求理解任务格式、提取领域信息与可泛化策略,再输出新指令。这里的反思调用承担的是候选生成,不产生模型权重更新。
原文图 2 给出第二跳检索例子:种子提示只说明从问题与摘要生成查询,优化后的指令要求定位第一跳尚缺的相关实体或更高层概念,并避免简单重复原问题。它把训练中发现的检索失败原因变成可复用规则。
知识也可能被写入提示。若反馈含有训练答案或只有特定环境才成立的细节,新指令可能过拟合。因此应检查学到的是通用策略、必要领域规则,还是某几个训练样本的答案。
先小批比较,再扩大评价
新提示替换选中模块,其余模块和权重保持一致。优化器在相同小批上比较父候选与新候选;小批平均分改进后,再把新系统加入候选池,记录父子关系,并评价 D_pareto。
小批门槛减少明显无效候选的大规模评价成本,但可能受随机性影响。研究使用 minibatch size=3,属于论文设置,不能认为三条样本足以精确证明每次修改有效。需要结合任务噪声与运行预算确定实际检查强度。
预算耗尽后,从候选中选出在 D_pareto 上平均表现最好的系统。优化过程不要求每个新候选都取代当前最好系统,保留不同分支才能为后面的探索与合并提供条件。
按实例维护候选:Pareto 选择的实际细节
对每个选择实例 i,计算候选中的最高分 s_i*,收集达到最高分的候选。将这些候选取并集,再剔除被其他保留候选支配的方案。若一个候选在全部实例上不差、至少一个实例更好,就可以支配另一个候选。
原文策略先要求候选至少在一个实例取得最高分,再做支配检查,因此其选择池具有具体筛选规则。不能把它笼统理解为保存所有数学意义上的非支配点。完成过滤后,按候选在多少实例中进入最高分集合来设置抽样权重。
一个教学例子:候选 A 在三项任务上的分数是 [1,1,0],B 是 [0,1,1],C 是 [1,0,0]。A 与 B 分别覆盖不同成功区域,C 被 A 支配。保留 A、B 后,两者都在两个实例上取得最高分,下一轮有相应机会继续演化。分数仅用于说明算法,不是论文实测。
只按平均分选择可能过早放弃某种尚未成熟的策略。按实例保留使优化器能继续探索局部强项,并可能从中产生整体更好的候选。它仍依赖选择集代表性,少数噪声实例或错误评分也可能影响候选频率。
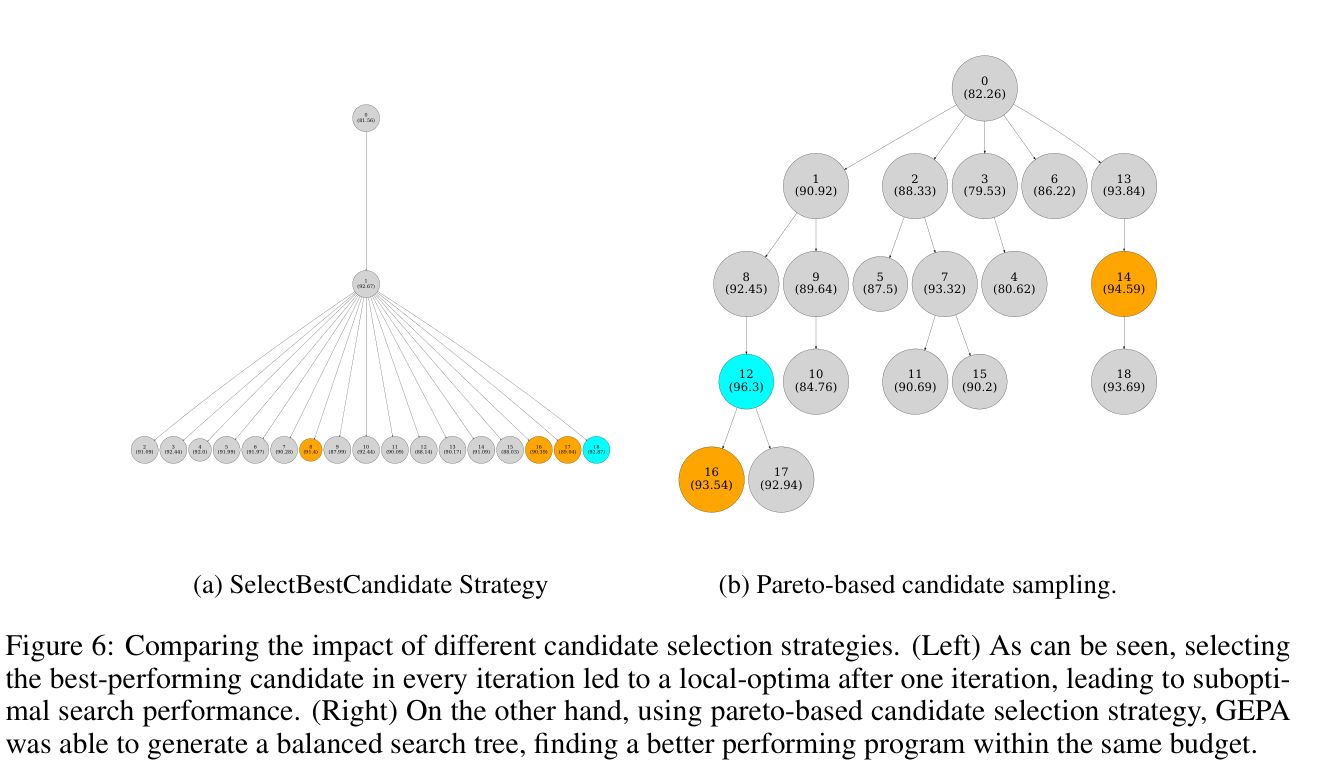
来源:Figure 6,PDF 第 10 页。左侧只演化当前最高分候选,右侧按实例表现进行选择,展示该次实验中的搜索路径差异。
System-aware Merge 怎样组合分支
合并候选需要保存演化谱系。附录 D 的算法寻找具有共同祖先、且不是直接祖先后代关系的两个分支,检查相对祖先的表现,以及是否存在互补的模块改动。已经试过的组合不重复提出。
对于某个模块,若一个分支仍使用祖先提示,另一个分支已改进,则采用改变后的提示;若两个分支都改了同一模块且提示不同,算法按整体候选分数选择其中一个,平分时随机处理;其他情况沿用对应一致提示。它是在模块层面组合提示集合,不是把两段长指令无条件拼接。
举一个教学例子。共同祖先有查询模块和摘要模块。分支 A 改善查询,让检索更精准;分支 B 改善摘要,使关键证据保留更完整。Merge 可以形成查询取 A、摘要取 B 的候选,再重新评价。即使两个局部版本分别有效,组合也可能改变输入分布而失效,所以合并结果不能直接免检。
论文实验最多调用合并 5 次,预算在变异和合并之间分配。作者发现 GPT-4.1 Mini 的合并总体有益,Qwen3-8B 则在一些任务上退化。合并需要足够独立、有互补价值的分支,何时启动与分配多少预算仍是待研究问题。
用伪代码走完整个优化过程
下面依据算法 1—4 整理,只用于教学,省略实现细节,不是已经运行的官方代码。
最后一步的独立测试不参与候选生成。开发时如果根据测试集错误反复改提示,该集合就已经进入调参循环,应另留真正独立的数据检查泛化。
实验使用了哪些任务和反馈
论文的六项任务覆盖不同工作流,反馈内容直接影响反思能获取多少诊断信息。
任务 | 系统与评价对象 | 供优化使用的反馈特点 |
|---|---|---|
HotpotQA | 多跳检索后回答问题 | 提示每跳仍缺的相关文档 |
HoVer | 多跳查询与证据检索 | 已检索和仍需检索的正确文档 |
IFBench | 先回答,再按约束改写 | 哪些格式或指令约束满足/失败 |
PUPA | 隐私保护的请求委托与回答改写 | 回答质量与 PII 泄漏的分项反馈 |
AIME-2025 | 单模块数学推理 | 数学答案评价;旧年份供调参 |
LiveBench-Math | 单模块数学任务 | 相应答案分数与可用反馈 |
HotpotQA 使用 150 个训练、300 个验证、300 个测试样本;HoVer 同样使用这一规模。IFBench 测试包含新的约束类型,训练与验证来自另一份训练数据,帮助检查对未见指令的泛化。PUPA 使用 111/111/221 的划分。AIME 用 2022—2024 年 90 道题分训练和验证,2025 年 30 道题各运行 5 次测试。LiveBench-Math 使用 2025-07-30 获取的数据子集,再做划分。
这些细节说明结果的范围。某些任务具备训练时的文档标签、约束检查或隐私分项评分;自己的无标签 Agent 任务未必能提供同样反馈。测试题重复运行提高了对采样的观察,但没有增加独立数学题的数量。
模型包括 Qwen3-8B 与 GPT-4.1 Mini,推理上下文上限为 16384 token。Qwen 的论文设置使用 temperature=0.6、top-p=0.95、top-k=20,GPT-4.1 Mini 用固定版本与 temperature=1.0。这里记录研究设置,不作为当前接口配置推荐。
主结果支持什么,哪些结果不能省略
下面保留表 1 中的六任务分数。指标按论文任务定义报告为百分制,任务之间含义不同;平均值是作者的汇总方式,不能直接解释成同一种能力的准确率。
Qwen3-8B 方法 | HotpotQA | IFBench | HoVer | PUPA | AIME-2025 | LiveBench-Math | 汇总 |
|---|---|---|---|---|---|---|---|
初始系统 | 42.33 | 36.90 | 35.33 | 80.82 | 27.33 | 48.70 | 45.23 |
GRPO | 43.33 | 35.88 | 38.67 | 86.66 | 38.00 | 51.26 | 48.91 |
MIPROv2 | 55.33 | 36.22 | 47.33 | 81.55 | 20.00 | 46.60 | 47.84 |
GEPA | 62.33 | 38.61 | 52.33 | 91.85 | 32.00 | 51.95 | 54.85 |
GEPA+Merge | 64.33 | 28.23 | 51.67 | 86.26 | 32.00 | 51.95 | 52.40 |
来源:论文 Table 1,PDF 第 8 页。GEPA 汇总较 GRPO 高 5.94 分;在该表的六项任务中,GEPA 有五项高于 GRPO,AIME 低于 GRPO。Merge 提高了 HotpotQA,却在 IFBench 等任务退化,汇总也低于不合并版本。
这个表是理解标题的必要条件。GEPA 能在一些工作流上超过对应 GRPO 设置,不能推出提示优化在所有学习任务上都优于权重更新。数学推理任务与带丰富模块反馈的检索系统,可能具有不同改进空间。
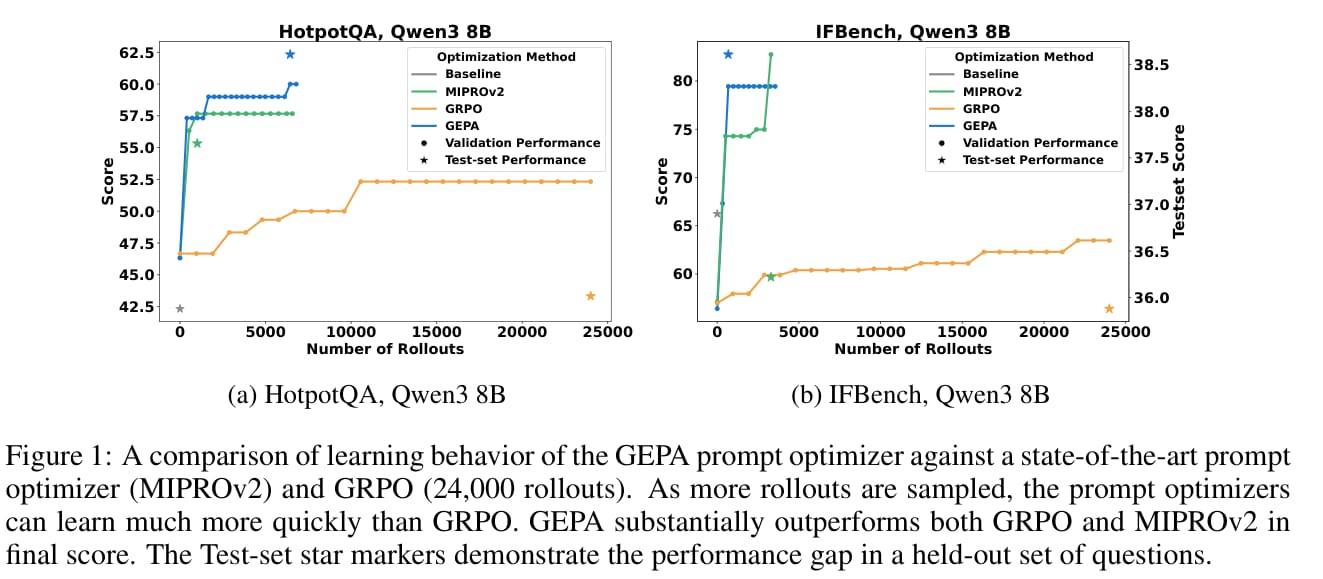
来源:Figure 1,PDF 第 1 页。曲线显示验证表现与测试标记;预算统计需要结合主表和附录理解。
GRPO 比较使用 24,000 rollouts。原文报告 IFBench 的最好提示在约 678 rollouts 时找到,同时表中整个 GEPA 搜索预算约为 3593。最佳候选出现所需预算、完整搜索预算和仅训练反馈预算是不同口径。作者提出的最高约 35 倍样本效率优势属于特定任务与停止位置,不能将它理解为所有任务或所有费用均减少 35 倍。
GPT-4.1 Mini 的表 2 中,初始汇总为 53.03,GEPA 为 65.22,GEPA+Merge 为 66.36,MIPROv2 为 58.67。Qwen 上优化的提示不改动就迁移到 GPT-4.1 Mini,汇总为 62.03。这支持部分任务规则能够跨模型使用,但不保证迁移到你的模型、工具定义或业务任务后仍然有效。
候选选择消融
表 3 保持演化框架一致,在四个 Qwen 任务上改变选择策略。仅选择最高分候选的汇总是 54.89,beam search 为 53.95,GEPA 为 61.28,初始为 48.84。这个消融比跨优化算法主表更直接地支持候选选择的贡献,仍需要保留四任务范围与相同框架条件。
比较中的训练配置与成本
附录中的复合系统 GRPO 使用 LoRA rank=16、α=64、dropout=0.05,覆盖注意力与 MLP 投影;组大小为 12,每步 4 个训练实例,学习率为 1e-5,并使用相应正则、裁剪与调参。另有单模块全参数训练对照,因此作者并未仅比较一个纯 attention LoRA 基线。
GEPA 与 MIPROv2 的预算按任务对齐,实际消耗仍有小幅差异。反思调用、候选评价、提示长度和工具开销应分开记录。原文附录给出 GPT-4.1 Mini 实验的历史费用,例如 GEPA 全部相关任务约 86 美元;这只是作者在当时配置中的成本,不能作为当前报价。
优化后的指令在一些条件下比 MIPROv2 的多示例提示更短,可能降低后续输入成本。但它依然可能形成较长、针对性很强的提示,不能推导为提示越短越好。
推理时搜索与鲁棒性扩展
论文还将 GEPA 用于特定代码任务的搜索:让反馈集与候选选择集包含待解决问题,允许优化器针对这些题反复改进。此时目标是解决给定实例,数据使用口径不同于独立测试泛化。
在早期 NPUEval 实验中,GPT-4o 结合最多十次顺序修正的系统平均向量利用率为 4.25%;加入检索与 MIPROv2 后为 19.03%;GEPA 保留不同任务最优策略时报告 30.52%。这些是特定 AMD NPU 内核任务的利用率指标,需要同时满足功能正确条件,不能解释成一般代码准确率或所有硬件加速比例。
KernelBench 扩展使用 NVIDIA V100、35 个代表任务,报告 fast_p:生成的功能正确内核中,达到相对 PyTorch eager 指定速度条件的任务比例。这些实验仍被作者定位为初步结果。
鲁棒性扩展则反向优化提示,寻找保持题目内容但降低成功分数的干扰。原文 AIME 案例中,GPT-5 Mini 在测试集的分数由 76% 降至 10%;人工检查发现模型经常输出格式占位符。该下降主要揭示干扰信息与严格格式要求的交互,不能直接解释成数学知识全部消失。它可以提供压力测试样本,但不能代替正常分布的能力评价。
怎样应用到自己的 Agent
先把系统拆成具有明确输入输出的模块,记录稳定的种子提示和控制流。选择一组能给出可核验结果的任务,为失败保留具体反馈。查询缺证据、工具格式错误和无效引用,比一句“回答不好”更适合反思。
划分反馈、候选选择与独立测试数据,给搜索设置明确预算。每次修改保存提示版本、运行轨迹、模块身份与逐项分数,检查反思是否把训练答案、隐私数据或不可信工具文本写进指令。优化器产生的提示仍需要符合系统授权边界。
用新的任务检查迁移结果,并与当前人工提示在相同底座和预算下比较。若提示明确化已经解决问题,可以减少不必要的训练;若任务需要大量新知识、模型不能生成有效行动,或能力受底座限制,则继续研究数据、蒸馏和权重更新。
GEPA 与微调可以共同使用,但论文没有证明一种固定组合顺序最优。可以分别测提示优化、权重微调以及二者组合,检查独立任务的质量、回归、输入长度和运行成本,再决定项目采用哪条路线。
来源与关键复读位置
GEPA v2 原文:§2 系统与预算定义,§3 变异与候选选择,Figure 3—4 总览和核心算法,§4 结果与消融,§5 扩展。
附录 C,PDF 第 22—23 页:反思 meta-prompt;附录 D,第 23—24 页:共同祖先与模块合并算法;附录 E,第 23—27 页:反馈、划分、模型与 GRPO/GEPA 设置。
官方代码。本文按所读论文版本解释算法,未运行官方实现,也不将论文历史配置当作当前库的默认值。