
AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation 论文阅读
摘要
拆解 AutoGen 的可对话 Agent、自动回复与对话编程,结合消息拓扑和四组原文实验,核对 MATH、交互检索、ALFWorld、OptiGuide 的指标与比较边界。
模型生成一段代码,执行环境返回错误,模型再根据错误修改代码。这类应用需要管理消息、执行工具、保存上下文和判断结束。如果进一步加入审查者或人工参与者,交互流程会更复杂。AutoGen 把这些参与者统一为可对话的 Agent,用消息往来组织计算与控制流程。
论文的核心是两个抽象:可定制的 Conversable Agent,以及 Conversation Programming。一个 Agent 可以由 LLM、工具、人或它们的组合驱动。系统通过回复逻辑定义双向对话、嵌套咨询、群聊和执行反馈。实验说明这种抽象能够支持多种应用,但成绩取决于具体角色、工具和对话设计,增加 Agent 数量本身并不保证更高质量。
论文信息与架构
项目 | 信息 |
|---|---|
论文 | AutoGen: Enabling Next-Gen LLM Applications via Multi-Agent Conversation |
作者 | Qingyun Wu、Gagan Bansal、Jieyu Zhang 等 |
阅读版本 | arXiv:2308.08155v2,2023 年 10 月 3 日 |
贡献 | 可对话 Agent、对话编程与多种应用实现 |
资料 |
本文解释 2023 年论文中的框架和接口名称。它们用于理解方法,复现时需要对应论文时代的实现版本,不能直接当作当前 SDK 的安装与调用教程。
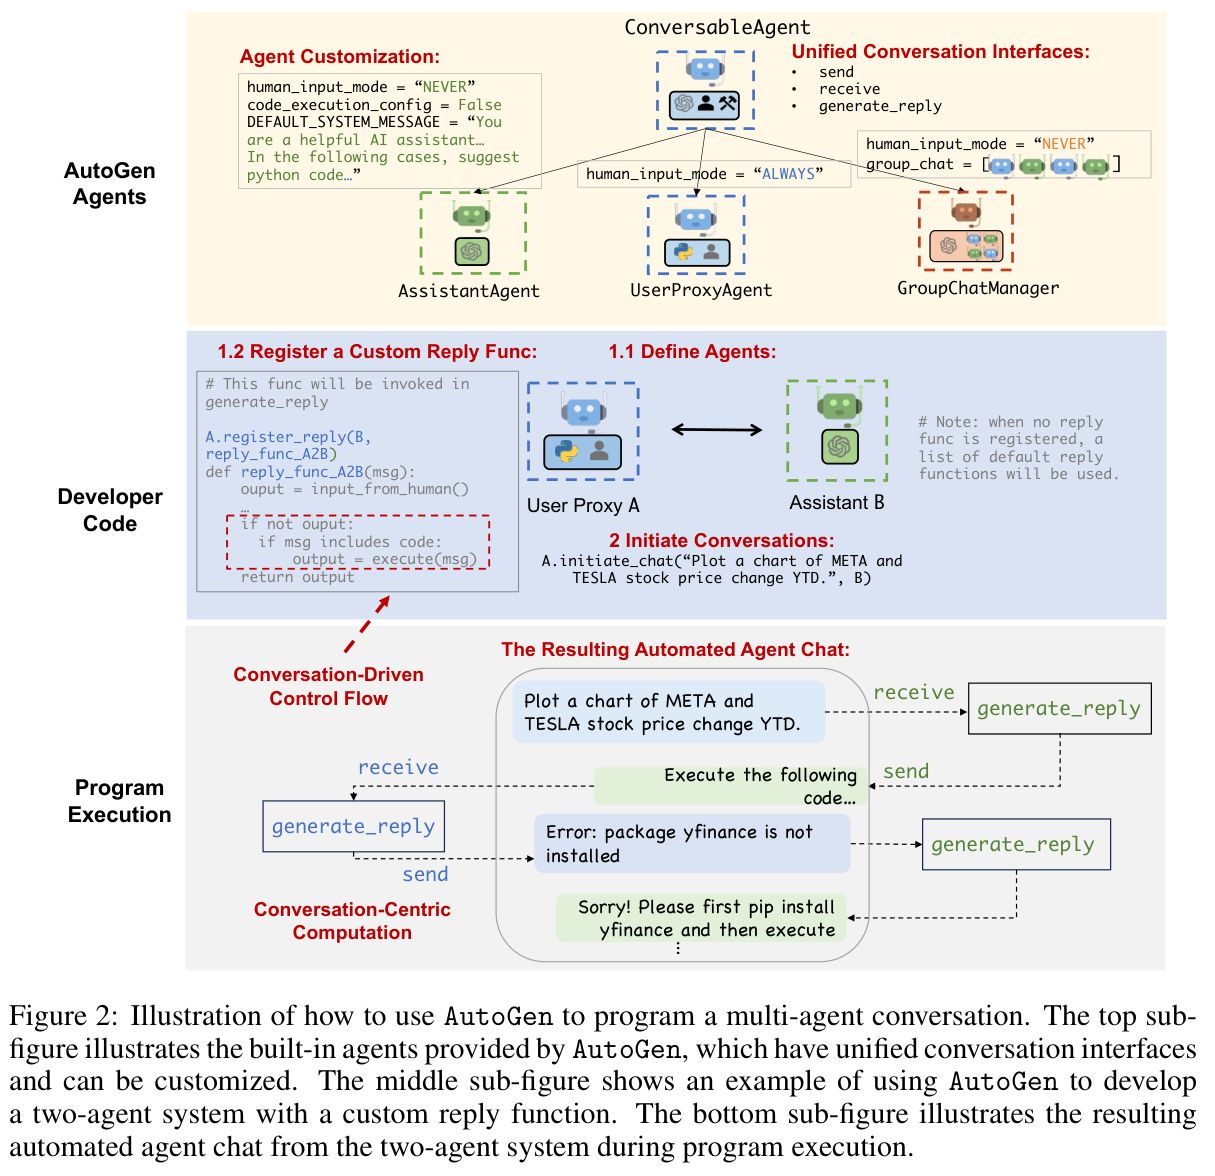
图源:原文图 2,PDF 第 4 页。上方是 Agent 类型和配置,中间是开发者定义的回复函数,下方是执行中产生的消息。模型回复与执行反馈通过同一套会话接口连接。
图中最基本的协作由助手和用户代理组成。助手提出代码,用户代理接收人工反馈或运行代码,将结果发回。整个过程可以持续多轮,直到满足结束条件或达到执行限制。
Conversable Agent 保存什么、能做什么
论文第 2.1 节把 Agent 定义为能够发送、接收和响应消息的实体。它有特定角色,维护收发消息形成的上下文,还可以配置后端能力。
LLM 后端用于生成代码、解释结果和根据反馈修改方案。工具后端负责运行代码或函数。人工后端允许人在特定轮次提供输入。多 Agent 系统因此可以包含确定性执行程序和真实用户,不能把每个节点都理解为一个独立训练的模型。
在论文实现中,ConversableAgent 是通用抽象,AssistantAgent 和 UserProxyAgent 是常用预配置类型。助手默认侧重模型回复;用户代理可以征求人工输入或执行代码。这些职责来自配置,名称本身不决定系统权限。
同一个 LLM 也可以支撑不同角色。角色提示词会改变任务和回复形式,但不会使模型之间的判断自然独立。作者在应用中加入执行器、事实提示或审查环节,目的都是提供对下一步有用的反馈。
Conversation Programming 如何控制流程
对话编程先定义各 Agent 的角色和能力,再定义它们怎样响应收到的消息。论文把这两部分称为会话中心的计算,以及会话驱动的控制流程。
一次计算可以是调用模型、请求人工输入、执行代码或查询资料。它的结果被包装为消息,触发下一位参与者的计算。统一的 send、receive 和 generate_reply 接口让这些后端能够配合。
自动回复机制使收到消息的 Agent 产生回复,并在没有结束时继续会话。自定义回复函数还可以先向第三个 Agent 咨询,再返回给原发送者。这给嵌套协作提供了入口。
控制逻辑可以放在两层。自然语言提示词要求模型在失败后修正,或输出约定的终止标记;程序代码负责判断结束条件、限制自动回复次数、选择人工输入模式和运行工具。实际系统应把预算和工具执行条件落在可检查的程序逻辑中,不能只依靠模型声称“已经完成”。这是从论文的混合控制方式延伸的实现建议。
双向对话、嵌套咨询与动态群聊
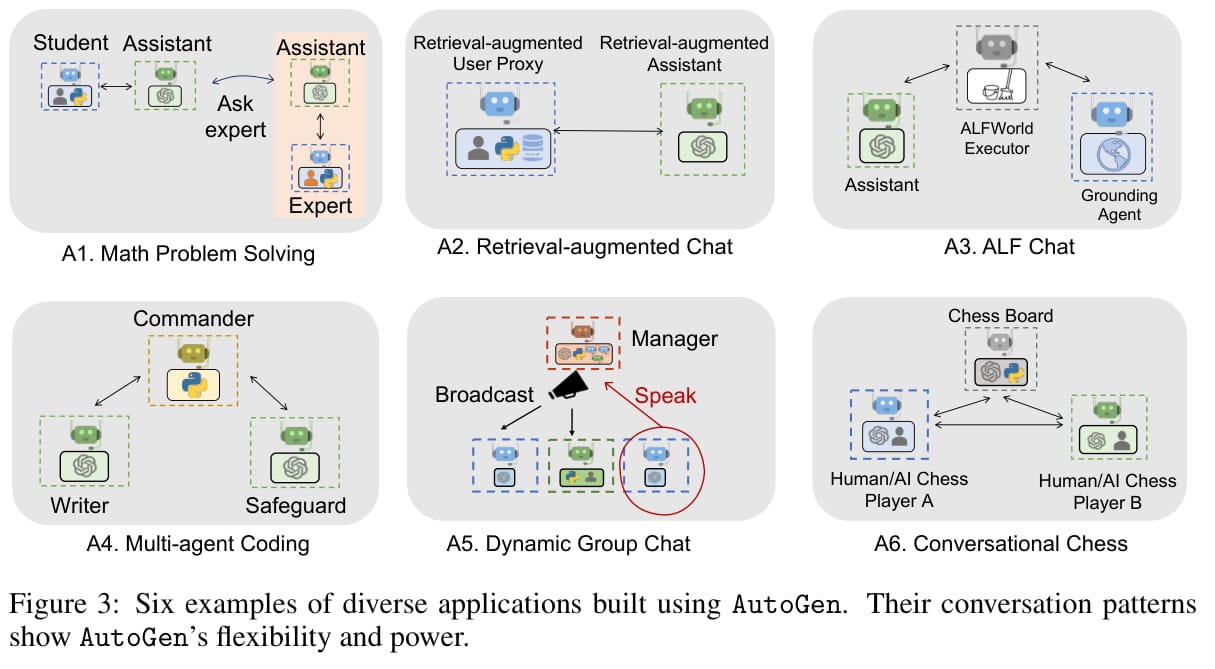
图源:原文图 3,PDF 第 6 页。数学求解、检索、环境交互、代码审查、动态群聊和棋盘验证,对应不同的参与者与通信关系。
双向对话适合“生成—执行—反馈”的循环。嵌套咨询用于当前参与者暂时把问题交给专家,再根据专家返回继续原对话。它们都需要明确谁负责结果和终止。
动态群聊由 GroupChatManager 重复执行三步:选择下一位发言者,收集该 Agent 的回复,再把消息广播给其他成员。选择策略可以根据已有对话和角色职责变化。图中的群聊因此是有路由逻辑的消息系统。
论文还用棋盘 Agent 检查走法是否合法。这类确定性检查能提供规则反馈,而仅在提示词中要求双方保证合法,并不能确保游戏始终满足规则。选择验证机制时,应先确定哪些条件可以由程序直接检查。
四组实验分别支持什么结论
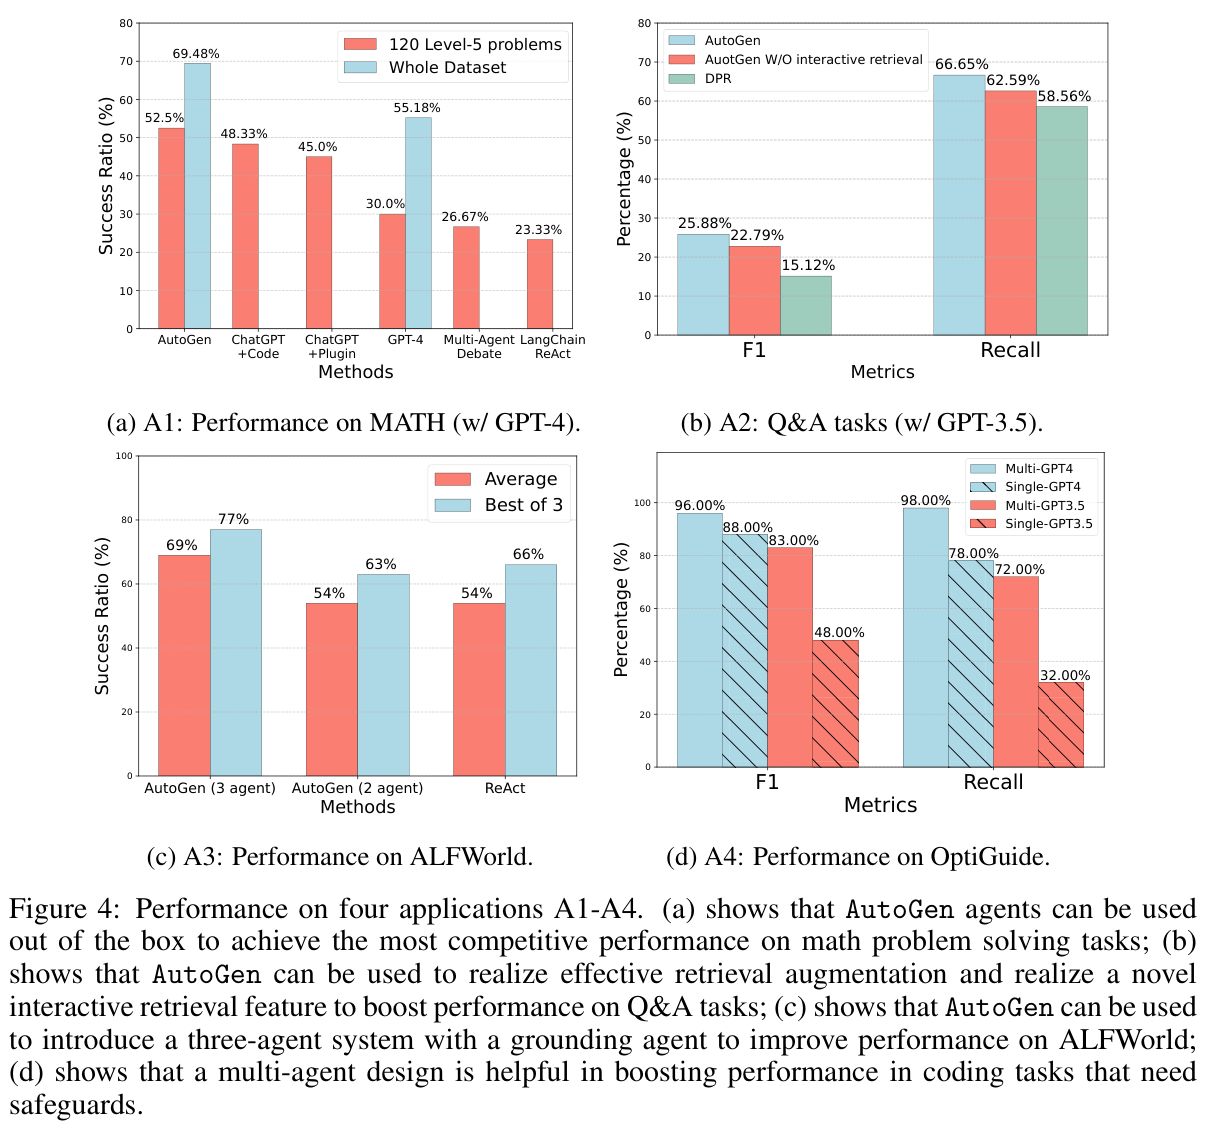
图源:原文图 4,PDF 第 7 页。四个子图来自不同任务、模型和指标,不能把柱形高度合并成一个统一的 Agent 能力排名。
数学:工具执行与反馈能改善历史基准结果
数学应用使用助手与执行代理,底座为 GPT-4,执行环境预装 SymPy。附录 D 说明,小规模测试包含 120 道 MATH 的 level 5 题,每个类别 20 道,排除了几何;另一次测试使用完整的 5,000 道测试题。
120 道题上,AutoGen 成功率为 52.5%,vanilla GPT-4 为 30.0%;完整测试集上分别为 69.48% 和 55.18%。这些是论文环境中的历史结果,包含生成代码和执行反馈的应用系统与直接模型回答之间的差异。
商业产品和部分开源基线只测了小集合,没有全部参加 5,000 题测试。图中 Multi-Agent Debate 在小集合上的 26.67% 还低于直接 GPT-4 的 30.0%,说明角色协作的设计需要具体检验。
检索问答:能否根据缺失证据继续取材料
检索应用把资料处理和召回放在用户代理中,由助手负责基于资料回答。当助手无法从当前片段找到答案时,可以发出 UPDATE CONTEXT,让代理提供后续相关片段。
Natural Questions 实验的 F1 从取消交互检索时的 22.79% 提高到 25.88%,Recall 从 62.59% 提高到 66.65%。这里改变的是检索与回答之间的反馈流程。附录说明,资料与问题来自该数据集,结束还受到可用文档的限制。继续检索能帮助获取缺失证据,也会增加调用和上下文成本。
ALFWorld:第三个角色承担了具体纠错职责
ALFWorld 应用中的两个 Agent 分别决策和执行,三 Agent 版本增加 Grounding Agent,提供家庭环境常识。附录 D 说明,它在任务开始时及同一动作连续出现三次时介入,帮助系统摆脱重复错误。
134 个未见任务上,三 Agent 与两 Agent 版本的平均成功率分别为 69% 和 54%,差 15 个百分点。图中也另列 Best of 3,不能与平均值混写。
AutoGen 这两个版本使用 GPT-3.5-turbo,而 ReAct 基线用其原始代码的 text-davinci-003。因此,三 Agent 对两 Agent 的比较更适合判断新增模块的作用;与 ReAct 的对照还包含底座差异。执行器另外用动作相似度匹配合法选项,也属于系统实现的一部分。
OptiGuide:F1 测的是不安全代码识别
这个应用包含 Commander、Writer 和 Safeguard。Writer 编写并解释代码,Safeguard 检查代码,Commander 组织执行和反馈。出现拒绝或执行异常时,信息返回 Writer 继续修改。
论文用 100 个编码任务评估安全识别,安全与不安全任务各占一半。GPT-4 设置下,多角色设计的 F1 为 96%,把编写和检查合并给单 Agent 时为 88%,提高 8 个百分点。它不是“软件开发成功率为 96%”,也不能证明审查者可以识别所有不安全操作。
作者还报告 OptiGuide 核心流程代码从 430 多行减少到约 100 行。这个案例支持框架复用能够减少特定业务的胶水代码,但不能推导任何项目都能获得相同比例的开发效率提升。
怎么判断自己是否需要多个 Agent
先写出需要哪些不同的计算与证据。例如,一个代码分析任务需要生成方案、运行工具和检查结果。如果它们采用相同上下文、相同权限和完全固定的顺序,先用简单程序组织即可。需要不同上下文、独立的工具执行职责或动态咨询时,多 Agent 抽象才更容易体现价值。
每个角色应有可以检查的输出。执行器返回真实日志,检索者返回资料位置,检查者指出具体条件,协调者管理预算与结束。只有角色名称而缺少输入输出约定,容易得到相互附和的长对话。
验证时固定底座、任务集、工具和预算,对比单 Agent、基础双 Agent,以及新增角色后的版本。同时记录成功率、调用次数、执行时间和结束失败。论文的群聊先导实验只有 12 个手工任务,其优势不能直接推广到所有拓扑。
限制与阅读重点
AutoGen 展示了一个可复用的协作框架,并用数学、检索、环境任务等案例说明其表达能力。不同应用采用的组件和评测协议差异较大,论文没有给出能够通用于所有任务的最佳角色数量或通信结构。
模型生成的终止标记、角色自评和代码审查都有误判可能。消息传播还可能放大错误,轮次增加也会带来费用。论文讨论了这些问题,并把自动化与人工参与的平衡列为后续方向。
学习时先看第 2 节和图 2,理解消息接口与自动回复。再选图 3 中的一种拓扑,沿附录 D 查它的实际触发条件和实验口径。AutoGen 最值得复用的是把角色、工具反馈和控制流程写成清楚的交互约定。
来源:AutoGen 论文 v2,第 2—4 节、图 2—4、附录 D。文中的角色选择和项目验证步骤是阅读后的实现建议。