
Generative Agents: Interactive Simulacra of Human Behavior 论文阅读
摘要
拆解 Generative Agents 的记忆评分、反思树、分层计划与环境执行,核对访谈可信度消融和 25 个角色两天模拟,解释聚会传播、行动遗漏及真实性边界。
Smallville 小镇里有 25 个角色。有人经营咖啡馆,有人研究课题,也有人计划举办情人节聚会。一个角色得到办聚会的初始意图后,会邀请别人、准备场地;其他角色可能把消息继续传播,并把活动加入自己的计划。Generative Agents 研究的目标,是让这类持续交互产生与角色经历相符、对观察者可信的行为。
它的架构把观察保存进记忆流,再结合近期性、重要性和相关性检索历史。反思把具体经历变成更抽象的认识,计划把认识和当前目标组织成后续行动。实验支持这些组件在角色访谈中的作用,也展示了两天模拟里的信息传播。它评估的是行为可信度,尚不能证明模拟结果可以预测真实社会。
论文信息与整体架构
项目 | 信息 |
|---|---|
论文 | Generative Agents: Interactive Simulacra of Human Behavior |
作者 | Joon Sung Park、Joseph C. O’Brien、Carrie J. Cai、Meredith Ringel Morris、Percy Liang、Michael S. Bernstein |
阅读版本 | arXiv:2304.03442v2,2023 年 8 月 6 日 |
发表 | UIST 2023,DOI:10.1145/3586183.3606763 |
资料 |
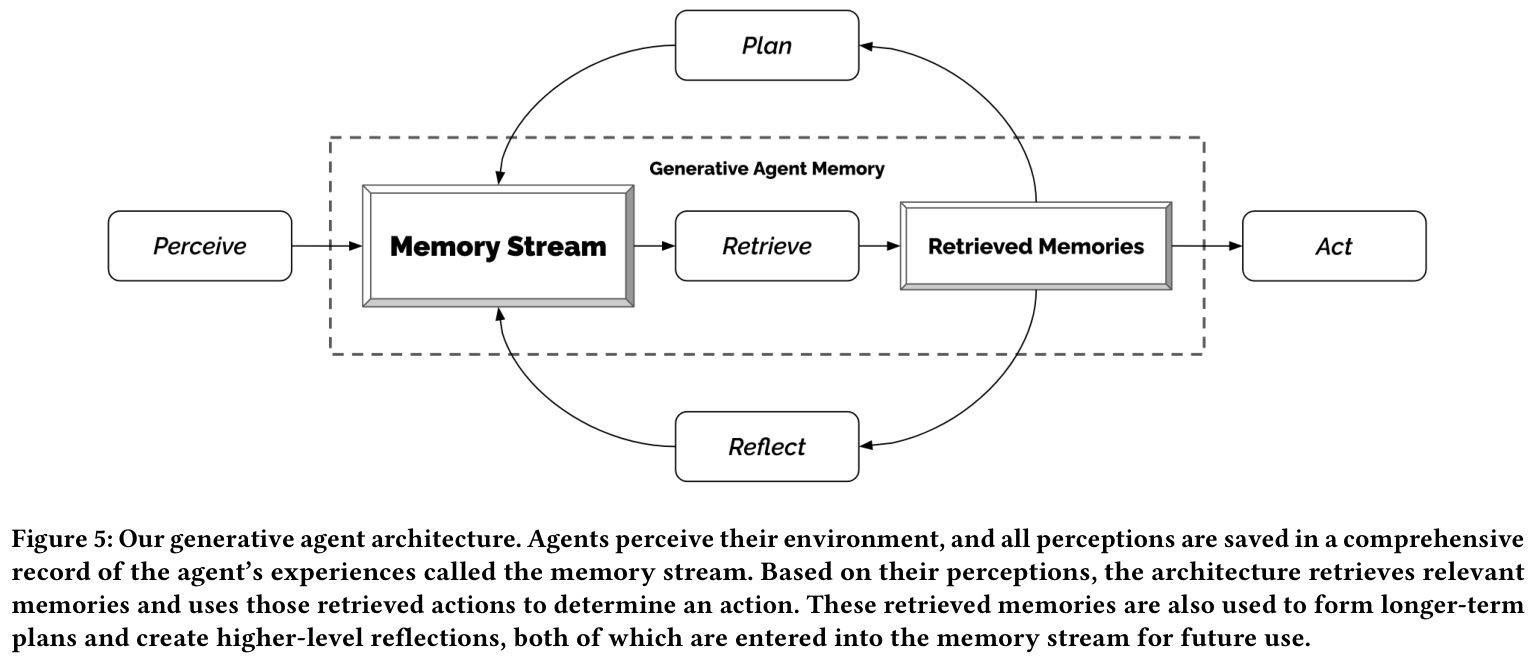
图源:原文图 5,PDF 第 8 页。计划和反思重新写入记忆流,后续决策因此可以同时读取观察、已有计划和归纳结果。
论文使用 gpt-3.5-turbo 驱动角色,并由人工构建游戏地图、场所和对象。模型生成自然语言行动,程序把行动落到模拟环境。长期连贯性来自外部记忆和控制流程,没有进行新的模型参数训练。
记忆流保存观察,也保存推断与计划
每个记忆对象包含自然语言描述、创建时间和最近访问时间。观察是角色感知到的事件,例如看到某人学习、参与一次交流,或者发现冰箱已经空了。角色只能基于所获得的信息行动。
计划和反思也存入同一记忆流。计划表达未来的安排,反思表达从经历中推导出的认识。它们能被再次检索,但可靠性与已经发生的观察不同。应用中需要保留内容类型及来源,否则“打算去聚会”可能被误读成“已经参加聚会”。
论文在反思记录中保留指向证据记忆的引用,这为追溯提供了结构。后续实现可以据此检查一条推断究竟来自哪些事件,或者是否建立在另一条未经验证的推断上。
检索为什么结合三个分数
只有语义相似度,未必能够选出对当前行动最有用的经历。第 4.1 节使用三种信息。
近期性强调最近访问的记忆。实现按自上次检索以来经过的游戏小时做指数衰减,衰减因子为 0.995。它与 MemoryBank 中按召回次数增加强度的规则不同,本文没有同样的强度变量更新机制。
重要性由模型在记忆创建时给出 1—10 的评分,用来区分日常琐事和影响较大的事件。这个分数表示模型对事件重要程度的判断,并非客观事实。
相关性使用记忆描述与当前查询的向量余弦相似度。不同问题会形成不同查询,关于某个人的关系、正在进行的活动等都可能影响召回结果。
论文把三种分数分别做 min-max 归一化,再相加。所有权重均为 1,可以概括为:
这里的三个分量已经归一化,分别对应近期性、重要性与相关性。分数最高且能够放入上下文的记忆进入提示词。这个启发式评分不代表概率,也没有通过完整参数搜索证明等权组合适用于所有任务。
反思把事件变成可复用认识
观察中可能多次出现“阅读论文”“查询资料”“讨论研究”。反思可以将这些记录概括为“这个角色高度投入研究”,后续选择伙伴或活动时就有了更高层的依据。
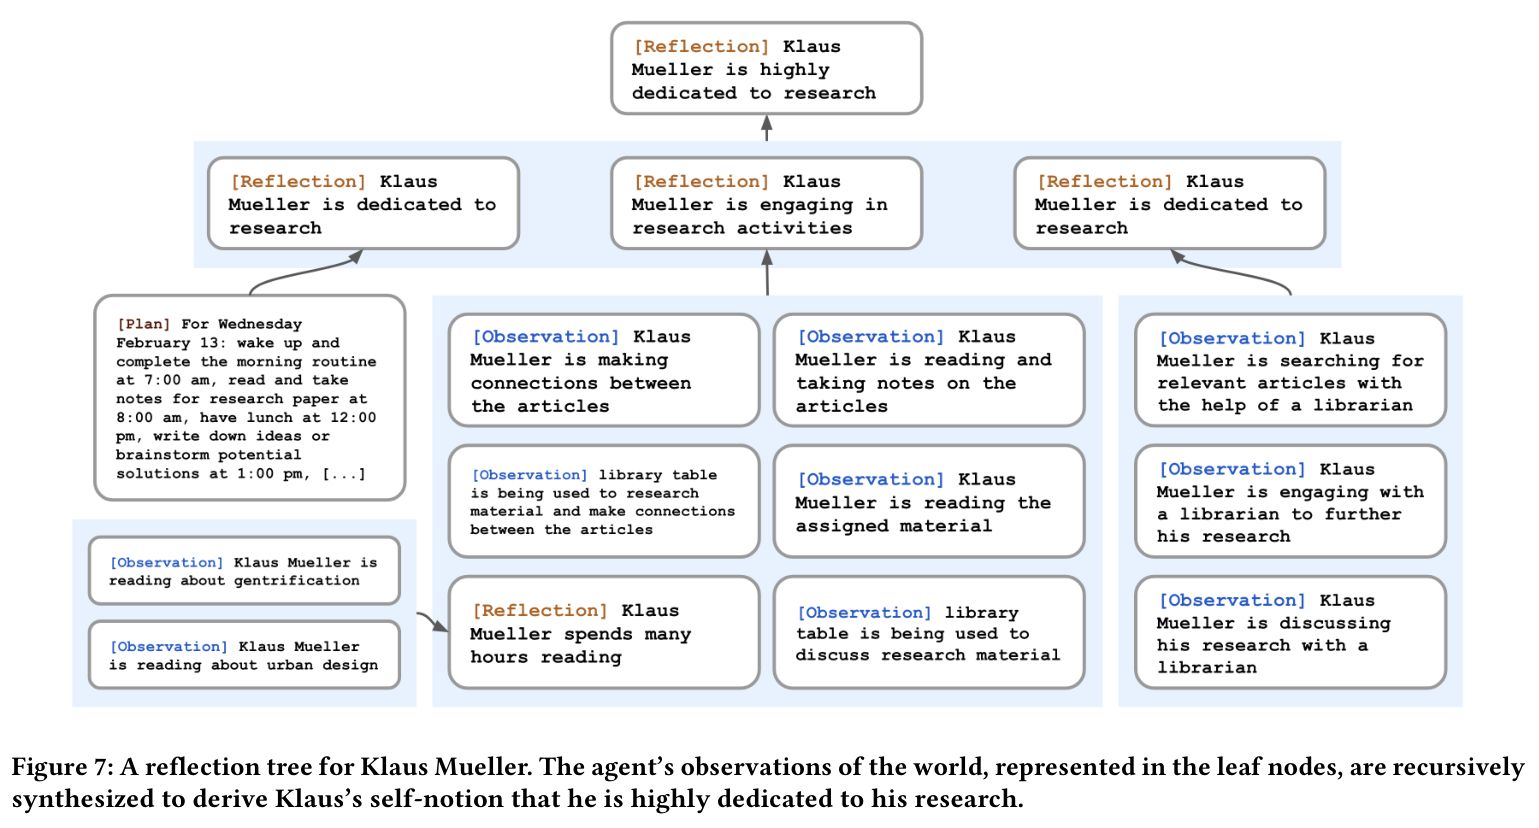
图源:原文图 7,PDF 第 10 页。叶节点包含经历,较高层节点包含推断。反思可以继续引用其他反思,形成层次结构。
实现先读取最近 100 条记忆,让模型提出 3 个值得回答的高层问题,再用这些问题检索相关记录。随后让模型生成认识并列出支撑它的记录编号,解析后保存到记忆流。
触发条件是新近事件的重要性累计超过阈值,论文设置为 150。在所展示的模拟中,角色通常每天反思两到三次。这个触发器控制何时归纳,没有证明 150 是普遍最优参数。
逐层归纳也会放大早期错误。一个不充分的判断如果被反复引用,可能逐渐成为角色对自己或他人的固定描述。因此,保留证据引用还不够,应用中需要区分事实、推断和后来被修正的推断。这是基于该结构提出的工程建议。
计划怎样保持时间上的一致性
每次只问“现在应做什么”,模型可能在午饭后再次安排午饭。论文用长时间范围的计划减少这种局部合理、整体重复的行为。
计划记录地点、开始时间和持续时长。模型先生成一天约 5—8 个大段安排,再拆成小时级行动,随后拆成 5—15 分钟的小步骤。细化程度可以按应用调整。
计划还要接受环境反馈。角色每一步感知周围事件,模型判断继续当前计划还是作出反应。如果遇到需要交流或处理的情况,系统从反应发生的时刻重新生成后续计划。对话也结合双方关于彼此的记忆生成。
规划能力与环境执行需要分开看。Smallville 用树结构描述区域和对象,模型递归选择地点,传统路径算法负责让角色移动。角色维护自己看过的环境子图,离开区域后,信息可能过时。这个结构为模型提供了明确的可行动范围。
访谈评测测的是行为可信度
受控实验从完整架构的两天模拟中获得角色经历,再询问身份、记忆、计划、反应和反思五类问题。100 名评审比较完整系统、三种删减架构,以及众包人员扮演角色写出的回答,按可信度排序。
各条件在访谈时访问同一批历史,只移除相应类型的内容。这减少了历史差异对比较的影响,但并非让每种删减系统各自运行两天。实验结果更直接支持访谈回答中的组件贡献。
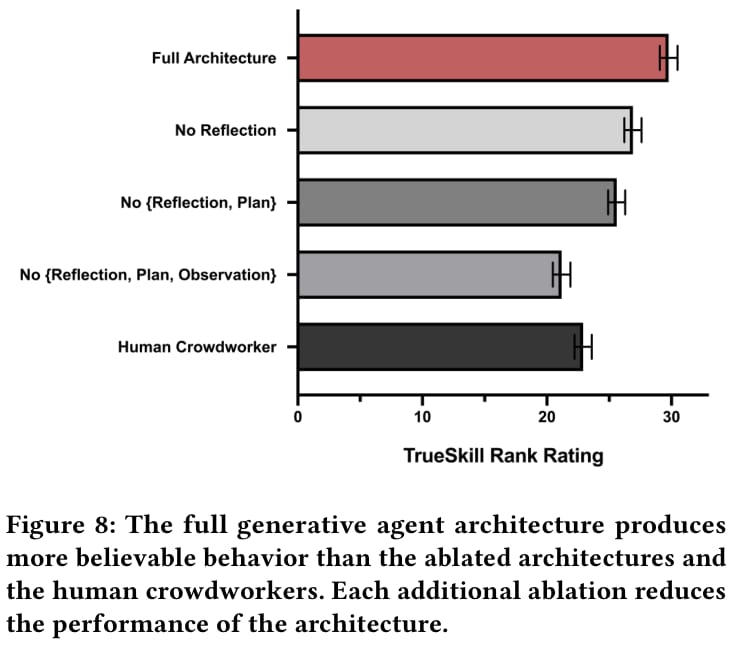
图源:原文图 8,PDF 第 14 页。横轴是由排名计算出的 TrueSkill rating,不是正确率或任务成功百分比。
条件 | TrueSkill 均值 |
|---|---|
完整架构 | 29.89 |
无反思 | 26.88 |
无反思、无计划 | 25.64 |
众包角色回答 | 22.95 |
无观察、无反思、无计划 | 21.21 |
完整架构最受评审认可。论文通过统计检验报告多数条件间存在显著差异,但众包人员没有代表人类专家的最佳表现。不能据此写成“Agent 的理解能力超越人类”。
论文还记录了事实层面的失败。角色有时只检索到准备在聚会上讨论的话题,却没召回聚会邀请,结果能说出要讨论什么,却不确定聚会是否存在。另一个角色把同名邻居 Adam Smith 与历史经济学家混淆。这些例子说明,外部记忆仍会受到检索遗漏和底座知识混入的影响。
两天的小镇里发生了什么
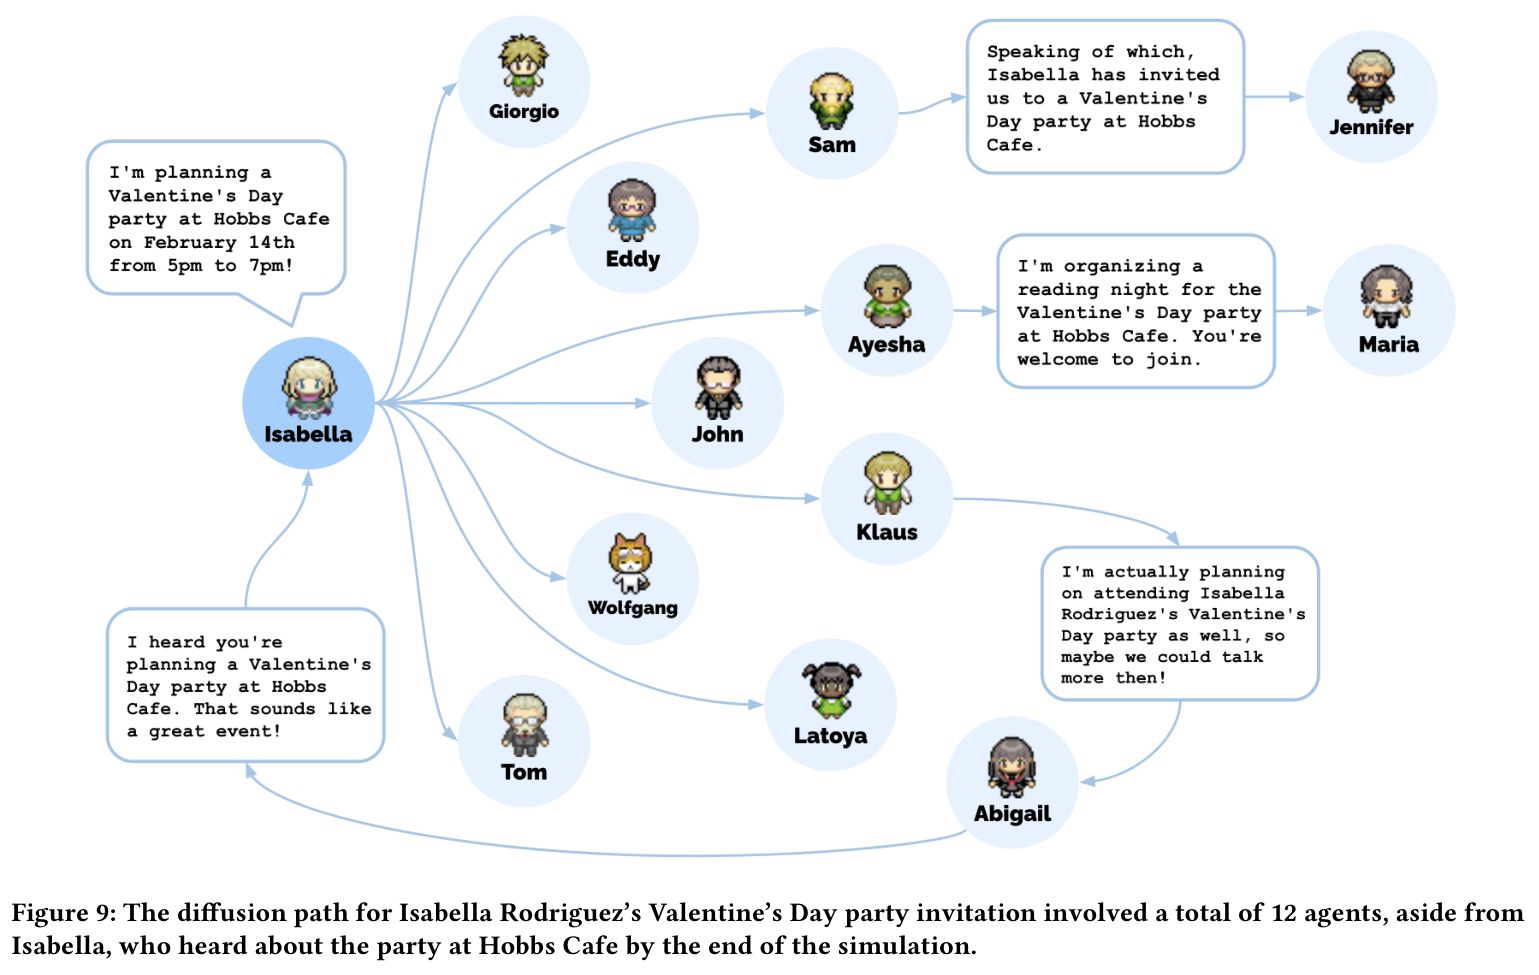
图源:原文图 9,PDF 第 16 页。除发起者 Isabella 外,有 12 个角色获知聚会,消息通过多次交流传播。
候选人参选消息的知情人数从 1 人变为 8 人,聚会知情人数从 1 人变为 13 人,分别占 25 个角色的 32% 和 52%。作者回查了对应交流记录,验证这些知情回答有来源。
聚会的 12 个受邀角色中有 5 个出席。未出席的 7 个中,3 个报告有时间冲突,另 4 个表示有兴趣,却没有在当天安排参加。因此,知道某项活动、愿意参加和实际把它加入计划是三个不同条件。
作者还报告角色关系图密度从 0.167 增至 0.74,并检查记忆以排除无依据的互相认识。这里的“涌现”意味着部分传播和协调过程没有逐条编写成脚本;它们仍受初始人物描述、办聚会意图、地图和提示词设定影响。
能复用的结构与仍需验证的边界
对有持续经历的交互系统,可以复用带时间的事件存储、基于当前问题的检索、带证据指针的反思,以及能够被新观察修订的计划。这些模块也便于独立检查:错误来自漏召回、错误归纳,还是行动没有落实到计划。
复现时可以先从少量角色和短历史开始,保留每条关键行动所使用的记忆。分别评估历史事实回答、计划一致性和外部行为,再决定是否扩大人数。作者第 8.2 节说明,原研究模拟 25 个角色的两个游戏日,消耗数千美元 token 额度,并运行了多个现实日。这是当时的资源记录,不能当作当前模型价格。
两天观察也不足以验证数月稳定性。论文报告了不合适的活动地点、对场所规则理解错误、过于正式和过度合作的交流。角色更容易生成顺畅对话,并不意味着对真实人群的行为分布完成了校准。
阅读重点
Generative Agents 把持续交互组织成“观察入库—检索—行动”,再让反思和计划进入后续循环。原文给出的实验证据,主要支持访谈中的可信度,以及有限时间模拟中的传播和协调。
首次阅读先看图 5 和第 4 节,再看第 6 节的条件设计,最后读第 7—8 节的实际失败与资源成本。对 Agent 工程,最值得检查的是一条行为从哪些记录、推断和计划产生,以及这些依据在下一轮还能否被正确使用。
来源:Generative Agents 论文 v2,第 3—8 节、图 5、图 7—9。类型区分、推断修订与小规模复现方案属于阅读后的工程建议。