
MemoryBank: Enhancing Large Language Models with Long-Term Memory 论文阅读
摘要
拆解 MemoryBank 的原始对话、事件摘要、用户画像、向量检索与遗忘规则,核对 SiliconFriend 的中英文实验,区分召回命中、回答评分和模型微调各自的作用。
用户昨天谈过学习 Python,今天询问推荐过哪本书。只看到当前消息的模型缺少回答依据;把全部聊天记录反复塞进提示词,又会受到上下文长度和费用限制。MemoryBank 把历史对话、事件摘要和用户画像放到模型外部,回答时检索相关片段,再把这些材料加入提示词。
这篇论文的学习重点是记忆的完整生命周期:保存什么、怎样找回、如何更新。它用 SiliconFriend 聊天应用展示跨天回忆,也加入受遗忘曲线启发的记忆强度规则。实验显示,找回相关历史和正确使用历史是两个不同环节;论文没有通过独立消融证明遗忘机制带来了多少收益。
论文与整体结构
项目 | 信息 |
|---|---|
论文 | MemoryBank: Enhancing Large Language Models with Long-Term Memory |
作者 | Wanjun Zhong、Lianghong Guo、Qiqi Gao、He Ye、Yanlin Wang |
阅读版本 | arXiv:2305.10250v3,2023 年 5 月 21 日 |
研究对象 | 面向持续对话的外部长期记忆与个性化回复 |
原文与实现 |
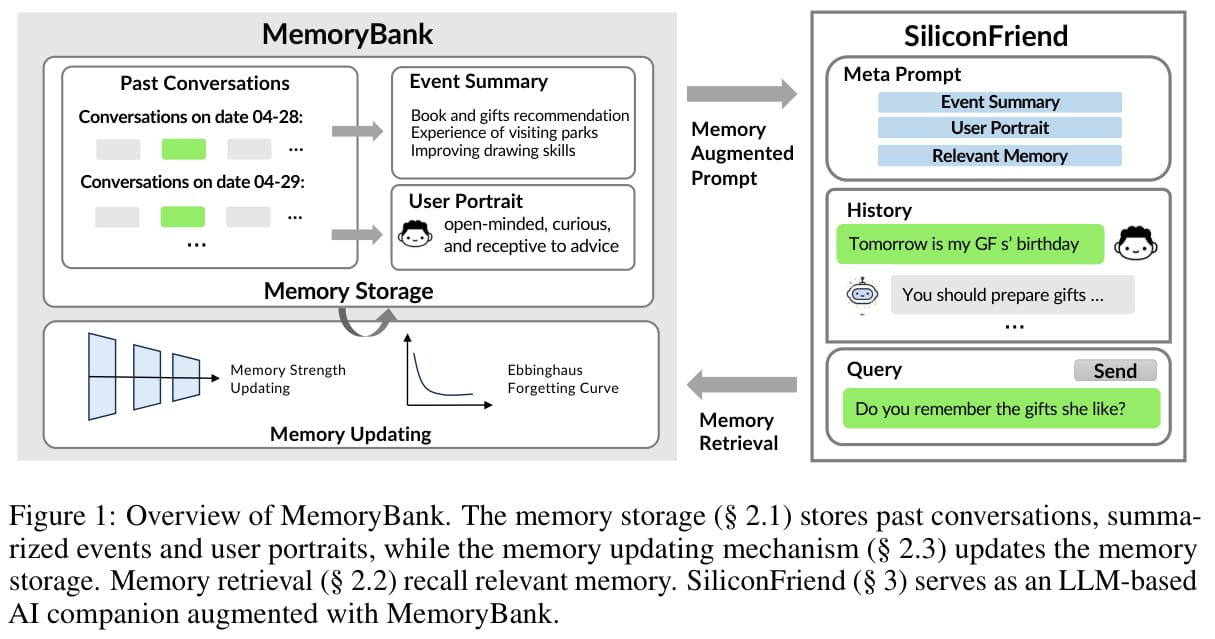
图源:原文图 1,PDF 第 3 页。左侧记忆库保存原始对话、事件摘要和用户画像,右侧应用把召回内容放入 Meta Prompt。图中的“长期”指跨会话持久保存,运行时仍要把所需材料送入有限的上下文。
整体流程可以按一次请求理解:读取当前对话,检索相关记忆,把事件摘要、画像和召回内容组织成提示词,生成回答,随后继续记录新的交互。摘要和画像由模型从历史中生成,记忆更新模块管理保留强度。核心变化发生在模型外部的数据和提示词中。
记忆库为什么分成三种内容
带时间戳的原始对话
原始记录保留每轮交流及其时间。用户问“上次让我看的那本书叫什么”时,需要找到具体推荐,而笼统的“用户喜欢编程”无法给出书名。
时间信息也帮助区分过去状态与当前状态。例如,旧对话中说“准备学 Python”,不能一直被当作用户尚未开始学习的证据。论文建立了按时间保存历史的基础,但没有完整解决冲突事实和状态失效的问题。
每日事件摘要与全局摘要
论文先把一天的对话浓缩成事件摘要,再把每日事件汇总成全局摘要。这种层次结构让应用同时保留具体证据和较短的背景描述。
压缩会带来信息损失。原始记录中一个附带条件,可能在摘要里消失。工程实现应让摘要保留对应原始记录的标识,涉及具体日期、数量或承诺时能够回到原文核对。这是从论文结构延伸的实现建议,原文没有评测这种追溯机制。
随交互更新的用户画像
MemoryBank 还让模型总结用户每天表现出的性格和情绪,再合并为更概括的画像。画像用于调节回复方式和推荐内容,减少反复询问同样背景。
这里的画像属于模型推断,不能与用户明确说过的事实混存为同一种可靠程度。图 4 展示不同画像下的推荐例子,但这些例子没有验证模型能够准确测量真实人格,也没有证明心理支持的临床效果。
当前问题怎样找回历史
第 2.2 节把每轮对话和事件摘要视为记忆片段,用编码器得到向量,并建立 FAISS 索引。当前对话也被编码成查询向量,系统按相关性检索历史片段。
SiliconFriend 的实现借助 LangChain 组织检索。英文版本使用 MiniLM,中文版本使用 Text2vec,论文允许替换编码器。应把这些理解为 2023 年实现选择,而非记忆系统必须采用的固定依赖。
检索完成后,模型依据当前上下文、事件摘要、用户画像和相关记忆回答。模型权重没有因为这次召回而改变。下一次请求能记得历史,是因为应用再次查询持久化存储。
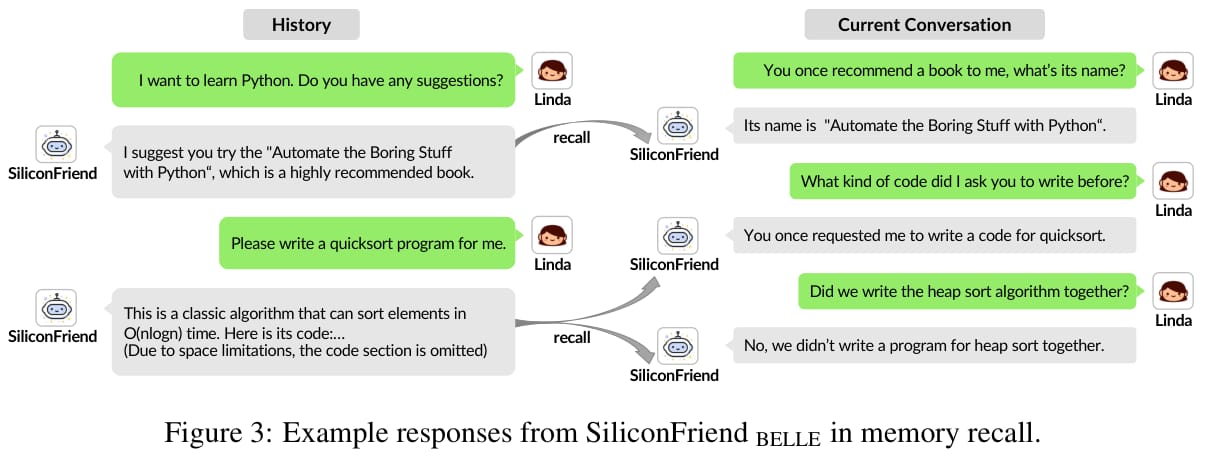
图源:原文图 3,PDF 第 7 页。这个案例包含两类问题:询问已发生的事件,以及询问一个没有发生的事件。最后一问尤其有用,能够检查模型是否为了维持对话连贯性编造共同经历。单个成功案例无法代表整体错误率。
从这张图可以拆出一条检查链:相关记录是否存在,检索是否找到,提示词是否包含,回答是否忠实使用。遇到错误时,应逐层定位,否则更换生成模型也可能继续受到错误记忆的影响。
遗忘曲线在系统中如何落地
论文第 2.3 节采用简化的指数衰减形式:
其中, 表示自记忆形成或最近强化以来经过的时间, 表示记忆强度, 表示保留程度。一个记忆第一次出现时令 ;每次被召回,令 增加 1,并把 重置为 0。相同时间间隔下,更大的 会让保留程度下降得更慢。
这是受心理学启发的管理规则。作者明确承认真实记忆更复杂,这个模型经过了高度简化。原文没有给出通用的删除阈值,也没有系统比较不同衰减参数、时间单位和召回频率对任务质量的影响。
此外,被频繁召回可能只说明向量检索偏爱某段内容,并不自动说明它更重要。错误摘要如果反复命中,也可能被强化。对用于执行任务的 Agent,用户明确要求和仍然有效的约束,通常需要独立的保留策略。这属于应用设计判断,不能由这条公式直接推出。
MemoryBank 与模型微调分别做了什么
SiliconFriend 有两个阶段。第一阶段只针对开源底座,使用约 3.8 万条心理对话做 LoRA 微调,论文设置 rank 为 16,在 A100 上训练 3 个 epoch。它改变模型的回复倾向。
第二阶段为 ChatGLM、BELLE 和 ChatGPT 接入 MemoryBank,提供历史记录和用户背景。闭源 ChatGPT 没有执行上述 LoRA 训练。把“微调后更会进行情绪对话”与“外部记忆让模型回忆历史”分开看,才能判断实验验证的是哪个组件。
这也影响复现方案。如果目标只是让客服助手记住用户上次的工单,可以先实现外部存储和检索,不必照搬心理对话训练。论文没有证明这种任务需要第一阶段训练。
实验到底测了哪些能力
定量部分构造了 15 个虚拟用户的 10 天对话历史,用户特点和对话由 ChatGPT 合成,每天至少覆盖两个主题。研究者手写 194 个探测问题,英文和中文各 97 个,再让人工评估召回内容与模型回答。
指标分为四项:召回是否包含相关记忆,回答是否正确,回答是否与上下文连贯,以及三个模型输出的相对排名。正确性和连贯性允许 0、0.5、1 三档评分,因此均分不能直接写成“完全答对的百分比”。
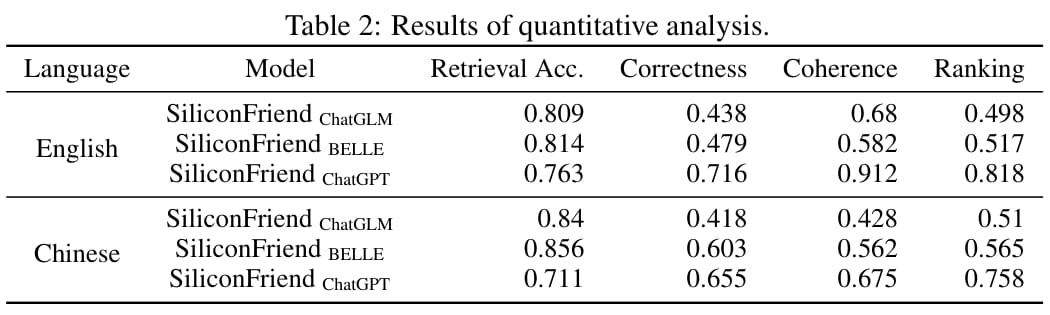
图源:原文表 2,PDF 第 9 页。Retrieval Acc. 采用二值判断,Correctness 和 Coherence 是带部分分的评分均值,Ranking 使用倒数排名。
语言与模型 | 召回准确度 | 回答正确性均分 | 连贯性均分 |
|---|---|---|---|
英文 ChatGLM | 0.809 | 0.438 | 0.680 |
英文 BELLE | 0.814 | 0.479 | 0.582 |
英文 ChatGPT | 0.763 | 0.716 | 0.912 |
中文 ChatGLM | 0.840 | 0.418 | 0.428 |
中文 BELLE | 0.856 | 0.603 | 0.562 |
中文 ChatGPT | 0.711 | 0.655 | 0.675 |
ChatGPT 版本的召回指标低于另外两个版本,但回答正确性和排名更高。论文将回复差异与底座能力联系起来。这组结果至少说明,单看“是否检索到相关片段”不足以预测最终答案质量,生成环节同样需要评估。
评测还有明确的范围:只有 15 个合成用户,探测历史覆盖 10 天。它不能直接代表真实用户数月使用后的记忆质量。表 2 比较三个应用版本,没有提供完整的“无记忆、只有原始记录、加摘要、加画像、再加遗忘”的组件消融,因此不能把各模块收益从表中单独拆出来。
复用时可以怎样设计验证
对跨会话助手,可以先建立一个小型历史问答集。每个问题记录正确的原始对话位置,既包含“曾经说过什么”,也包含“没有说过什么”,再加入用户后来改变偏好的情况。
评测时分别记录检索命中、错误片段混入、最终回答的事实正确性,以及记忆在提示词中占用的 token。比较没有历史、直接检索原始历史、加入摘要三个设置,才容易判断压缩是否节约成本、是否丢掉重要条件。这是基于论文缺口提出的验证方案,不是作者报告的实验。
存储层也应区分明确事实、模型摘要和推断画像。事实保留来源与时间,摘要能够追溯,画像允许被新证据修订。MemoryBank 为这几层建立了一个早期框架,而实际项目仍需明确写入、失效和纠错规则。
读完应带走什么
MemoryBank 把持续对话中的记忆整理成外部存储、相关性检索和更新机制,并通过 SiliconFriend 演示了跨天回忆。它最适合帮助理解 Agent 的记忆工程:上下文只承载当前需要的证据,完整历史留在持久化系统中。
阅读时重点回看第 2 节的数据结构与公式、第 3 节的微调和记忆接入边界,以及第 4.2 节的评分口径。对自己的应用,先验证历史事实能否被准确取回和使用,再决定是否需要画像或拟人化遗忘。
来源:MemoryBank 论文 v3,第 2—4 节、图 1、图 3、表 2。文中的追溯、纠错与组件评测方案是阅读后的工程建议。