
MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework 论文阅读
摘要
从 SOP、结构化交付、共享消息池和执行反馈理解 MetaGPT,核对 Pass@1、软件评分、人工修正和成本,解释 100% 完成率以及不同基线设置的适用范围。
把需求交给多个角色讨论,仍可能得到互相矛盾的接口、遗漏的文件和不能运行的代码。MetaGPT 为软件开发设置了明确的交付顺序:需求进入 PRD,PRD 进入设计,设计进入任务分配,任务进入代码与测试。每个角色接收特定材料,并按规定格式交付下一阶段需要的结果。
论文把标准操作流程 SOP 编入提示词和工作流,再用共享消息池、按角色订阅和执行反馈组织协作。它报告了 HumanEval、MBPP 和 SoftwareDev 上的结果。学习重点是交付契约与真实执行反馈,阅读成绩时则要区分函数级基准、人工软件评分以及系统内部重试预算。
论文信息与整体流程
项目 | 信息 |
|---|---|
论文 | MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework |
作者 | Sirui Hong、Mingchen Zhuge、Jiaqi Chen 等 |
阅读版本 | arXiv:2308.00352v7,2024 年 11 月 1 日 |
发表信息 | ICLR 2024,见 PDF 首页 |
核心机制 | SOP、结构化消息、发布订阅、可执行反馈 |
资料 |
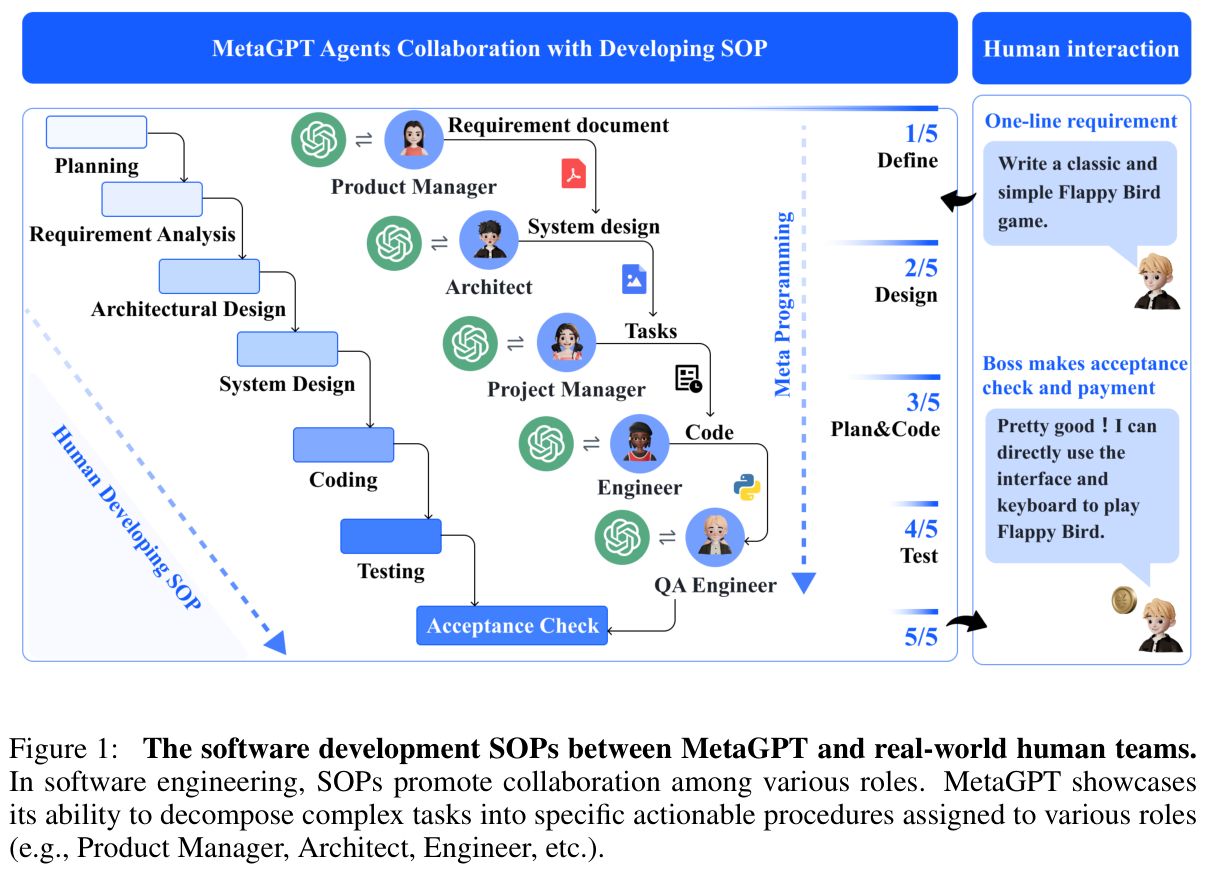
图源:原文图 1,PDF 第 2 页。图中的角色对应需求、设计、计划、编码、测试和验收阶段。主要流程按依赖顺序推进,不能因为角色很多就理解为所有阶段同时进行。
MetaGPT 中的 Meta Programming 指通过程序和 Agent 协作生成程序。它不要求训练一个新的基础模型,也不能与元学习中的参数优化概念直接等同。本文解释的是论文版本的框架,具体软件接口需要匹配对应实现版本。
SOP 规定的是交付物和依赖
论文第 3.1 节定义五种角色,并为各角色设置身份、目标、约束、上下文和能力。角色划分的作用可以从交付物看出来。
角色 | 主要输入 | 主要交付 |
|---|---|---|
产品经理 | 用户需求 | PRD、用户故事、需求池 |
架构师 | PRD | 文件列表、数据结构、接口与系统设计 |
项目经理 | 设计材料 | 开发任务与分配 |
工程师 | 需求、设计、任务及执行反馈 | 代码与修改 |
QA 工程师 | 实现与预期行为 | 测试用例和质量反馈 |
这种安排让上游结果成为下游的明确输入。一个接口的名称、参数和职责应在设计中声明,工程师按照同一份接口信息实现,减少每个角色自行猜测的空间。
结构化输出仍然可能包含错误。PRD 漏掉条件,后续所有角色都可能遵循一个不完整需求。SOP 使这些交付物更便于检查和传递,但正确性还需要内容核对和执行证据。
共享消息池怎样降低通信混乱
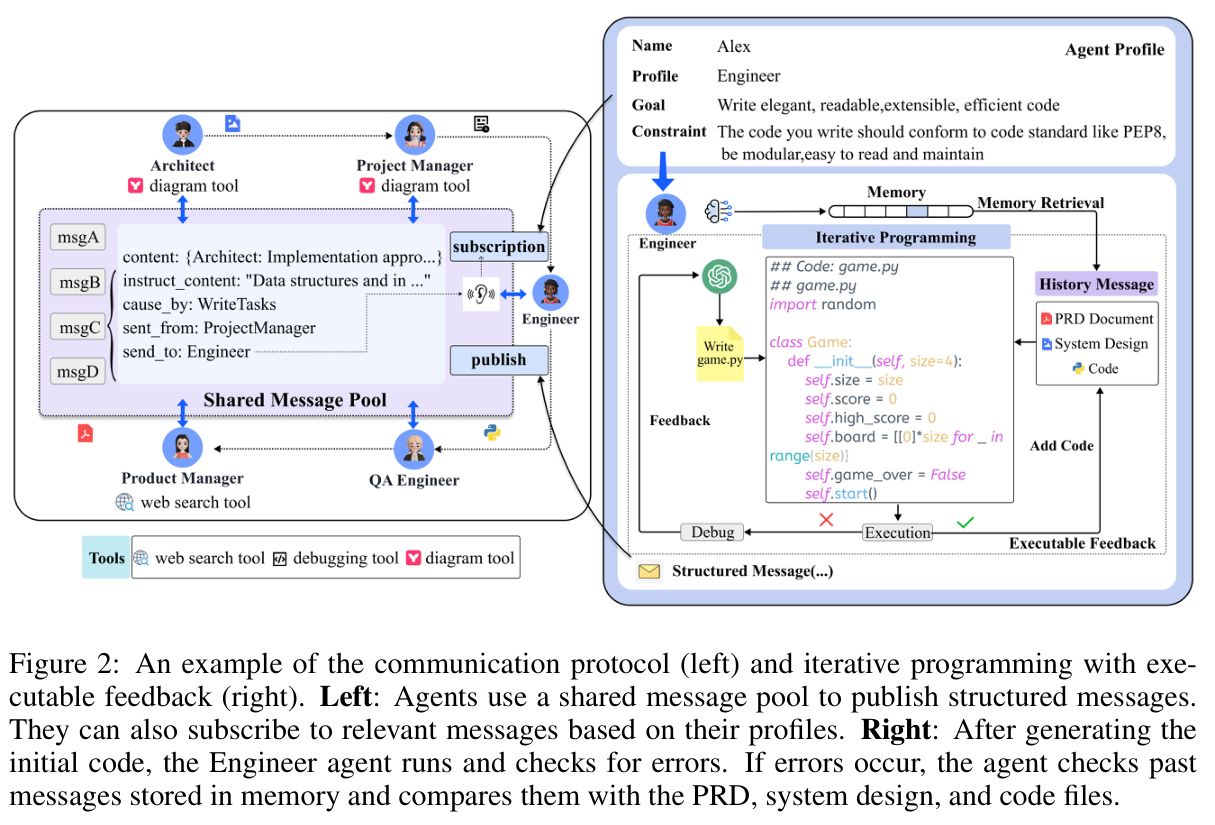
图源:原文图 2,PDF 第 4 页。左侧展示结构化消息发布与订阅,右侧展示工程师读取历史材料、执行代码并根据反馈修改。
如果所有角色都通过逐对询问交换材料,需求和设计会被多次复述。MetaGPT 把结构化消息写入共享池,需要的角色可以读取原有材料。消息按既定格式记录内容及路由相关字段,交付物可以包含文档和图示。
共享不代表每个角色都必须接收所有信息。论文用角色相关的订阅减少无关消息,例如架构师重点关注产品经理的 PRD。角色满足必要的输入依赖后才触发行动。共享池负责信息可获得,订阅负责筛选,依赖负责何时执行。
这三个职责可以分别检查:材料是否已经发布,目标角色是否关注对应消息,前置交付物是否齐全。对长程任务,保留交付物版本和依赖标识也有助于中断后继续。这是基于论文通信方式提出的实现建议。
执行反馈为什么单独成为一个模块
只让模型审查代码,可能遗漏导入错误、接口不一致或运行条件。MetaGPT 初始实现也遇到了这类问题,因此加入执行反馈。
工程师依据需求和设计生成代码,编写并执行相应测试,读取结果。测试通过后推进后续任务;失败时结合历史消息、设计和代码继续修改。第 3.3 节把修正循环限制为最多 3 次重试。
这里的反馈来自实际运行,能够约束模型对“代码应该能工作”的判断。但生成测试也可能遗漏需求。如果实现和测试一起误解了问题,执行通过仍不能证明产品满足用户意图。论文中的单元测试反馈要与基准的最终评测区分。
HumanEval 与 MBPP 的成绩怎样看
论文使用 164 个 HumanEval 任务,以及实验选用的 427 个 MBPP Python 任务。图 4 报告下列 Pass@1:
系统 | HumanEval | MBPP |
|---|---|---|
MetaGPT,取消执行反馈 | 81.7% | 82.3% |
MetaGPT,加入执行反馈 | 85.9% | 87.7% |
差值 | 4.2 个百分点 | 5.4 个百分点 |
这组消融更直接地支持执行反馈的作用。Pass@1 指提交一个最终结果通过评测的表现,系统在提交前可以执行和修正;不能写成只调用一次模型、不看反馈的成功率。
图 4 还列了 GPT-4 的 67.0% HumanEval 基线。附录 C 明确说明它来自先前公布的成绩,随后补测 gpt-4-0613,在不同提示词与输出处理设置下,均分约为 72.4%、81.2% 和 80.0%。输出解析本身就能影响成绩,因此不能把 67.0% 到 85.9% 的全部差距单独归因于多角色协作。
阅读这一部分时,应检查底座版本、提示词、代码提取方式、执行次数和最终测试是否相同。跨论文的柱形图适合提供历史背景,同一系统内部的模块消融更有助于定位机制收益。
SoftwareDev 衡量的是软件交付
SoftwareDev 包含 70 个软件开发任务,覆盖小游戏、图像处理、可视化等。论文主要比较中又选出 7 个代表任务,不能把所有表格都理解为同一个 70 任务完整评测。
它采用人工可执行性评分、运行时间、token 使用量、代码统计和人工修改次数。可执行性评分范围为 1—4:从无法工作,到可运行但不完善,再到基本符合预期,最后为完全符合预期。均分 3.75 不等于 93.75% 的项目正确率。
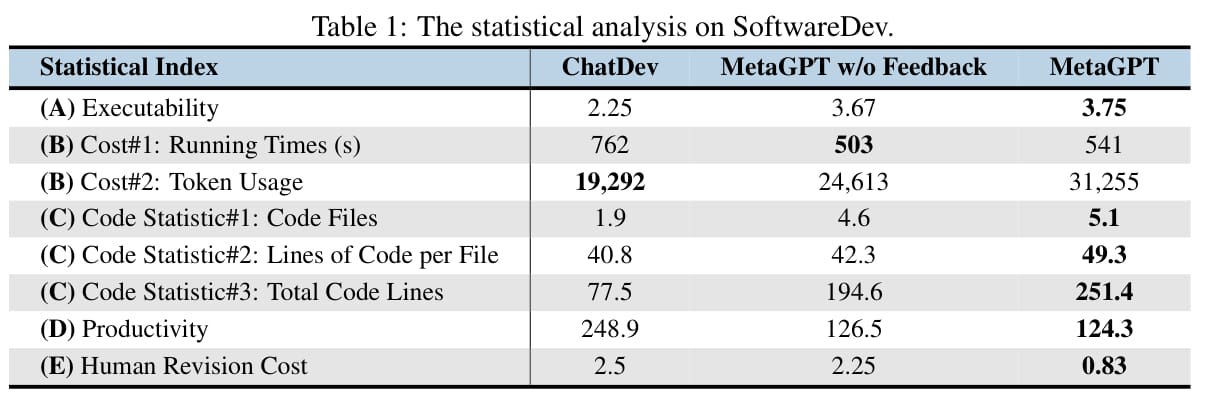
图源:原文表 1,PDF 第 8 页。表中完整 MetaGPT 的运行时间为 541 秒,503 秒对应取消反馈的版本。阅读时按表格区分两种设置,避免混用正文附近的概括描述。
表 1 指标 | ChatDev | MetaGPT 无反馈 | MetaGPT |
|---|---|---|---|
可执行性均分 | 2.25 | 3.67 | 3.75 |
运行时间,秒 | 762 | 503 | 541 |
token 使用量 | 19,292 | 24,613 | 31,255 |
人工修改次数 | 2.50 | 2.25 | 0.83 |
加入执行反馈后,运行时间和 token 消耗上升,人工修正次数下降。这组数据把自动检查的成本与人工工作量放在了一起,而不是简单地声称系统更快。
表中的 Productivity 定义为 token 使用量除以代码行数。它衡量每行生成代码的 token 消耗,不能直接证明代码更易维护或更符合需求。更多文件和代码行,同样不自动代表更好的软件。
附录表 4 中,7 个代表项目的 MetaGPT 可执行性评分均为 3 或 4;附录表 9 则报告无反馈版本在 70 个任务上的统计,包含缺失资源、依赖错误等问题。引言中的“100% 完成率”必须放在这些具体任务与评分口径下理解,不能延伸为任意项目无需人工检查都能交付。
角色消融能说明多少
第 4.4 节用两个任务比较角色组合。只有工程师时,可执行性评分为 1.0;加入产品、架构和项目管理角色后,一种完整组合达到 4.0,但费用也增加。
这个实验支持在所测任务中,需求整理、设计和任务分配能够帮助生成代码。样本只有两个任务,还不足以决定所有应用都需要五个角色。角色应承担明确的交付职责,规模小、依赖简单的任务可以使用更精简的流程。
复用时先建立什么约定
可以先为每个阶段写清输入、输出和验收条件。需求阶段列功能与约束,设计阶段列接口及依赖,实现阶段提交对应代码,验证阶段提供执行日志与失败位置。关键交付物保留版本,避免下游继续使用已经失效的设计。
然后把执行反馈接回具体责任角色。接口名称不一致时回到设计与实现核对,需求条件遗漏时回到 PRD,运行失败时保留日志和运行条件。不能把所有问题都交给最后一个“审查者”重新猜测。
验证方案可以固定同一模型和预算,逐步比较直接生成、加入结构化交付、再加入执行反馈的效果。除了通过率,还记录人工修正和重试开销。这是本文基于消融结果提出的项目验证方法,不是原文新增实验。
限制与阅读重点
论文附录指出,系统当时尚不能充分支持某些 UI 和前端场景,也缺少相应角色与多模态工具。复杂真实需求、人工中断以及为各角色设置恢复位置,仍存在困难。结构化工作流能够减少歧义,但上游错误仍可能沿依赖链传播。
MetaGPT 最有价值的设计是把协作结果落实为可消费的文档、接口、代码与执行反馈。首次阅读先看图 1—2 和第 3 节,再用图 4、表 1 和附录 C 检查成绩来自哪些设置。复用时从交付契约和依赖开始,角色名称随后再确定。
来源:MetaGPT 论文 v7,第 3—4 节、图 1—4、表 1—3、附录 C—D。版本化交付和错误回流方案属于阅读后的工程建议。