Chain-of-Thought Prompting Elicits Reasoning in Large Language Models 论文阅读
摘要
解释思维链提示的示例结构、生成过程与规模条件,结合算术结果、消融和错误分析理解中间步骤的作用,并区分语言推导与环境反馈。
一道多步计算题的答案,依赖前面几次状态更新都正确。直接预测最终数字时,语言模型可能跳过关键关系。Chain-of-Thought Prompting Elicits Reasoning in Large Language Models 在少样本示例中加入中间推导,再让模型沿同样形式回答新问题。思维链(Chain of Thought,CoT)因此把问题到答案之间的过程变成了模型继续生成时可利用的上下文。
论文的主要贡献是用实验验证这种提示方式:足够大的当时模型,在算术、常识和符号推理任务上获得明显改善,不需要针对每项任务重新微调。方法同时存在条件:小模型收益有限,流畅推导也可能错误,正确答案未必意味着推导忠实或可靠。理解这篇工作,需要一起看提示结构、模型规模、消融实验和错误分析。
速读信息 | 内容 |
|---|---|
论文 | Chain-of-Thought Prompting Elicits Reasoning in Large Language Models |
作者 | Jason Wei、Xuezhi Wang、Dale Schuurmans 等 |
会议 | NeurIPS 2022,所读 PDF 首页注明 |
阅读版本 | arXiv:2201.11903v6,首次提交 2022-01-28,版本日期 2023-01-10 |
原文 | |
方法 | 少样本提示中的输入、中间推导、答案三元组 |
评测 | 算术应用题、常识推理、符号操作;主要指标是题目解决率 |
阅读前提 | 自回归生成和少样本上下文学习 |
提示结构改变了哪一步
标准少样本提示给出问题与答案,然后让模型回答新问题。CoT 的示例还包含问题如何拆解以及中间量如何计算。新问题的生成同样先产生中间步骤,再给答案。
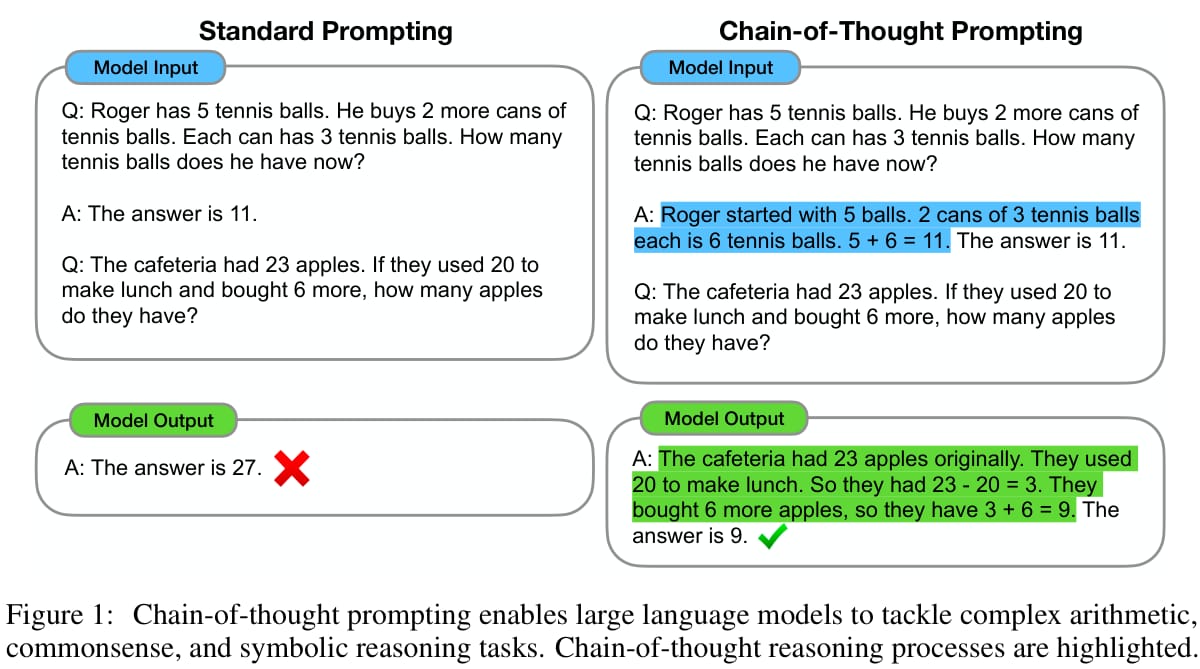
来源:原论文图 1,PDF 第 1 页。右侧的示例把分步计算写入上下文;新问题的中间步骤随后进入后续 token 的生成条件。
图中食堂原有 23 个苹果,用掉 20 个,再买 6 个。对应过程是先更新剩余量为 3,再更新为 9。标准提示示例只展示最终答案,CoT 示例展示关系和状态变化。原图中的错误回答展示方法动机,整体有效性仍要由测试集实验支持。
可以将推理路径记为 问题 → 中间步骤 → 最终答案。模型生成某一步后,该步骤成为下一步的上下文。这为多步任务提供了显式的中间表示,也增加了输出计算量。原文没有证明自然语言步骤完整反映网络内部计算;生成文本可以帮助观察错误,但解释忠实性仍是开放问题。
具体怎么做:示例、生成与答案提取
算术任务的主要提示使用 8 个作者编写的示例。每个示例包含题目、推导和答案,同一组示例用于多个算术基准。AQuA 是选择题,采用来自训练集的 4 个示例,格式和其他数据集不同。
模型在测试时接收示例和待解决题目,自回归生成解释及最终答案,再按任务格式计算解决率。论文没有在这个过程中微调模型,也没有在主实验中增加搜索树、外部计算器或多条路径投票。后续自一致性采样可以改进这一过程,但它属于另一项机制,不能混进本文主结果。
下面用自拟的短例子说明输入输出结构,数值只用于讲解:
原论文的实际评测使用其英文提示与相应模型设置。中文示例只解释结构,不代表复现了英文基准成绩。
实验设计:既比较提示,也比较模型规模
算术评测包括 GSM8K、SVAMP、ASDiv、AQuA 和 MAWPS。它们对多步推理、问题结构、代数选择和题目难度的要求不同。论文考察 GPT、LaMDA、PaLM 等模型系列,也报告 UL2 与 Codex 的结果。
主要设置采用贪心解码。LaMDA 对不同示例顺序运行 5 个随机种子并取平均;其他模型主要使用单一示例顺序,以降低计算成本。比较结果时要同时记住模型、数据集、提示和解码方式,不能只摘一个最高分。
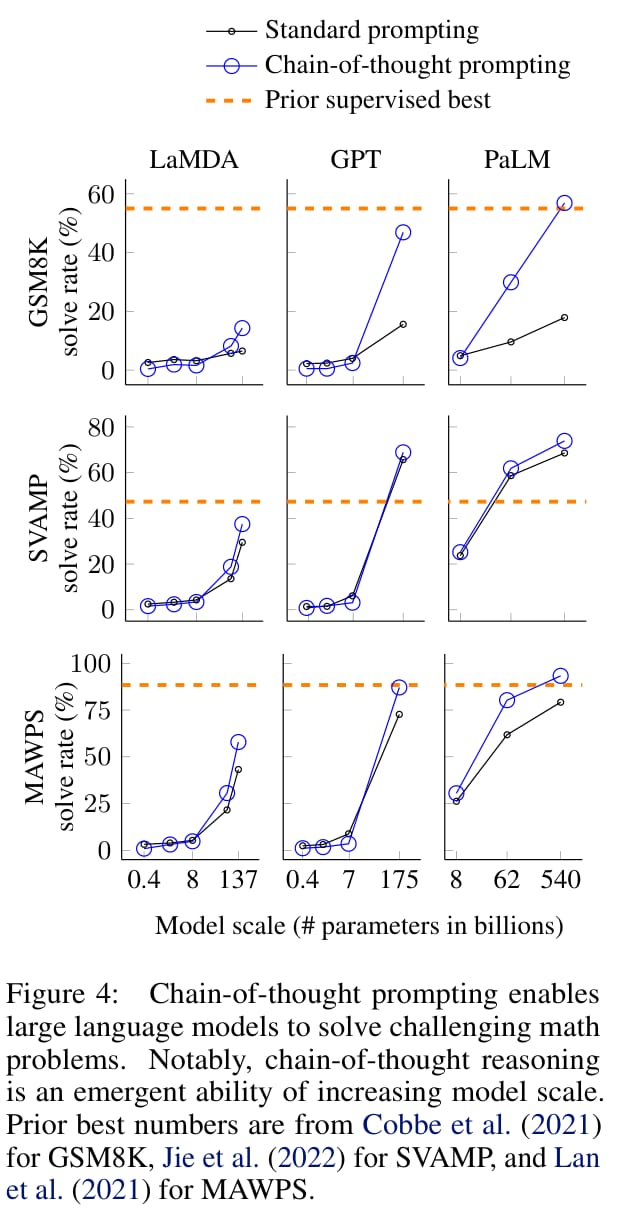
来源:原论文图 4,PDF 第 5 页。横轴为各系列模型规模,纵轴为解决率,蓝色曲线是 CoT,黑色曲线是标准提示。
图 4 的主要关系是收益随规模和任务难度变化。当时较小模型可以生成语言流畅、逻辑却不成立的步骤;多步任务的改善通常大于简单单步题。这里的参数规模规律来自论文所测模型,不能直接用作所有后续模型的通用阈值。
附录表 2 提供精确结果。以下固定 PaLM 540B,比较两种提示的解决率:
任务 | 标准提示 | CoT | 变化 |
|---|---|---|---|
GSM8K | 17.9% | 56.9% | +39.0 个百分点 |
SVAMP | 69.4% | 79.0% | +9.6 个百分点 |
ASDiv | 72.1% | 73.9% | +1.8 个百分点 |
AQuA | 25.2% | 35.8% | +10.6 个百分点 |
MAWPS | 79.2% | 93.3% | +14.1 个百分点 |
来源:原论文附录表 2,PDF 第 21 页。GSM8K 的大幅变化支持复杂算术任务能受益于中间步骤;ASDiv 的较小变化也说明收益并不一致。表中比较是同一底座的提示实验,不代表所有任务中 CoT 都领先于训练过的专门模型。
消融:中间步骤的内容与顺序都有作用
论文检验了三种替代解释。只让模型生成方程,检查自然语言关系是否必要;让模型输出无信息的点号,检查额外生成量是否足够;把推导放在答案之后,检查是否仅由示例里出现解释文字带来收益。
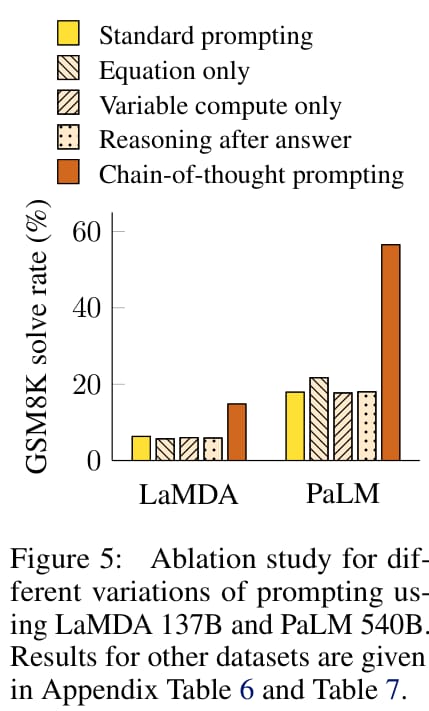
来源:原论文图 5,PDF 第 6 页。比较 LaMDA 137B 和 PaLM 540B 在 GSM8K 上的表现,完整 CoT 的收益更明显。
只写方程在 GSM8K 上帮助有限,但可以改善部分较简单任务。无信息点号与答案之后的推导接近标准提示。因此,这些实验支持任务相关的中间步骤及其生成顺序有作用。它们没有排除所有潜在解释,也不足以构成关于模型内部推理机制的完整理论。
原文还改变了推导作者、简洁程度、示例集合和顺序。图 6 表明多种写法都能优于标准提示,同时仍有提示敏感性。实践中应测量不同示例选择的方差,不能只选一次运行成功的提示作为结论。
常识与符号任务补充了什么证据
常识评测包括 CommonsenseQA、StrategyQA、日期理解、体育理解和 SayCan 的动作序列任务。论文在若干任务上看到改善,也明确指出 CommonsenseQA 的增益较小。这说明中间推导的价值取决于任务是否需要组织多步关系,而非所有问答一律受益。
符号任务包括词尾字母拼接和硬币状态变化。论文让模型在示例中看到较短操作序列,再在测试中处理更长序列,以观察长度泛化。CoT 在足够大的所测模型上改善这种泛化,但任务结构简单、生成过程可控,不能据此推断真实长期 Agent 任务已经解决。
SayCan 数据上的语言动作序列也是受限评测。生成一个合理动作列表还需要环境能力检查和实际执行结果,才能形成完整的具身 Agent。
错误、成本与方法边界
作者对 LaMDA 137B 的 GSM8K 输出做了人工抽查。50 个最终答案正确的样本中,有 2 个推导存在问题但碰巧得到正确答案;50 个错误答案中,46% 的推导接近正确,剩余部分存在更严重的理解或连贯性问题。这是有限样本分析,不能当作全体错误的精确分布。
CoT 让错误位置更容易观察,但也增加了生成长度、延迟和 token 成本。论文没有给出完整端到端总计算量的核算,大模型服务成本本身也是限制。简单单步题可能无需长推导。
另一个边界是可靠性:中间步骤仍由模型生成,步骤中出现事实或算术错误后,后续步骤可以继续沿错误状态生成。文本看起来合理,不足以替代外部验证。论文第 6 节也明确保留了模型是否真正推理、如何确保正确路径及如何把能力迁移到更小模型等问题。
对 Agent 学习的启发
CoT 给后续 Agent 方法提供了一个可复用的中间表示。系统可以观察模型当前在推导什么,再增加行动、检索、工具结果或路径搜索。ReAct 引入环境反馈,Tree of Thoughts 引入候选路径的评价与搜索;这些额外机制分别解决新的问题。
复现实验时,可以先固定模型、题目集合、解码和答案提取,仅改变标准示例与含推导示例。除了答案准确率,也记录推导中的错误位置、输出长度和运行时间。接着将外部计算器或执行反馈单独作为新变量加入,观察收益是否来自提示结构、工具能力或更大的预算。
本文的数据属于所读历史版本,不能当作当前模型排名。最直接的学习动作是检查一组多步任务:哪些失败来自缺少中间状态,哪些来自错误知识,哪些需要环境反馈。只有第一类问题可以期望单靠提示改写获得明显改善。
来源
原论文 arXiv:2201.11903v6,依据第 2—6 节、图 1、4、5、6 与附录表 2、3。
所有精确数值来自原文;本文没有运行模型复现,也没有把后续采样或工具机制合并进原论文成绩。