
Gorilla: Large Language Model Connected with Massive APIs 论文阅读
摘要
解析 API 文档、合成指令、检索感知微调和 AST 评测之间的关系,讨论检索错误、文档更新、约束满足与调用生成的证据边界。
用户描述了一个任务,模型还要选择正确接口、填写参数,并遵守版本和资源条件。Gorilla: Large Language Model Connected with Massive APIs 将这个问题转成 API 文档、用户指令与调用代码之间的学习:用文档构造指令数据,微调 LLaMA-7B,并在需要时检索相关文档供模型参考。
论文同时提出 APIBench 与基于抽象语法树的评测,区分选择错误接口和生成数据库中不存在的接口。它的研究范围主要是机器学习模型库中的单次调用,不包含任意 API 的自动发现、多轮组合与可靠端到端执行。检索能提供新信息,也可能把错误文档带给模型,这是理解实验结果的关键。
速读信息 | 内容 |
|---|---|
论文 | Gorilla: Large Language Model Connected with Massive APIs |
作者 | Shishir G. Patil、Tianjun Zhang、Xin Wang、Joseph E. Gonzalez |
阅读版本 | arXiv:2305.15334v1,2023-05-24 |
原文与项目 | |
底座 | LLaMA-7B,指令微调与文档感知训练 |
资料范围 | Torch Hub、TensorFlow Hub、Hugging Face 的模型调用 |
评测对象 | 单次 API 调用的结构匹配、虚构接口及约束遵循 |
从文档到调用:训练与推理链路
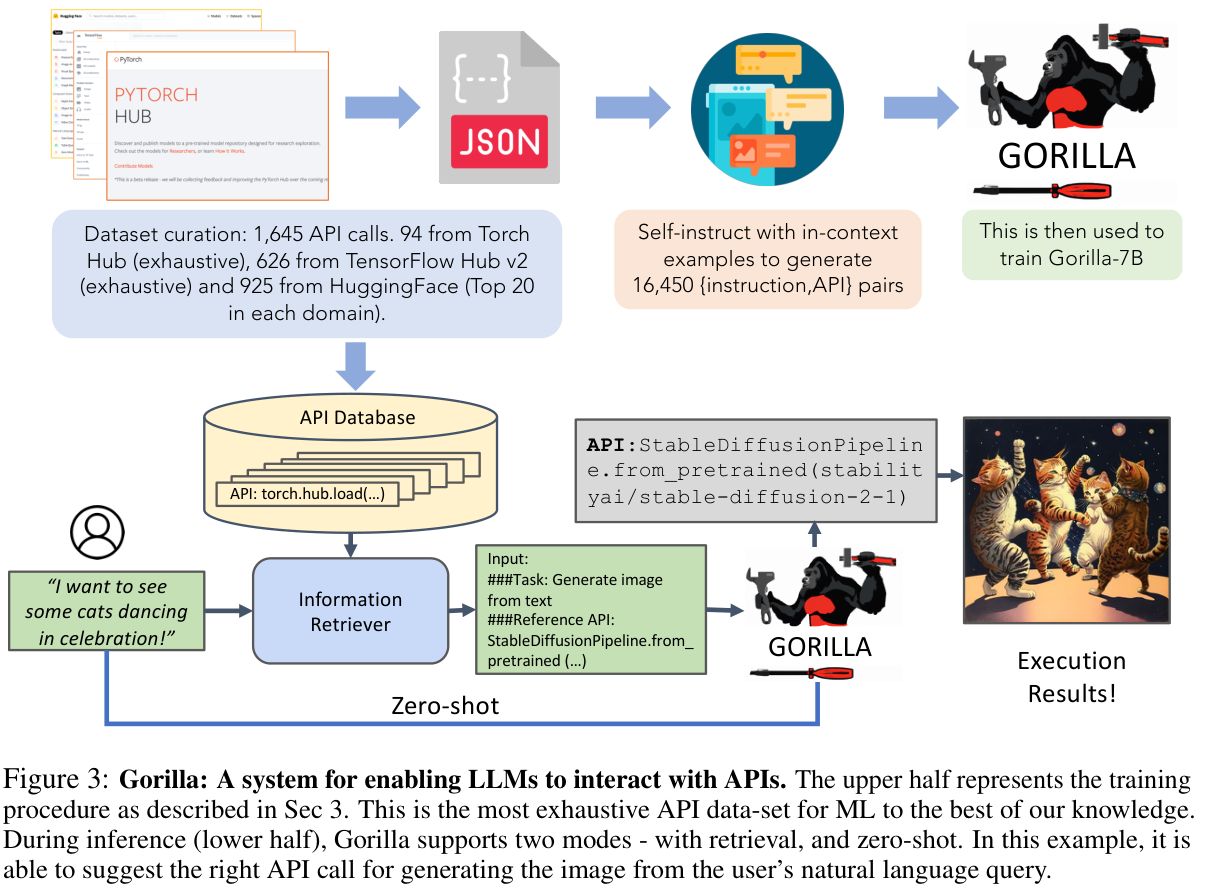
来源:原论文图 3,PDF 第 4 页。上半部分构造训练数据,下半部分展示带检索与不带检索的推理模式。
作者将模型文档整理为结构化条目,包括领域、框架、功能、API 名称、参数、环境要求、示例代码和性能。图 3 给出的汇总是 1,645 个接口:94 个 Torch Hub、626 个 TensorFlow Hub 和 925 个 Hugging Face 条目。所读早期版本的部分文字存在统计口径不一致,本文采用这张数据流程图的汇总,不把它扩展成实际测评了数百万 API。
接着,每个条目用少量人工示例引导 GPT-4 生成 10 条用户指令,构成 16,450 对指令与 API。要求生成指令不直接泄露 API 名称,避免将任务变成照抄接口字符串。人工示例减少数据编写负担,合成数据仍受教师模型与原文档质量限制。
普通微调模式仅给任务指令;文档感知模式还把参考 API 文档放进输入,让模型学习从描述中选择接口、填写参数。推理时,可以不检索,也可以由检索器选择相关文档后再生成。
例如要求调用图像分类模型,文档提供加载函数、仓库名和模型标识;若附加参数量或精度条件,系统还需要读取文档中的性能字段并筛选。这个过程输出的是调用建议,执行正确性还涉及安装环境、文件和版本。
评测需要区分正确性与两类错误
抽象语法树(Abstract Syntax Tree,AST)把代码转成结构。论文从模型输出中定位关键调用,再按数据库定义的必需参数与参考结构比较。
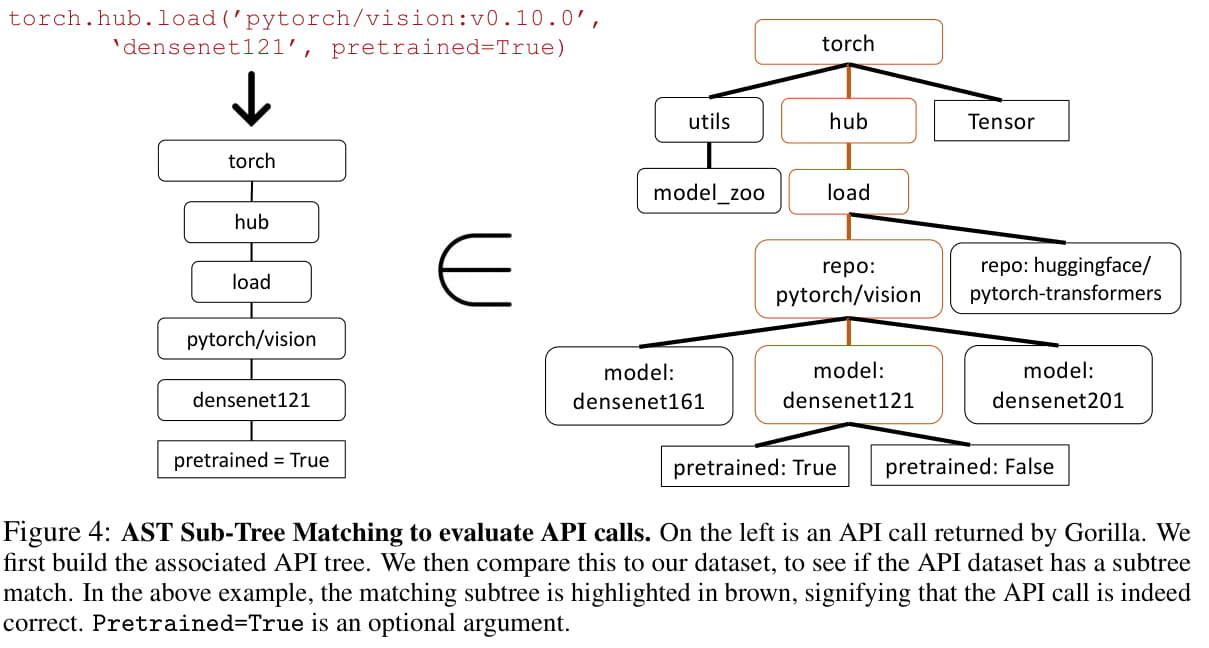
来源:原论文图 4,PDF 第 6 页。图中检查加载函数、仓库和模型标识,部分可选参数不作为匹配要求。
调用某个实际存在但不符合任务的接口属于错误;调用无法对应数据库条目的接口被记为 hallucination。这里的幻觉定义依赖 APIBench 数据库,不能自动等同于任意互联网接口是否真实存在。数据库之外的有效接口也需要额外处理,尤其当资料库并不完备时。
AST 匹配比整段代码字符串相等更能容忍格式差异,但仍不证明运行成功。它不会完整验证依赖、设备、模型下载、输入类型或用户目标是否真的完成。被排除的可选参数也可能影响实际行为,需要与评测口径分开考虑。
检索实验:提供文档并不保证改进
论文比较不检索、BM25、GPT-Index 和 oracle 文档。前两种实际检索器可能选择错误或不完整文档;oracle 直接提供相关参考,主要用于观察上限和定位检索瓶颈。
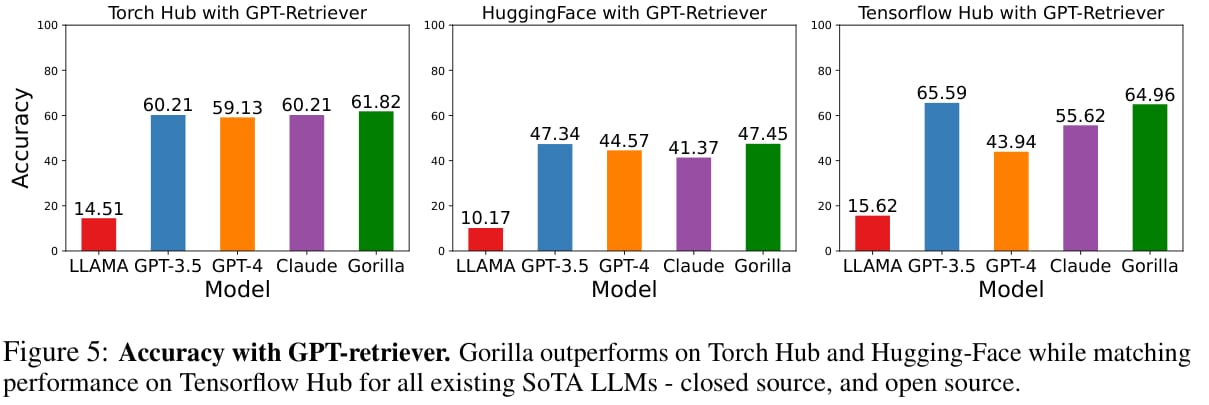
来源:原论文图 5,PDF 第 7 页。不同模型、平台和评价方式需要分别解释,不能将柱状图直接视为通用代码能力排名。
在 Torch Hub 的 GPT-Index 设置中,表 1 给出 GPT-4 的准确率 59.13%、Gorilla 的准确率 61.82%;幻觉列分别是 1.07% 与 0%。这是 gpt-4-0314 等历史模型与该资料库的比较,不能代替当前版本表现。
TensorFlow Hub 的同类设置中,GPT-3.5 为 65.59%、Gorilla 为 64.96%,说明不同平台与基线并非一律被 Gorilla 超过。Hugging Face 部分对非 Gorilla 基线只检查任务领域等较宽条件,原文第 4.1 节明确了这一差异,因此本文不将该列成绩当作完全同口径的调用级比较。
检索感知训练的重要性体现在表 2。没有参考文档训练过的模型,在测试时突然加入不理想的文档,表现可能下降。文档感知训练配合准确参考更好,实际检索仍存在明显缺口。系统应该分别测量文档是否选对,以及模型是否正确利用了已经选对的文档。
文档更新和约束遵循是另外两项能力
原文图 6 修改参考模型标识或仓库来源,观察生成调用是否随之变化。这支持模型能够依据提供的文档调整输出,但它是有限更新示例,不能保证每一种破坏性 API 变更都能自动适应。新文档必须先进入资料库并被正确检索。
约束实验让用户提出分类任务和精度条件,例如至少达到某个 ImageNet top-1 准确率。模型需要选择同时满足功能与数值限制的接口。合法调用、任务匹配和约束满足是三个不同标准,原表也分别给出对应结果。
模型卡中的精度来自特定数据与训练设置,不能直接转成用户新数据的效果承诺。参数量也不能单独代表延迟、显存或完整部署成本。
局限与工程复用
所读版本主要处理一次调用,并未研究完整 API 链的依赖、失败恢复或提交副作用。APIBench 多为模型库资料,用户指令由合成数据产生,真实请求的模糊性和多样性可能不同。原文训练与测试按指令—接口对划分,也需要进一步区分已见接口的新表述与未见接口泛化。
对自己的工具系统,最可复用的是文档结构和分层评测。先核对任务路由是否正确,再看参数和约束,再在允许环境中验证运行输出。固定资料库版本与检索器,分别测量文档召回、调用准确率、数据库外接口、执行成功和目标满足率。
工具变更时,更新版本化文档并重新检查调用,不仅修改提示名称。若模型看到正确文档仍生成旧参数,应检查训练与推理格式;若文档根本没有被召回,应先解决检索。两种失败需要不同的改动。
来源
原论文 arXiv:2305.15334v1,依据第 3—4 节、图 3—6、表 1—3。
Gorilla 作者项目页。本文聚焦所读历史论文版本,未把项目后续能力混入原实验。