
Toolformer: Language Models Can Teach Themselves to Use Tools 论文阅读
摘要
解释 Toolformer 如何通过候选调用、真实执行、损失过滤和微调学习工具使用,分析训练收益、运行时工具收益、单次调用限制与数据成本。
模型生成一段涉及事实、日期或计算的文字时,往往缺少准确的外部信息。Toolformer: Language Models Can Teach Themselves to Use Tools 的做法是在语言建模语料中自动插入候选工具调用,执行调用,再根据返回结果是否降低后续文本的预测损失筛选样本。随后微调模型,使它学习调用时机、工具类型和参数。
这项工作的核心贡献是工具学习的数据构造机制。少量人工示例用于启动候选生成,大量训练标注通过模型生成与工具执行获得。它实际更新模型参数,区别于只在推理时增加工具描述或反思上下文的方案。论文还比较启用与禁用工具时的表现,以区分训练收益和外部信息收益。
速读信息 | 内容 |
|---|---|
论文 | Toolformer: Language Models Can Teach Themselves to Use Tools |
作者 | Timo Schick、Jane Dwivedi-Yu、Roberto Dessì 等 |
阅读版本 | arXiv:2302.04761v1,2023-02-09 |
原文 | |
底座 | 原文使用 GPT-J;以 PDF 的模型设置与表格为准 |
工具 | 问答、维基百科搜索、计算器、翻译、日历 |
核心训练信号 | 工具结果对后续原文预测损失的改善 |
训练过程:生成、执行、过滤,再微调
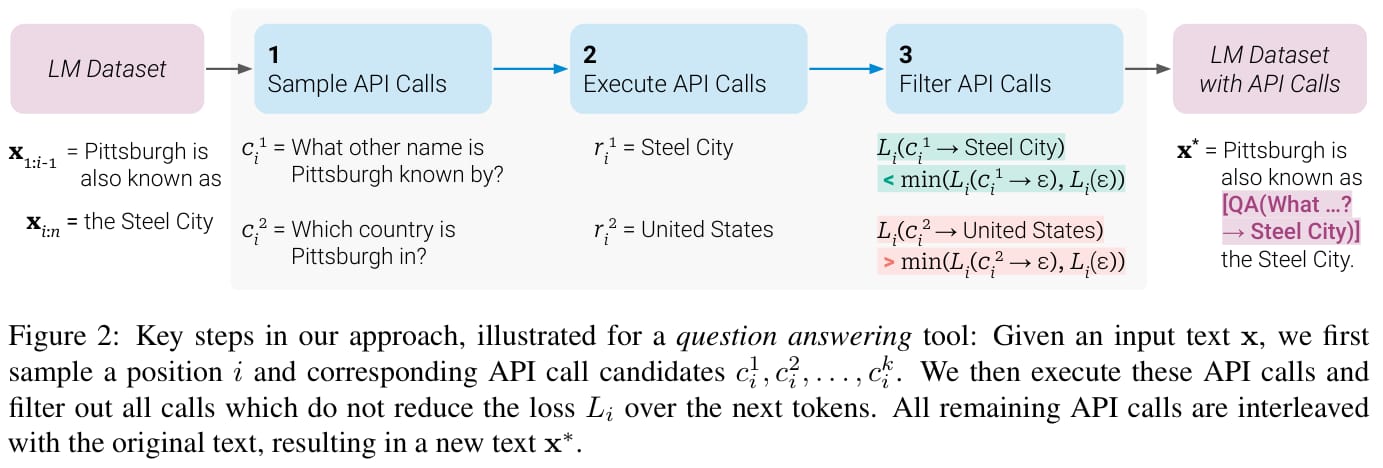
来源:原论文图 2,PDF 第 2 页。问答结果若有助于预测后续的原始文本,对应调用就更可能被保留。
首先,作者为每种 API 写少量调用示例,提示模型在原文合适位置提出调用。模型估计哪些位置适合开始 API 序列,并采样工具参数。其次,真正执行这些调用,把返回内容转成文本。最后,对比有返回值、仅有调用输入以及没有调用三种情况的后续预测损失。
通过过滤的调用与结果插入原文,形成增强语料,再按语言建模目标微调。训练覆盖调用语法与结果使用,但执行工具的能力来自外部接口。模型不能凭生成一段 API 字符串自行完成查询或计算,运行时仍需要拦截、执行和结果回填。
过滤信号为什么能筛选调用
设当前位置之后原文 token 的加权预测损失为 L。带调用和结果的损失记作 L+,不带工具或仅带调用输入两种损失中的较小者记作 L−。仅当 L−−L+ 达到过滤阈值时保留调用。
这里比较仅含调用输入,避免把收益全归给问题本身提供的提示。对后续 token 加权,则让信息价值更多集中在调用附近。阈值会影响保留样本数量,也影响噪声与有效调用的比例。
以原图中的 Pittsburgh 为例,查询城市别名得到 Steel City,会帮助模型预测紧接着的原文;查询所在国家得到 United States,未必帮助补全城市别名,因此可能被过滤。这种任务相关性由后续文本的预测改善衡量。
该信号有局限。原文既可能包含错误事实,也可能缺少工具使用后的正确结果;能够降低文本损失的调用未必是实际最合理的行动。数据质量分析中也发现一些看起来无用却降低损失的调用,说明过滤不是完美语义判定器。
工具类型与推理时控制
工具 | 外部能力 | 论文中的限制 |
|---|---|---|
问答 | 检索增强问答系统返回事实 | 依赖其自身知识和准确性 |
搜索 | BM25 从维基百科返回片段 | 模型自行提取相关信息 |
计算器 | 执行四则运算 | 返回结果按规定精度处理 |
翻译 | 将其他语言转为英文 | 源语言自动检测,目标语言固定 |
日历 | 给出当前日期 | 日期本身不能解决全部时间事实问题 |
推理时,模型生成调用序列后暂停,运行器执行 API,将结果插回文本,再继续生成。论文使用类似特殊标记的文本序列表示调用,不要求修改原模型词表。
主评测还改变了贪心解码:只要开始调用的 token 落在前 k 个候选中,就允许触发工具,主要采用 k=10。同时,每个输入最多一次工具调用,以避免不断调用而不输出。这个限制影响能力解释:它尚不是可多轮组合工具、不断改写查询的完整 Agent。
结果:训练收益和工具收益分开看
论文比较原始 GPT-J、在普通 CCNet 子集上继续训练的 GPT-J、Toolformer 禁用工具,以及 Toolformer 启用工具。禁用工具保留了模型微调后的能力,但不能在推理时取得外部返回值。
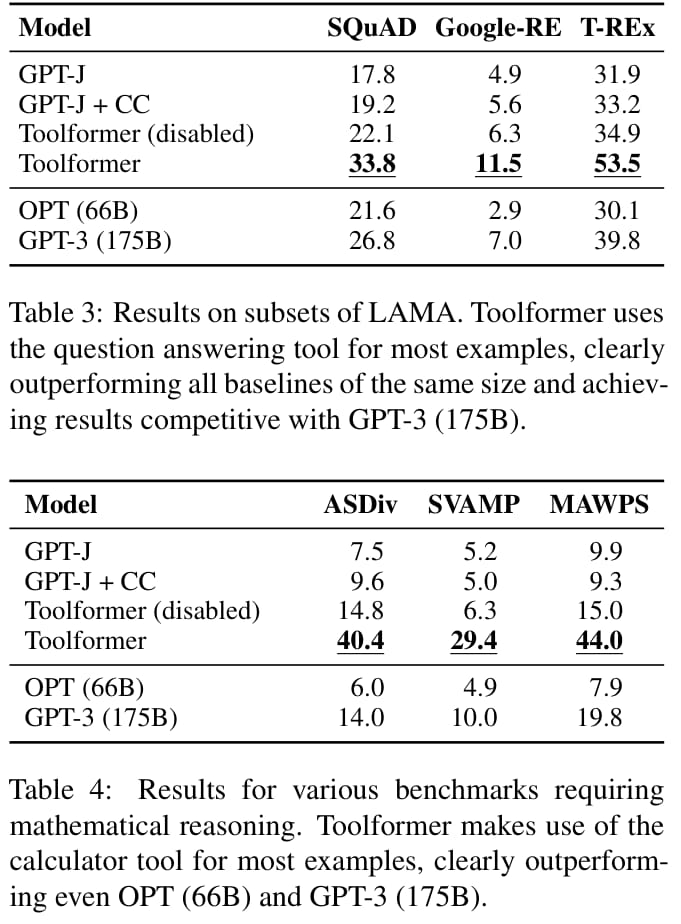
来源:原论文 PDF 第 6 页。Toolformer 与 disabled 两行的差异有助于识别运行时工具的贡献。
数学任务 | GPT-J | Toolformer 禁用工具 | Toolformer 启用工具 |
|---|---|---|---|
ASDiv | 7.5 | 14.8 | 40.4 |
SVAMP | 5.2 | 6.3 | 29.4 |
MAWPS | 9.9 | 15.0 | 44.0 |
来源:原论文表 4,数值为该评测的正确率百分数。评分提取模型生成的首个数字,涉及方程时按等号后的数字处理。这种答案提取比要求整个输出严格匹配更宽松,跨论文比较时必须保持口径一致。
启用计算器后收益很大,但仍需要模型正确选择操作与构造表达式。它减少了部分数值计算负担,没有自动保证题意理解正确。禁用工具后部分任务也改善,表明带调用结果的训练本身改变了底座能力。
LAMA 事实补全中,Toolformer 超过相同底座及所比较的大模型,但问答表 5 中,GPT-3 在 WebQuestions、Natural Questions 和 TriviaQA 上仍高于 Toolformer。不能把部分任务优势扩展为全面超过更大模型。
问答评测禁用了问答工具,以避免将被测试任务交给已经训练于相关数据的 QA 系统;LAMA 则禁用维基百科搜索以避免不公平优势。工具允许范围是成绩的一部分,遗漏这些约束会改变结论。
时间、多语言与语言建模的边界
翻译工具可以帮助理解非英文问题,但论文中 Toolformer 并未在所有语言上一致超过原始 GPT-J。继续训练语料分布变化也会影响原有能力,工具收益和数据迁移影响需要分别检查。
时间实验中,DATESET 的改善与日历调用有关;TEMPLAMA 涉及历史事实,更多收益来自搜索和问答。先查当前日期再查对应时间的事实,属于两个相互依赖的调用,主实验的一次调用限制不能支持这类流程。
语言建模表 8 显示,禁用工具时,增强语料训练没有比普通 CCNet 训练带来额外困惑度损失。但这项比较并不等于所有原能力完全保持。原文没有计算启用工具时对所有潜在调用边缘化后的困惑度,因为该计算不可行。
局限与工程启发
Toolformer 的训练信号依赖原语料后续文本,需要实际执行大量候选工具调用,再计算不同条件下的损失。少量人工示例减少的是标注需求,整个过程仍有模型推理、工具执行与微调成本,不能描述成没有训练代价。
独立采样的训练调用与单次推理限制,也使工具链依赖、查询改写和长期目标处理成为后续问题。外部工具若返回错误信息,模型可能利用它继续生成,因此应检查结果可靠性与错误处理。
可以从一个只读工具开始复用其思想:生成候选、执行并保留返回值、比较有无结果对目标文本预测的改善、检查过滤后的噪声,再用独立任务评价选择工具和使用结果的能力。最终还要测量调用率、正确率、延迟和费用,避免把更多调用误认为更聪明的工具选择。
这篇论文为工具学习提供数据方法,Gorilla 则更直接关注 API 文档与调用准确性。将两者比较时,可分别观察训练样本来源、工具范围、文档变化和评测目标,而非只看是否都能输出函数调用。
来源
原论文 arXiv:2302.04761v1,依据第 2—5 节、图 2、表 3—9。
本文没有训练或运行 Toolformer;比较数值限定于原文模型、工具限制与宽松答案提取方式。