
Language Agent Tree Search Unifies Reasoning Acting and Planning in Language Models 论文阅读
摘要
解析 LATS 如何将环境反馈、蒙特卡洛树搜索与反思组合,结合问答、编程和购物结果讨论 oracle 反馈、内部搜索预算以及状态恢复的应用边界。
推理树中的候选看起来合理,执行工具后却可能得到完全不同的结果。Language Agent Tree Search Unifies Reasoning Acting and Planning in Language Models 将真实环境观察加入搜索节点,用语言模型提出行动和评价状态,再通过蒙特卡洛树搜索与失败反思选择后续路径。Language Agent Tree Search(LATS,语言 Agent 树搜索)把尝试、观察和路径统计组织成了同一个推理时过程。
它的主要贡献是将搜索适配到语言 Agent:节点保留动作与观察,评价同时利用语言模型分数和自一致性信号,终局反馈更新路径价值,失败轨迹再生成反思。论文在多跳问答、编程、购物环境和 24 点任务上测试这一组合。结果需要注意反馈来源和重试预算,尤其是正确答案反馈与环境可回退两项假设。
速读信息 | 内容 |
|---|---|
论文 | Language Agent Tree Search Unifies Reasoning Acting and Planning in Language Models |
作者 | Andy Zhou、Kai Yan、Michal Shlapentokh-Rothman、Haohan Wang、Yu-Xiong Wang |
阅读版本 | arXiv:2310.04406v3,PDF 版本日期 2024-06-06 |
原文 | |
方法 | 语言动作与观察树、MCTS、状态评价、终局反馈和反思 |
任务 | HotpotQA、HumanEval、MBPP、WebShop、24 点 |
阅读前提 | ReAct、思维树和探索与利用的取舍 |
节点里需要保存环境发生了什么
LATS 的状态包括原始问题、已有动作和对应观察。思想文本用于组织信息,外部动作则改变环境或调用工具。模型可以在同一状态下提出多个下一步候选,分别执行并取得观察,再决定哪条路径更值得继续。
例如多跳问答,候选可以是不同搜索关键词。搜索页面返回的信息成为各自节点的组成部分。若没有保存观察,评价器只能评价行动文字是否合理,无法判断搜索是否真的找到了所需证据。
这一设计延续 ReAct 的推理与行动接口,并增加了搜索。纯推理版本可以用 CoT,带环境版本使用 ReAct。论文还测试先进行内部推理、失败后再转向检索的组合。它们是不同设置,成绩不能合并成一个不注明条件的数字。
六项操作如何形成一次搜索
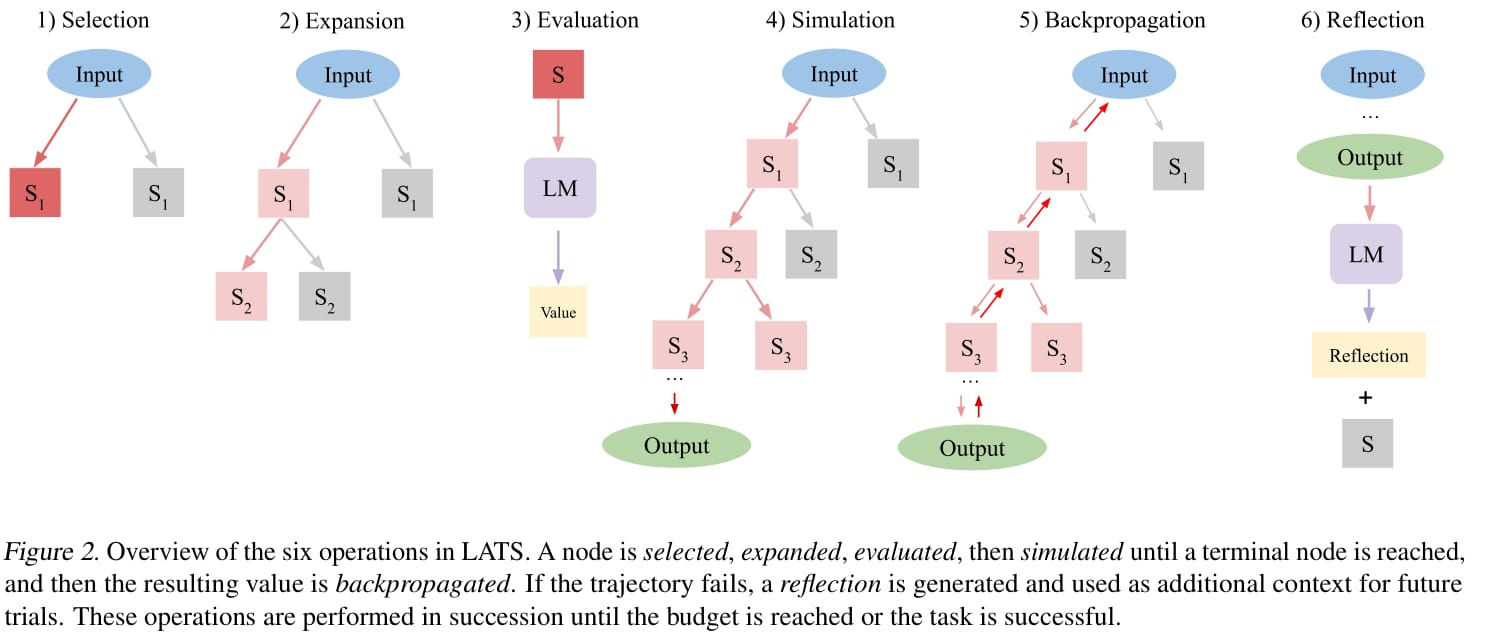
来源:原论文图 2,PDF 第 5 页。一次轨迹结束后,数值反馈影响搜索统计,语言反思影响后续提示。
选择从根节点沿树找到要扩展的部分。扩展从当前上下文采样多个行动,交给环境执行,加入新的子节点。评价根据动作后的观察估计进度,模拟继续展开到终局。随后,将终局奖励沿路径回传;失败时额外总结哪里出错和可以采用什么替代动作。
操作 | 更新的对象 | 主要信息来源 |
|---|---|---|
选择 | 当前探索路径 | 节点价值与访问次数 |
扩展 | 动作及观察子节点 | 语言模型与环境 |
评价 | 候选价值 | 状态内容与采样一致性 |
模拟 | 到终局的轨迹 | 后续动作和反馈 |
回传 | 价值与访问统计 | 终局奖励 |
反思 | 下一轮上下文 | 失败轨迹和结果 |
蒙特卡洛树搜索(Monte Carlo Tree Search,MCTS)需要平衡高价值路径与未充分尝试的路径。论文采用 UCT(Upper Confidence bounds applied to Trees,树上的置信上界)选择规则:已有价值较高的节点有优势,访问较少的节点获得探索奖励。这个统计规则与语言评价器承担不同功能。
候选初始评价结合两项信号:语言模型判断状态是否正确,以及同一状态下某个行动重复出现的程度。原文写作 V(s)=λ·LM(s)+(1−λ)·SC(s),其中 λ 控制两种信号权重。重复出现只是启发式置信线索,模型可以稳定重复一个错误动作。
回传更新的是搜索树中的价值估计,反思更新的是上下文。LATS 的主方法没有因此反向传播更新底座模型权重,不能把这一过程写成模型接受了新的梯度训练。
多跳问答:高质量反馈是实验条件
HotpotQA 实验使用 100 个问题,每种方法提供 3 个示例,主要搜索设置扩展 5 个子节点、最多 50 条轨迹。工具提供搜索与信息获取接口,最终答案用精确匹配(Exact Match,EM)评估。
该实验还使用 oracle 反馈:环境能够告诉 Agent 答案是否正确。它便于比较不同方法利用反馈的能力,但真实检索任务往往没有这种答案判定器。这一条件必须保留在结果解释中。
GPT-3.5 方法 | HotpotQA EM |
|---|---|
ReAct | 32% |
ReAct,多次轨迹选择 | 38% |
Reflexion | 51% |
LATS,以 ReAct 为基础 | 63% |
LATS,CoT 与 ReAct 组合 | 71% |
来源:原论文表 3。组合版在内部推理失败后改用检索,不能将 71% 写作单一路径 ReAct 的成绩。同一轨迹数也不代表相同 token 或工具调用数,树分支还引入额外评价。
编程与购物:反馈内容决定搜索方式
编程实验使用模型生成的测试断言、编译输出和执行结果作为可观察反馈。每个候选动作是一份完整程序,因此无需像多步浏览一样继续模拟动作序列。最终选出的一个程序再交给真实测试集评分。
原文 HumanEval 中,GPT-4 底座为 80.1%,Reflexion 为 91.0%,LATS 为 92.7% pass@1。LATS 搜索最多 8 次迭代,每次扩展采样 5 份解法。因此,这里的 pass@1 指最终提交一份程序的评测口径,内部已经使用多个候选和测试反馈,不能解释为模型第一次生成代码的成功率。
合成测试也可能错误或覆盖不足,系统对这些测试取得高分,并不保证通过隐藏测试。论文在最终真实测试上评价,才把搜索阶段信号与最终成绩区分开。
WebShop 要根据需求选择满足属性的商品。观察来自浏览器,动作是搜索与点击,结果分为属性匹配得分和满足全部条件的成功率。
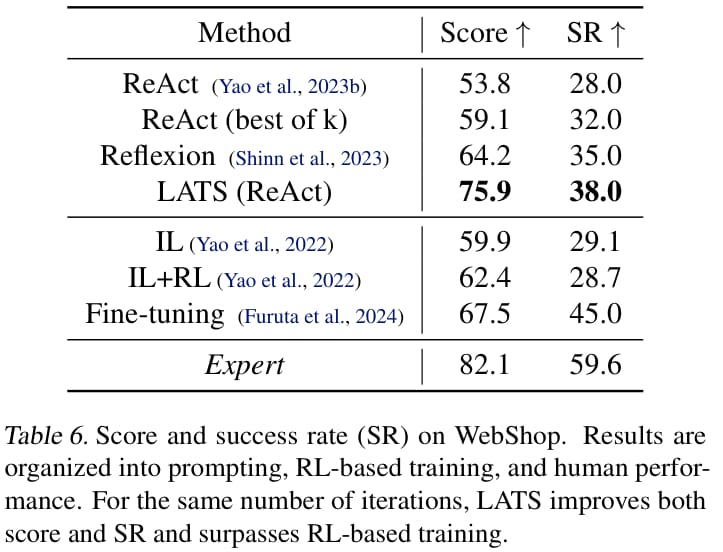
来源:原论文表 6,PDF 第 8 页。高属性匹配分数不等同于完成所有条件。
测试使用 50 条指令,LATS 扩展 5 个子节点,相关多次尝试方法最多 30 条轨迹。ReAct 的得分与成功率为 53.8 和 28%,LATS 为 75.9 和 38%。平均得分增加 22.1,成功率增加 10 个百分点。
表中微调方法的成功率为 45%,高于 LATS 的 38%,虽然其平均得分较低。选择指标会改变比较结论,不能把较高的平均属性分数概括成每种成功指标都最好。原文也指出购物中的反思有时泛泛而谈,替代路径搜索能补充反思的不足。
消融、成本与可恢复状态
HotpotQA 消融表 8 中,完整 LATS 为 63% EM,去掉反思为 58%,换成 DFS 为 42%,去掉语言模型启发式为 37%。这些比较支持具体组件对所测设置有作用,不能保证每项任务都需要同样比例的机制。
表 9—10 比较了不同树搜索的 token 与节点消耗。LATS 在这些比较中使用较少的节点达到成功,但作者同时承认,相比简单 ReAct 或 Reflexion,它仍有较高计算成本。局部胜过另一种搜索方法,不等于总体费用低于所有方法。
更重要的条件是环境能恢复到早先状态。文本题可以复制上下文,测试环境可以重置,真实购物提交、邮件发送或数据库写入可能不可撤销。搜索树中的模拟不能不加区分地执行这些真实动作。将 LATS 用于工程系统时,应先区分只读试探、沙箱执行与实际提交,并保留可靠的目标验证。
对实践的启发
LATS 适合研究有可观察反馈、可恢复状态和明确目标验证的任务。可以先在代码沙箱或只读检索中实现动作—观察节点,再固定模型与总预算,比较单路径、失败反思和带搜索的组合。
记录结果时同时保留成功率、候选数量、工具调用、token 与时间,并检查评价器是否把错误结果判为高价值。若真实任务无法提供 oracle 答案反馈,应替换为实际可取得的验证信号,再重新测量,不能沿用论文的问答成绩作为部署预期。
来源
原论文 arXiv:2310.04406v3,依据第 4—6 节、图 2、表 2—10。
本文没有运行复现;成绩均为作者所报,限定于相应模型、预算、反馈和任务环境。