Tree of Thoughts: Deliberate Problem Solving with Large Language Models 论文阅读
摘要
解释思维树的状态分解、候选生成、评价和搜索,并结合 24 点、约束写作及填字实验讨论收益、预算、评价误差与应用条件。
多步推理的第一步选错,后面的文字仍可以写得很顺。Tree of Thoughts: Deliberate Problem Solving with Large Language Models 将推理过程拆成可比较的中间状态,让模型生成多个候选、评价候选,再由搜索算法决定继续探索哪条路径。思维树(Tree of Thoughts,ToT)的关键改变是把选择权放到每个中间阶段,并允许舍弃路径或回退。
这项工作在 24 点、约束写作和小型填字游戏中验证了这种推理时搜索。它没有训练一个新模型,而是用提示组织生成与评价,再配合广度优先或深度优先搜索。效果需要与额外计算、任务定制和评价误差一起看:搜索能减少早期错误的影响,价值判断不准也可能剪掉正确路径。
速读信息 | 内容 |
|---|---|
论文 | Tree of Thoughts: Deliberate Problem Solving with Large Language Models |
作者 | Shunyu Yao、Dian Yu、Jeffrey Zhao 等 |
会议 | NeurIPS 2023,所读 PDF 首页注明 |
阅读版本 | arXiv:2305.10601v2,PDF 版本日期 2023-12-03 |
原文与代码 | |
底座与任务 | 主要使用当时 GPT-4;24 点、约束写作、5×5 填字 |
阅读前提 | 思维链、搜索树、候选评价与剪枝 |
单一路径、整条采样与中间搜索
思维链从已有步骤继续生成一条路径。自一致性采样生成多条完整路径,再按最终答案投票。ToT 则在中间步骤保留不同候选,可以评价部分解是否还有希望。
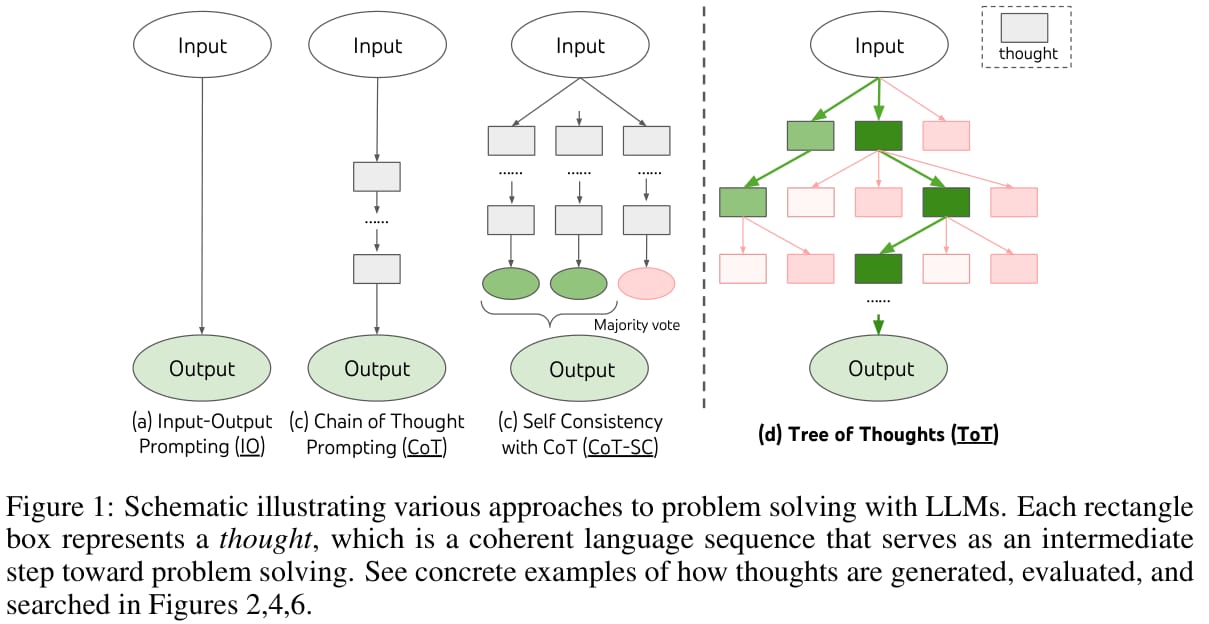
来源:原论文图 1,PDF 第 2 页。树节点是具有意义的中间文本单位,绿色路径表示继续探索的选择,其他候选可以被淘汰。
关键在于中间单位的粒度。一个 token 往往太小,难以判断它对任务的价值;整份答案又太大,错误发生后已经耗费很多计算。论文按任务选择不同 thought:24 点是一条运算,写作是一份计划,填字是一个待填单词。这种分解需要设计,不能靠把提示里写上 ToT 就自动形成有效搜索。
方法由四个可独立调整的部分组成
原文将状态表示为输入与已有 thoughts 的组合。实现需要明确分解、候选生成、状态评价和搜索算法。
部分 | 具体作用 | 需要决定的条件 |
|---|---|---|
状态与 thought | 表示已经完成的部分解 | 如何判定两条路径等价,如何保留约束 |
候选生成 | 从当前状态提出下一步 | 候选数量、采样方式、重复处理 |
状态评价 | 判断后续达到目标的可能性 | 独立评分还是候选间投票 |
搜索 | 保留、扩展或回退 | 宽度、深度、剪枝和停止条件 |
对于开放的写作空间,论文分别采样候选以获得多样性。对于较受限的运算或单词空间,可让模型在同一上下文中连续提出多个候选,减少重复。
评价也有两类。价值提示分别判断状态,例如给出能达到目标、可能、无法达到等类别;投票提示比较多个候选,选出更有希望的一个。模型评价是启发式信息,目标验证仍应由任务标准决定。24 点最终需要满足数值和使用数字的约束,不能只由模型说答案很好。
广度优先搜索(Breadth-First Search,BFS)逐层扩展并保留最好的有限候选。深度优先搜索(Depth-First Search,DFS)先走一条有希望的路径,发现不可行时返回上层。论文采用这两种搜索,没有在主方法中实现蒙特卡洛树搜索。
24 点案例:评价剩余数字的可解性
输入 4、9、10、13,目标是每个数字恰好使用一次,通过四则运算得到 24。一个可行过程是 13 - 9 = 4,剩余 4、4、10;再计算 10 - 4 = 6,最后 4 × 6 = 24。
中间运算会改变剩余数字集合。ToT 生成多种运算后,评价各集合是否仍可能达到 24。如果某次运算令后续明显不可解,就可以在完整表达式生成之前停止探索。
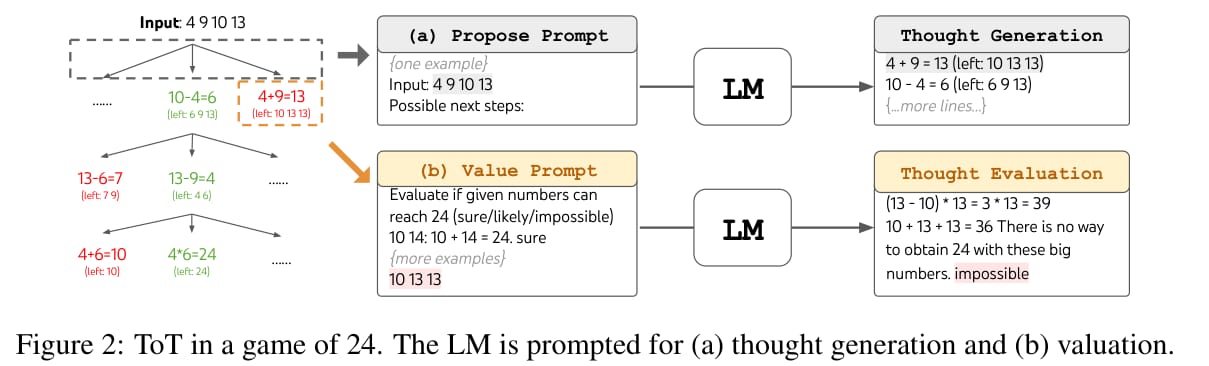
来源:原论文图 2,PDF 第 5 页。生成提示提出运算,评价提示根据剩余数字给出启发式判断;右侧展示两类提示的作用。
该任务的树深度为 3 次运算。主要设置每层保留 b=5 个状态,每个候选评价采样 3 次。这里 b 是保留宽度,并非只调用模型 5 次;生成、评价和不同深度均消耗预算。
测试集取自 4nums.com 的 100 道相对困难题,索引为 901—1000,按人类解题时间排序。成功要求表达式值为 24,且全部输入数字恰好各用一次。它衡量的是这一任务子集的搜索表现。
主结果与成本如何一起解释
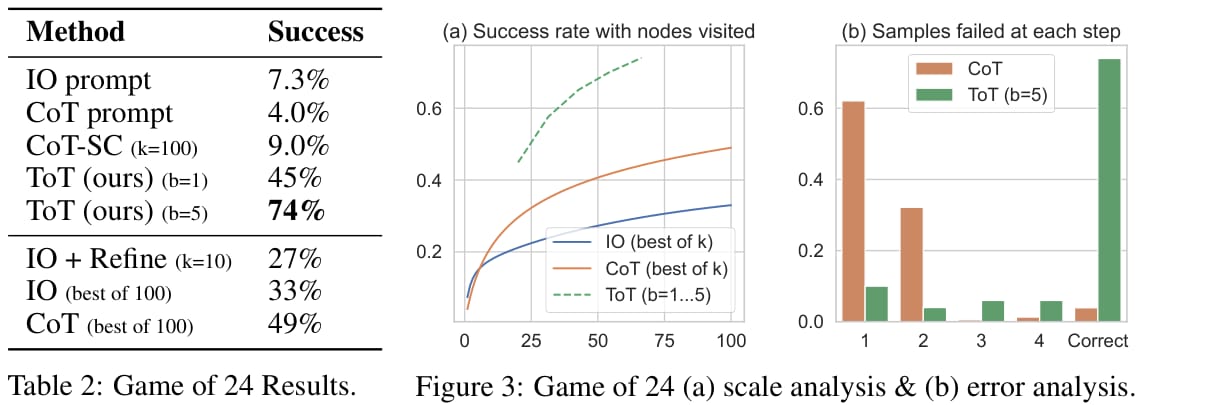
来源:原论文 PDF 第 6 页。左侧给出成功率,右侧比较搜索预算与失败发生的阶段。
方法 | 24 点成功率 |
|---|---|
直接回答 IO | 7.3% |
CoT | 4.0% |
CoT 自一致性,100 条路径 | 9.0% |
ToT,保留宽度 1 | 45% |
ToT,保留宽度 5 | 74% |
CoT,100 次采样中存在正确解 | 49% |
表中最后一行是 best-of-100 的 oracle 分析,需要知道哪个结果正确,不能与最终答案投票混写。74% 和 4% 的差距体现中间路径选择的价值,也伴随不同的调用结构和计算预算,不能描述成同样成本下的一次提示改写。
图 3 的错误分析发现,约 60% 的 CoT 样本在第一步就失去可解性。ToT 可以保留替代分支,因此减少早期错误决定最终失败的情况。若宽度为 1 也有较高收益,说明仅靠生成与评价后再做选择就已改变决策方式;继续增加宽度则扩大探索空间。
写作与填字:同一框架需要不同实例化
约束写作要求生成四个段落,每段以指定句子结束。ToT 先生成 5 个计划并投票选择,再生成 5 份文章并投票。这是一棵较浅的树,中间 thought 为写作计划。
论文在 100 个输入上使用 GPT-4 的连贯性评分,并安排作者参与盲测比较。100 对 CoT 与 ToT 文章中,人类更偏好 ToT 的有 41 对,更偏好 CoT 的有 21 对,38 对认为相近。评价者、样本与判断标准有限,不能概括成所有写作任务的普遍质量排名。原文也发现迭代改写在这一开放任务上较有效。
5×5 填字存在交叉约束,某个单词错误会影响其他单词。论文采用 DFS,根据现有字母与线索评价下一步,必要时剪枝或回退。测试只有 20 个填字游戏,分别统计字母、单词和整局成功率。原文表 3 中,ToT 的字母正确率为 78%、单词正确率为 60%、整局成功率为 20%,三个指标不能混写。
移除剪枝或回退后,结果下降,支持搜索操作在该任务中的作用。整体成功率仍有限,也说明语言启发式无法保证搜索到正确解。专门的检索式填字系统可能更合适,论文的目标是研究通用语言模型怎样组织搜索。
局限与可复用判断
ToT 需要为任务设计状态、生成器和评价器。若任务结果难以验证,评价模型与生成模型的错误可能相关;若状态表示丢失约束,更多分支只会搜索一个不完整的问题。模型将一个状态判断为不可能,也可能过早排除正确路径。
推理时搜索还增加延迟、token 费用和运行状态管理。24 点的状态可以复制,写作草稿可以重写;真实网站的提交、付款或物理动作未必可以撤销。把 ToT 接到有副作用的工具上,需要先明确哪些步骤只能模拟,哪些步骤已经改变真实状态。
对 Agent 学习,最有价值的练习是先选一个可恢复且可验证的小任务,比较单条路径、完整路径多次采样与中间搜索。固定模型和总 token 预算,记录正确率、搜索节点数、评价误判以及总延迟。这样才能判断收益来自更好的路径组织,还是单纯增加了尝试次数。
后续 LATS 将环境反馈、反思和搜索节点统计进一步结合。理解 ToT 的四部分设计后,可以更准确地比较这些新增机制,而不把所有树形提示都视作同一个算法。
来源
原论文 arXiv:2305.10601v2,依据第 3—4 节、图 1—3、表 2—3。
作者代码与提示。本文为原文阅读与机制分析,未运行复现实验。