Understanding the Planning of LLM Agents: A Survey 论文阅读
摘要
用任务分解、多计划选择、外部规划器、反思和记忆五条路线理解 Agent 规划,并结合综述中的有限实验分析性能、费用、评测口径与设计条件。
Agent 规划失败可能发生在不同位置:任务拆错、候选路径没有比较、动作不满足前置条件、失败反馈没有被利用,或者历史经验没有进入当前决策。Understanding the Planning of LLM Agents: A Survey 用五条路线组织这些问题:任务分解、多计划选择、外部规划器、反思改进和记忆增强。
这篇综述的分类按改进机制划分,几条路线可以同时出现在一个系统里。它还使用四个交互基准比较了部分提示方法,因此除了理解方法关系,还能看到收益与费用的联系。阅读主线可以从一个具体失败开始,再判断哪种机制能够提供缺失的信息或约束。
速读信息 | 内容 |
|---|---|
论文 | Understanding the Planning of LLM Agents: A Survey |
作者 | Xu Huang、Weiwen Liu、Xiaolong Chen 等 |
阅读版本 | arXiv:2402.02716v1,2024-02-05 |
来源 | 原论文,本文按预印本版本标注 |
内容 | 五类规划机制、代表方法、评测环境与有限比较实验 |
适合读者 | 已理解 CoT 或 ReAct,希望比较不同规划系统的设计取舍 |
规划的对象是环境中的可执行序列
原文将规划表述为在环境、动作空间与目标条件下生成动作序列。目标是否能够达成,既取决于语言推导,也取决于动作前置条件和执行后的环境状态。把计划写得详细,只改善了表示,仍需要验证动作是否可行。
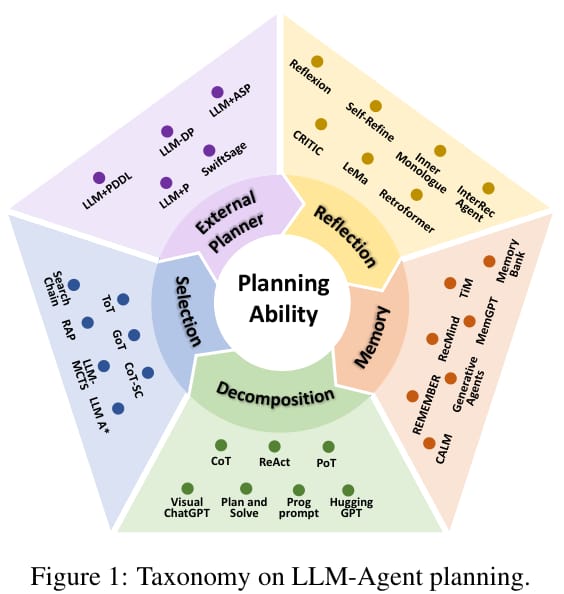
来源:原论文图 1,PDF 第 1 页。图中的不同类别具有可组合性,不能视为互相排斥的完整框架。
路线 | 主要解决的问题 | 新增的信息或能力 |
|---|---|---|
任务分解 | 一次处理复杂目标困难 | 子目标、依赖关系与局部计划 |
多计划选择 | 单一路径容易过早承诺 | 替代候选及评价、搜索 |
外部规划器 | 复杂约束难以稳定满足 | 符号求解或训练过的策略 |
反思改进 | 失败后重复同一错误 | 反馈与修订方向 |
记忆增强 | 每次都从头开始 | 与当前条件相关的历史经验 |
任务分解:先拆完整目标,还是执行中逐步拆
先分解再执行的方法先生成全部子目标及依赖,然后对各子目标形成计划。它便于显式组织整体结构,但初始分解错误会传到后续执行。交错分解则在当前状态下提出接下来的子目标,随着观察继续调整,代价是需要更频繁的模型交互与状态维护。
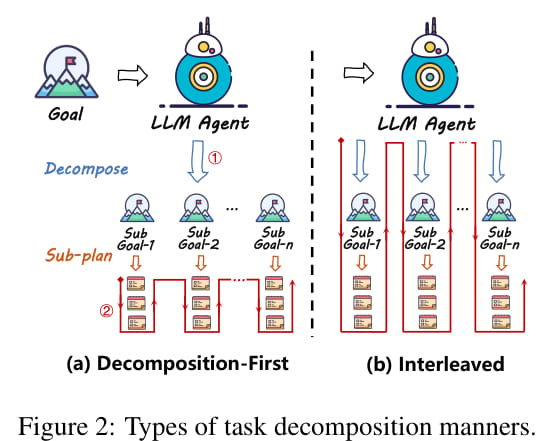
来源:原论文图 2,PDF 第 2 页。左侧先建立子目标,右侧在推进过程中继续分解与规划。
例如整理文献,确定主题后先列出下载、核验、图表和写作依赖,适合较稳定的任务;检索时发现论文版本冲突,则需要交错式调整。这个例子用于解释分类,并非论文实测案例。
综述将 HuggingGPT、Plan-and-Solve 等放入预先分解路线,将 CoT、ReAct 等作为交错机制的代表。对于具体方法,仍应回到原文确认状态和动作定义。把语言中的推导步骤与环境动作区分清楚,才能判断分解质量还是执行能力限制了结果。
多计划选择:候选空间和评价信号同样重要
多计划路线先生成多个候选,再按评价或搜索选择。CoT 自一致性通常比较完整答案,ToT 在中间状态进行评价,图结构方法还允许子结果之间发生更复杂的关系。
更多候选能提高覆盖,也会增加 token 和评价成本。若评价器偏好语言流畅但不可执行的方案,候选再多也未必提高成功率。需要同时检查候选多样性、评价误判和最终验证条件,不能只记录分支数量。
原文强调这些机制可以与任务分解结合:先分出子目标,再在某个难点上生成替代路径。这样能将额外计算集中到关键位置,而不是对每一个简单步骤都进行完整搜索。
外部规划器:语言模型负责形式化,求解器负责约束
符号规划路线要求把任务、环境和动作条件转成明确表示。PDDL(Planning Domain Definition Language,规划领域定义语言)可以表达动作前置条件与状态变化,外部求解器据此寻找计划。
这种组合的前提是形式化正确且充分。求解器满足的是输入模型里的约束,若模型遗漏了环境条件,符号上的合法计划仍可能执行失败。LLM 在这里承担任务翻译、环境信息处理等职责,不能把外部求解器的保证直接归给语言模型。
另一类使用神经规划器或训练过的策略,例如让较小策略处理常见动作,复杂情况交给语言模型。它可以改变效率,但能力依赖训练任务分布与切换规则。综述提供代表工作关系,没有为所有外部规划器提供统一实测排名。
反思与记忆:当轮纠错和跨轮经验
反思根据失败、工具结果或评价修订计划。Self-Refine 关注自生成反馈,Reflexion 保存语言反思,工具验证路线则把外部信息作为纠错依据。反馈可靠性决定修订方向,自评不能自然替代环境检查。
记忆增强让先前经验参与新任务。检索增强生成(Retrieval-Augmented Generation,RAG)式记忆保留在模型之外,按相关性召回;原文另用 embodied memory 描述通过训练把经验写入参数。这里的 embodied 指记忆的参数化承载方式,不能直接翻成物理机器人记忆。
外部记忆更新较灵活,但会出现检索偏差、信息过期与细节压缩;参数内记忆需要训练,更新代价较高,也不便逐条编辑。当前失败反思可以成为未来记忆,两条路线因此相互衔接。
比较实验:评测方法与历史费用需要保留条件
作者实现了六类提示方法,使用 text-davinci-003,在 ALFWorld、ScienceWorld、HotpotQA 与 FEVER 上比较。CoT 自一致性在游戏任务每步获得 3 个动作候选,在问答中获得 5 个答案;Reflexion 重试轮数设为 1。这些是本综述的实验实例,不能代替各方法原论文的完整配置。
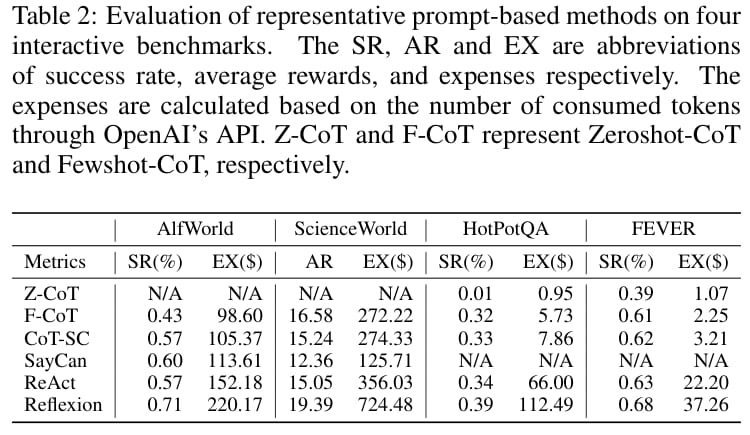
来源:原论文表 2,PDF 第 6 页。原表将成功率、平均奖励和 token 费用分别展示;不同列采用不同量纲。
ScienceWorld 的平均奖励中,Few-shot CoT 为 16.58、ReAct 为 15.05、Reflexion 为 19.39;对应 EX 历史费用列为 272.22、356.03、724.48 美元。费用是论文实验记录的 API token 费用,不能当作当前报价或单个用户任务的费用,也不能由表中数字推导每种部署的成本。
这组结果支持反思在所测设置中改善部分任务,同时付出更多计算。它也表明方法收益不单调:ReAct 的平均奖励在该任务低于 Few-shot CoT。不能把更复杂的机制直接等同于更高成绩。
原表的部分成功率列以小数展示,但表头写作 SR(%)。为避免混淆比例和百分数,本文保留原图,不据此扩写未经澄清的百分比结果。比较不同论文时应重新确认各自分母、成功定义和数值口径。
研究空白与学习方法
作者提出的主要挑战包括幻觉、计划可行性、效率、多模态反馈和细粒度评测。只看最终成功与失败,无法区分系统在哪个阶段出错,也难以评价有效但与参考路径不同的方案。
可以用一个简单诊断流程复用这篇综述:先确认目标和允许动作,再逐步检查子目标、前置条件、候选评价、失败修订及记忆来源。每次只增加一个与实际失败有关的机制,在相同模型和预算下比较成功率、交互长度与费用。
所读版本发布于 2024 年 2 月,分类适合组织当时及后续工作,但它不提供当前工具选型结论。复用分类后,还需要核验具体方法的代码、环境和运行证据,尤其是反思是否可验证、外部记忆是否适用,以及外部规划模型是否完整。
来源
原论文 arXiv:2402.02716v1,依据第 2—9 节、图 1—2、表 1—2。
文中实验是综述作者报告;本文没有运行这些方法,也未将历史 API 费用更新为当前价格。