
The Rise and Potential of Large Language Model Based Agents: A Survey 论文阅读
摘要
以感知、大脑和行动的闭环梳理 LLM Agent,解释知识、记忆、规划、多 Agent、人机交互与模拟社会的关系,并讨论评价、证据边界和工程选择。
LLM-based Agent 的研究很容易被框架名称打散:有的工作强调规划,有的增加记忆,有的让多个角色协作,还有的把模型接进游戏或机器人。The Rise and Potential of Large Language Model Based Agents: A Survey 提供了一张把这些工作放回同一系统的地图:感知负责获取环境信息,大脑负责知识、记忆与决策,行动负责改变环境,结果再进入下一轮决策。
这篇综述的贡献在于分类和问题组织。它同时讨论单 Agent、多 Agent、人机交互与模拟社会,并把评价、可信性和规模扩展纳入分析。阅读时可以沿着一个具体问题展开:模型给出一个正确建议之后,系统还缺少什么,才能持续完成真实任务?下文先解释闭环与内部模块,再讨论交互组织方式,最后回到评测和工程选择。原文没有提出一个统一新模型,也没有进行统一条件下的横向基准实验。
速读信息 | 内容 |
|---|---|
论文 | The Rise and Potential of Large Language Model Based Agents: A Survey |
作者 | Zhiheng Xi、Wenxiang Chen、Xin Guo 等,复旦大学 NLP 团队 |
阅读版本 | arXiv:2309.07864v3,首次提交 2023-09-14,版本日期 2023-09-19 |
类型 | Agent 综述;本文按所读预印本标注来源 |
原文与资料库 | |
核心框架 | Brain、Perception、Action,以及单体、群体与人机交互 |
适合读者 | 了解大语言模型基本工作方式,希望建立 Agent 研究分类和系统设计视角的读者 |
从模型输出到环境闭环
大语言模型(Large Language Model,LLM)的基本接口是接收上下文、生成后续文本。Agent 还要处理时间推进后的变化:工具是否执行成功,页面是否更新,计划是否仍满足条件,上一轮哪些信息值得保留。这使系统设计同时涉及模型能力、状态管理、工具接口和反馈机制。
原文图 2 给出总体结构。图中的大脑还包含知识、记忆、检索和总结等操作,说明控制器周围存在持续维护的状态。
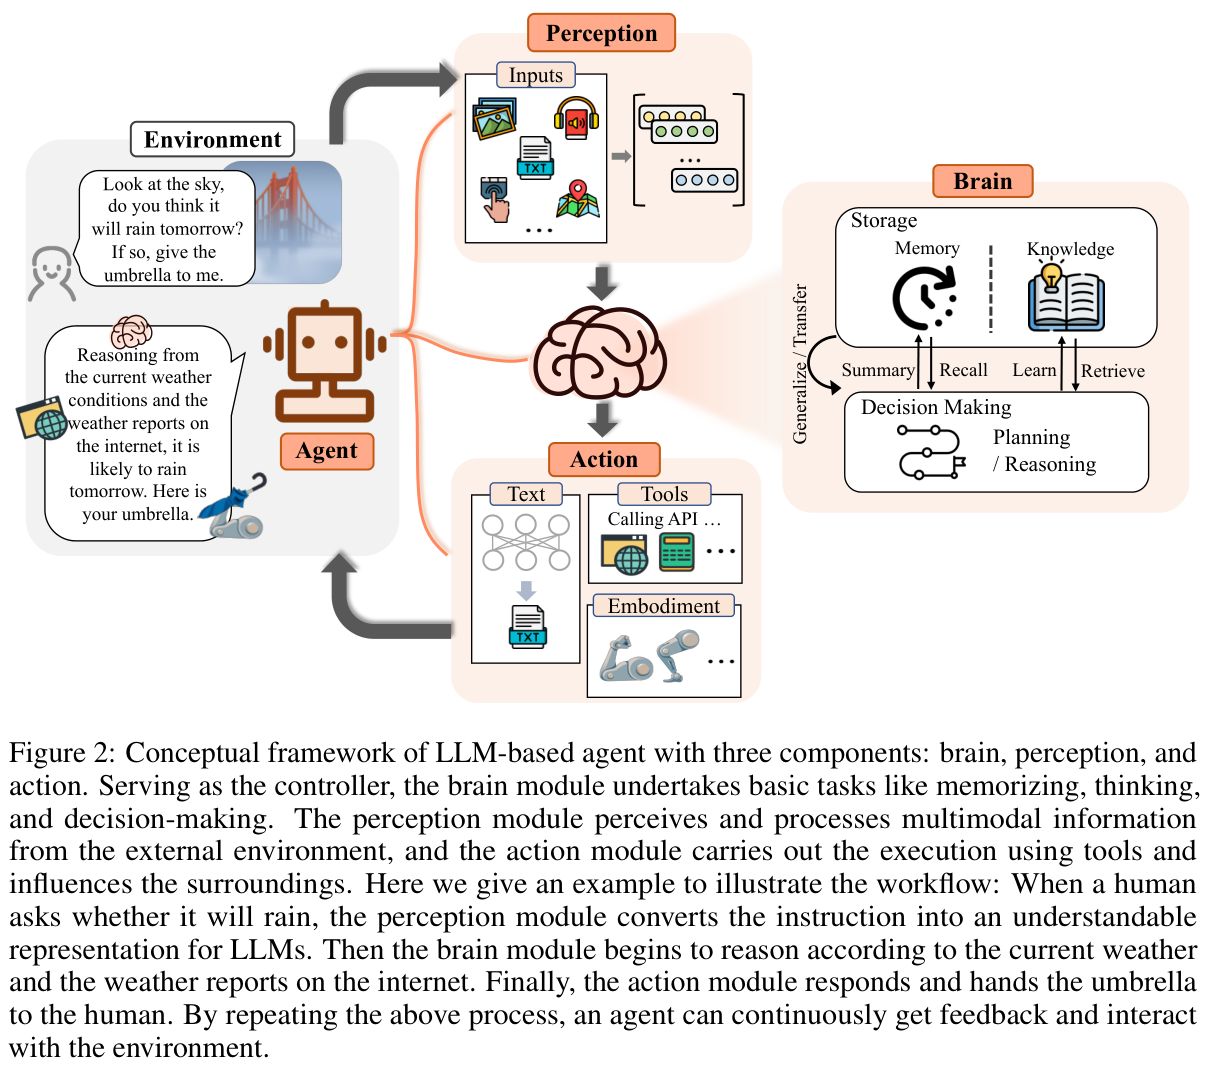
来源:原论文图 2,PDF 第 10 页。感知获得输入,大脑组织状态与决策,行动影响环境;环境反馈使过程继续。
以论文中的天气场景为例,用户提出是否需要雨伞,感知模块读入用户指令与外界信息,大脑结合天气信息形成判断,行动模块给出回复或执行取伞动作。这里的取伞是概念示例,图本身没有证明某个机器人已可靠完成物理操作。换成软件任务,行动可以是查询天气接口,反馈则是返回值或错误。
设计自己的 Agent 时,可把每轮交互记为观察、内部状态、动作、环境结果。这个划分有助于定位错误:输入缺失、规划错误、参数错误与执行失败发生在不同位置,不能都归因于底座模型不够强。这是依据综述框架得到的工程分析,并非论文给出的性能实验。
大脑:知识、记忆与规划分别承担什么
知识说明世界,记忆保留经历
原文把知识分为语言知识、常识与专业领域知识。模型可以利用参数中的知识解释指令,但这些知识可能过时或不准确。接入检索与专业工具能够补充信息,仍需要检查信息是否与当前任务有关。
记忆关注 Agent 自己的历史观察、思考与行动。例如 API 文档属于任务知识,刚才请求被限流及其原因属于执行经历。把两者混成一段长上下文,后续决策很难判断哪些是可靠事实、哪些是已过期状态。
综述整理了扩展上下文长度、总结历史、采用向量或结构化表示等记忆方案,以及自动检索和用户可操作的记忆机制。它们的共同难点是保存与使用之间的取舍:压缩会丢失细节,全量保留增加处理成本,检索可能拿到语义相似但条件不符的内容。
设计位置 | 需要回答的问题 | 典型代价 |
|---|---|---|
保存 | 哪些观察、动作和结果值得留下? | 冗余记录与隐私负担 |
表示 | 原始轨迹、文本总结还是结构化条目? | 细节损失、格式维护 |
检索 | 当前任务需要哪段经历? | 漏召回、错误召回与上下文占用 |
更新 | 旧结论何时失效,谁能够修改? | 冲突处理与来源追踪 |
上表是依据第 3.1.3 节整理的设计问题。论文没有在统一数据上比较所有记忆方法,不能从分类表推出哪种记忆实现普遍最好。
推理形成判断,规划安排后续动作
综述将推理与规划放在同一模块中讨论。思维链提示通过中间步骤帮助模型完成推导;规划还要决定动作顺序、任务分解和路径选择。两者有关联,但一个能解数学题的模型未必能在动态环境里持续执行计划。
原文区分计划形成与计划反思。形成阶段可以分解任务、搜索候选路径,或借助外部规划器;反思阶段利用执行反馈修改后续安排。实际环境发生变化时,预先生成的长计划可能失效,因此系统需要明确何时重新观察、何时修订。
例如完成资料整理任务,计划可以是检索来源、确认版本、提取图表、撰写文章。若检索只得到摘要,后续写作的前提已经改变。系统应该缩小可写范围或继续寻找全文。把错误来源继续喂给模型,无法靠增加计划步骤补回缺失证据。
泛化与持续学习需要区分
指令遵循和上下文学习使模型能够处理没有专门训练过的任务。综述也讨论持续学习与能力迁移。对具体系统,需要进一步区分模型参数是否更新,还是仅在上下文、记忆或工具库中累积经验。
后续阅读 Reflexion、MemoryBank 和 Voyager 时,这个区分尤为有用:自然语言反馈、长期记忆以及可执行技能库存放在系统的不同位置。任务表现随经验改善,并不自动等于底座模型经过了新的参数训练。
感知与行动:接口改变了能力边界
感知模块把环境信息转成模型能够使用的表示。文本可以直接进入上下文,图像与音频则涉及额外的转换或对齐。综述介绍了将图像转成描述、使用视觉编码器及可学习接口等路线。
信息转换会改变决策条件。把一张复杂界面转成简短描述后,模型可能失去按钮位置、细小提示或布局关系;输入更多视觉信息又会引入表示和处理成本。需要测量的是转换后能否支撑目标动作,单纯说明接入了多模态还不充分。
行动空间包括文本输出、工具使用与具身动作。文本回答主要在语言层面产生影响,工具调用会改变软件状态,物理动作还受到空间、动力学和传感误差约束。模拟环境中的行为结果不能直接证明物理世界中的可靠性。
工具设计也会改变规划难度。搜索、计算和执行接口能增加模型的可用能力,但需要提供清晰的输入输出与执行结果。工具返回了文本不代表动作成功,错误信息应作为反馈进入下一轮。综述还讨论 Agent 创建工具和工具泛化,这需要额外检查生成实现是否正确,以及它能否迁移到新的接口条件。
多 Agent 与人机协作如何组织
原文将实际应用分为单 Agent、多 Agent 和人机交互。单 Agent 还可按任务、创新或生命周期需求组织应用,例如完成具体操作、辅助科研探索或持续维护长期任务。
多个角色协作时,差异化信息与能力可以帮助分工;对抗或辩论则试图通过相互检查改进结果。关键变量包括各角色掌握什么信息、如何沟通、谁决定接受结论,以及何时结束交互。增加角色数量会增加通信与处理成本,同一底座模型也可能重复同一错误。
原文图 10 展示两种人机交互组织方式。
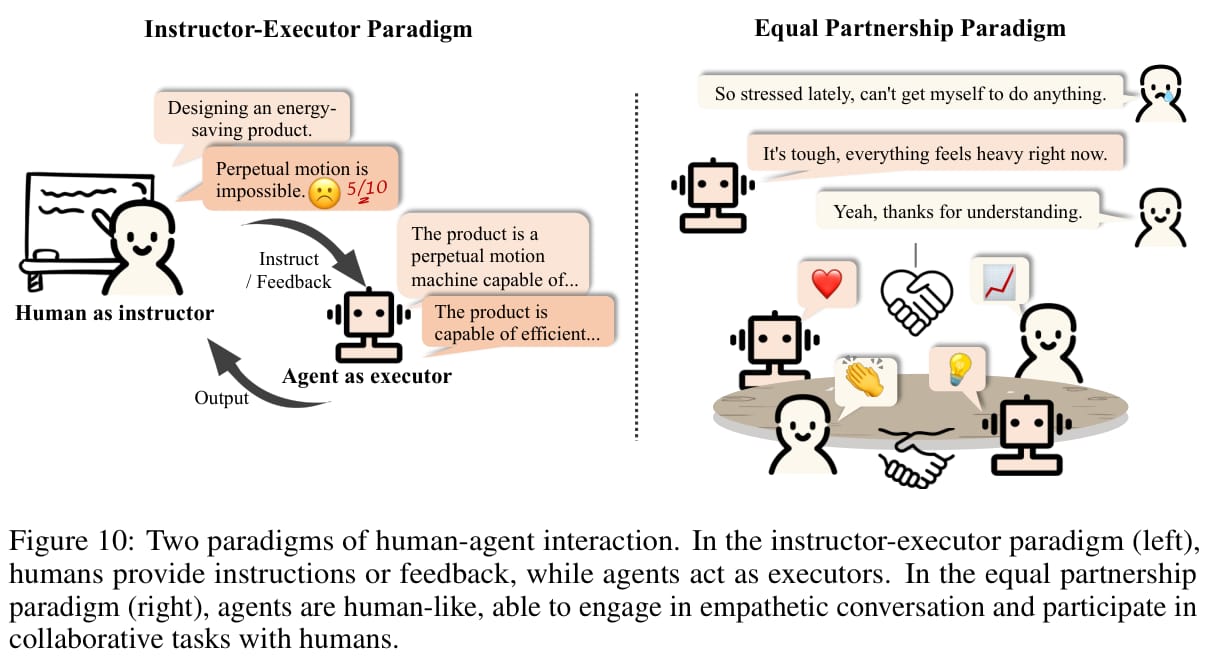
来源:原论文图 10,PDF 第 31 页。左侧强调人给出要求和反馈,右侧关注更开放的共同参与。图中的伙伴关系描述交互方式,不表示系统拥有人的心理状态或相同的责任。
对任务系统,人工反馈可以纠正目标或评价结果。更开放的协作则要求系统理解上下文与隐含意图。两种场景的验收方式不同:前者可以检查产物和目标条件,后者还要考虑对话一致性、角色表现与用户体验。
模拟社会:研究对象从个体转向交互
综述的另一条主线是 Agent Society:将多个具有角色、经历和环境关系的 Agent 放在一起,观察个体行为和群体过程。环境既包括物理或虚拟空间,也包含其他参与者以及共享资源。
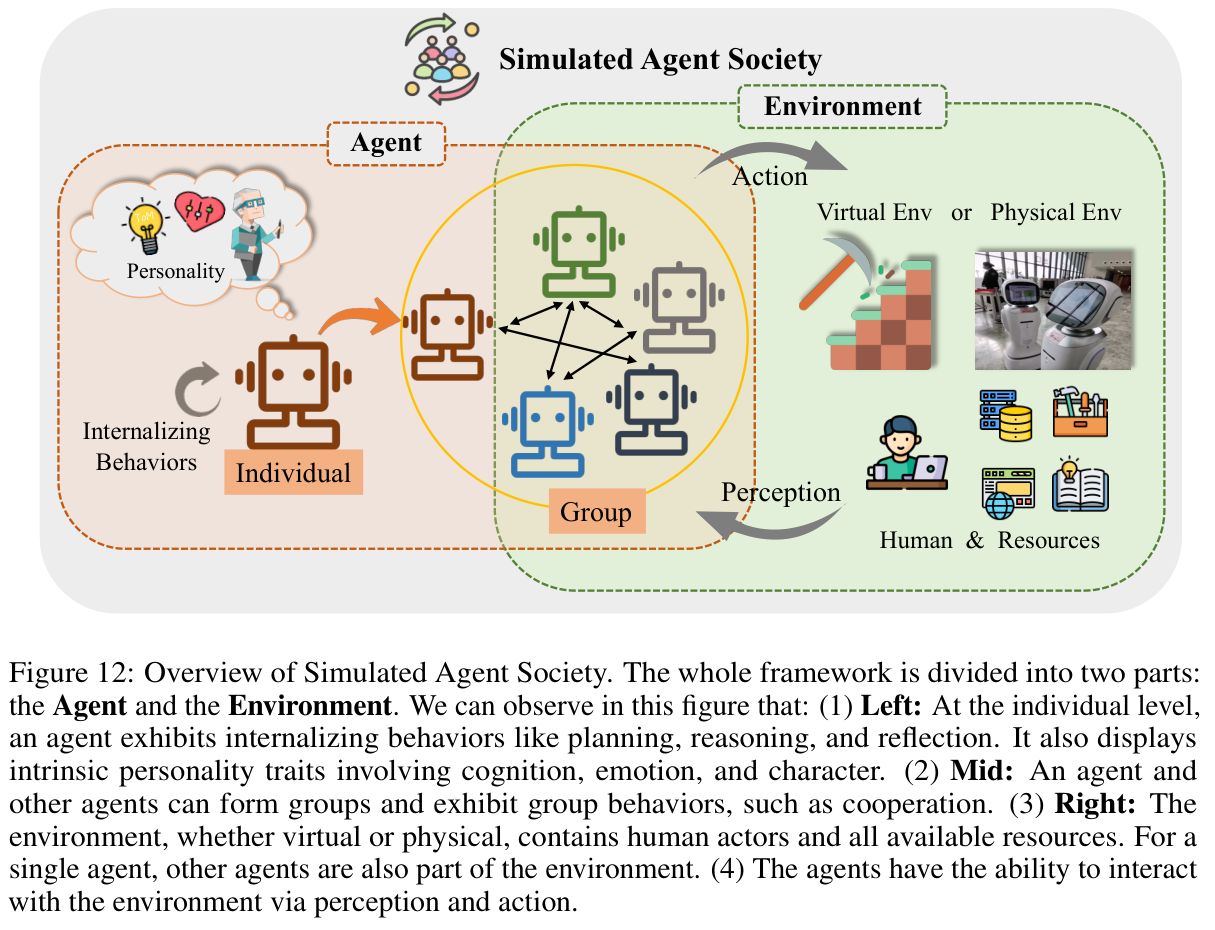
来源:原论文图 12,PDF 第 35 页。群体形成于多个个体的交互,其他 Agent 也是单个 Agent 所处环境的一部分。
论文讨论了社会行为、人格表现、传播、博弈与政策探索等研究方向。这些系统可用于构造可控实验,但模拟中的现象需要谨慎解释。模型的训练语料、角色提示、环境规则与评价者都可能塑造结果,观察到类似人类的行为还不足以证明对真实社会具有预测效力。
这类工作还面临评价上的层次差异。个体是否记住信息,群体是否协作成功,模拟是否符合现实数据,是三个不同问题。只检验对话是否自然,无法同时回答另外两个问题。
评价框架与证据边界
第 6 节讨论效用、社会性及适应性等评价方向。实际评测至少需要把结果能力与运行过程分开:系统完成多少任务,在哪一步失败,耗费多少交互,以及换环境后是否保持表现。
观察层次 | 可测问题 | 常见解释边界 |
|---|---|---|
任务结果 | 成功率、产物质量、约束满足程度 | 单一任务不能代表通用能力 |
运行过程 | 规划修订、工具错误、记忆检索 | 语言解释未必忠实反映内部计算 |
协作 | 分工、信息传递、冲突解决 | 多角色表现受通信预算影响 |
适应 | 新任务、变化环境、持续交互 | 需要与原设置明确区分 |
综述引用大量单独研究,证据来自各自的任务和实验条件。本文没有将其分数拼成统一排行榜,也没有把原文的前景讨论当作通用人工智能已经实现的证据。
可信性问题也与行动空间有关:错误信息可以污染记忆和后续判断,过度自信的输出可能驱动实际动作。论文讨论对抗鲁棒性、幻觉、隐私、误用和群体偏差。工程系统需要检查错误能否被观察、限制和纠正,不能仅凭模型语言表现流畅来判断可靠性。
怎样把这篇综述用于后续学习
最适合复用的是它的分类坐标。阅读新论文时,先定位改动在感知、大脑、行动还是交互组织,再问改动由什么证据支持。这样可以避免把多个框架的相似接口误认为不同原理。
例如学习长期记忆,可以分别比较保存内容、检索方式和更新规则;学习规划,则比较状态表示、候选生成、路径评价和反馈后的调整;学习多 Agent,要同时记录角色差异、通信方式与总预算。比较时固定底座模型、工具和任务条件,否则很难判断效果来自机制还是资源增加。
原文所读版本停留在 2023 年 9 月,后续研究与产品变化不在该版本的覆盖范围内。文中的通用框架适合建立第一张研究地图;新的实现选择仍需要对应论文、代码和实际测量支持。可以从一个短闭环开始:让系统完成一项任务,保存每轮观察与动作,标注失败位置,再决定值得增加的是记忆、规划还是更准确的输入。
来源
原论文 arXiv:2309.07864v3,主要依据第 3—6 节,图 2、10、12。
作者维护的 LLM Agent 文献列表,用于定位后续原始文献;列表本身不作为具体实验结论的替代证据。