
Reflexion: Language Agents with Verbal Reinforcement Learning 论文阅读
摘要
解释执行、评价、语言反思与跨尝试记忆的协作,通过 ALFWorld、问答和编程结果讨论重试预算、自生成测试错误及上下文更新的边界。
任务失败之后,再生成一次答案可能重复原先的错误。Reflexion: Language Agents with Verbal Reinforcement Learning 在重试前增加一个步骤:根据执行轨迹和评价信号,生成具体的语言反思,将它保存为经验,供下一次尝试参考。
论文把这种反馈称为 verbal reinforcement。更新发生在上下文和记忆中,底座模型权重保持固定。其贡献是组织执行、评价、反思和跨尝试记忆,并测试不同反馈来源的效果。原文也呈现了反例:错误测试可能让系统过早接受错误程序,或修坏本来正确的实现。
速读信息 | 内容 |
|---|---|
论文 | Reflexion: Language Agents with Verbal Reinforcement Learning |
作者 | Noah Shinn、Federico Cassano、Edward Berman、Ashwin Gopinath、Karthik Narasimhan、Shunyu Yao |
阅读版本 | arXiv:2303.11366v4,PDF 版本日期 2023-10-10 |
原文与代码 | |
任务 | ALFWorld、HotpotQA、Python/Rust 编程 |
核心机制 | 失败轨迹转成语言经验,影响后续尝试 |
执行、评价与反思分别处理什么
Actor 依据目标、当前观察和记忆生成行动或答案。Evaluator 判断当前轨迹的结果。Self-Reflection 将评价和轨迹转成下一次能够使用的经验。三者是功能角色,不必由三个不同模型承担。
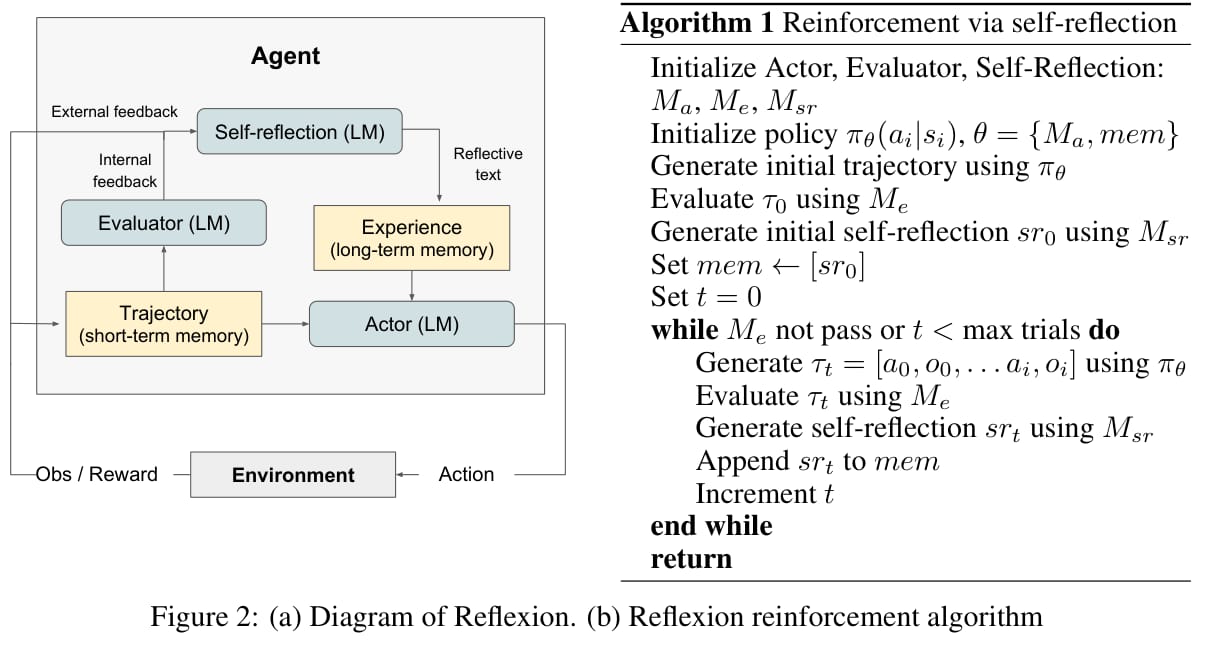
来源:原论文图 2,PDF 第 4 页。当前轨迹作为短期记忆,反思文本作为跨尝试经验。停止行为应依成功判定与尝试预算检查实际实现,不能不经核对复制示意伪代码。
例如 ALFWorld 中,Agent 尝试从一个位置取锅,环境返回没有发生操作。反思可以指出先前错误地假定物品在该处,下一次需要确认位置,而不能继续按已经持有物品来执行。有效经验需要保留具体错误和可改变的行为,泛泛写以后更仔细没有提供足够的决策信息。
反馈可以是环境成功标记、失败检测规则、模型评价或自生成测试。可靠性不同,产生的反思也不同。二元失败信号说明结果不满足目标,尚未确定原因;原因仍需要从轨迹中推断。
记忆保存的是跨尝试经验
短期记忆记录本轮观察和动作,长期记忆保存过去几轮的反思。原文一般限制为 1—3 条经验,以控制上下文长度;不同任务设置不同。它并没有建立无限增长的知识库,也不保证反思能够迁移到任意新任务。
一次流程可写成:执行任务、评价结果、失败时分析轨迹、保存反思、重置或重新尝试。成功时停止,预算用完则返回当前结果。环境能否重置、哪些动作已经产生副作用,会影响此流程能否用于实际系统。
所谓语义梯度是作者对反馈方向的比喻,不是网络参数上的数学梯度。与 Toolformer 的微调相比,Reflexion 改变了后续输入;与 ToT 相比,它主要利用跨尝试经验修订路径,不一定在每个中间节点保留多条搜索分支。
ALFWorld:累计成功率包含重试预算
论文在 134 个文本环境中测试寻找、移动和处理物品等任务。执行器采用 ReAct,评价可以用模型分类或规则。规则将重复相同动作并得到相同结果超过 3 轮,以及本轮动作数超过 30 等情况识别为需要反思的失败。
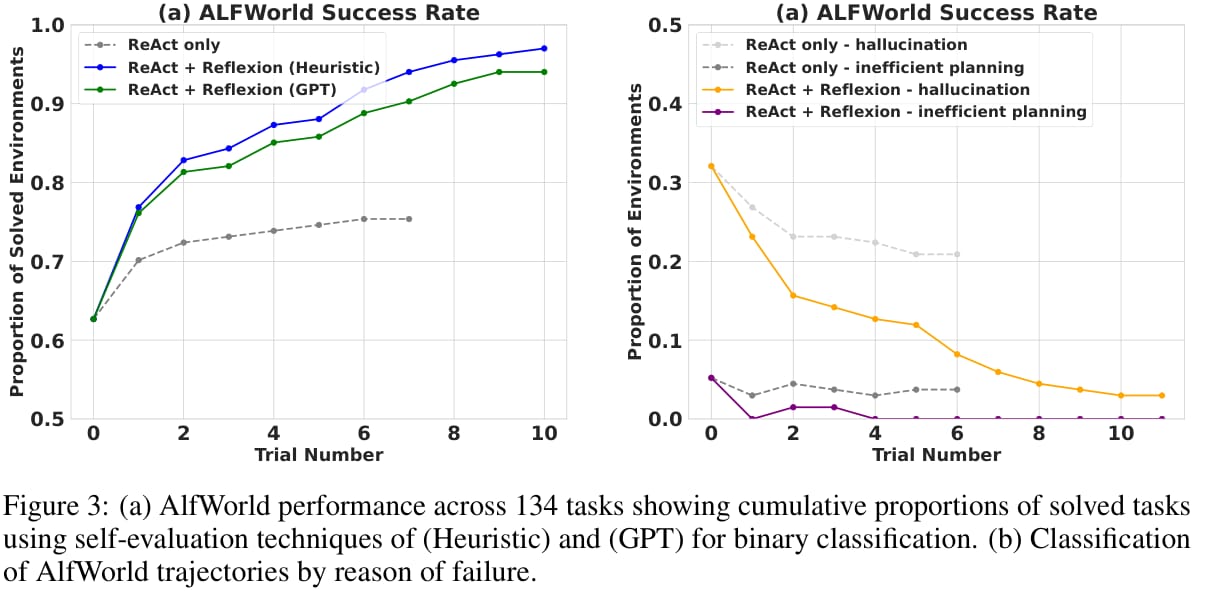
来源:原论文图 3,PDF 第 6 页。横轴是尝试次数,成功比例随着历史经验累积变化。
规则反馈版本在多轮尝试后完成 130/134 个任务。这个结果包含最多 12 轮迭代的学习过程,不能写成首次运行成功率。原文同时给出基线重复尝试的曲线,用来判断仅重试与带反思重试的区别。
常见失败是 Agent 认为已经取得某个物品,实际环境并未确认。反思有机会把这段长失败轨迹压缩成下一次可用的提示。另一个场景是搜索多个容器,经验可以避免完全重复已经失败的查找步骤。
HotpotQA:答案判定与参考上下文是额外信息
论文对 100 个问题比较 CoT、ReAct 及反思变体。部分 CoT 设置直接提供真实支持上下文,称作 CoT(GT),主要检验已有信息上的推理;ReAct 使用维基百科 API 取得信息。
尝试之间,环境以答案精确匹配给出二元成功信号。Agent 不直接得到标准答案字符串,但获得了是否正确的反馈。真实开放问答通常没有这一信号,因此不能把该设置理解为完全没有外部监督。
对给定真实上下文的消融,单纯加入最近轨迹与加入反思的效果不同,支持把经历整理成行为提示在所测任务中有价值。它仍依赖模型能从失败中推断原因,无法保证每一条反思真实。
编程:自生成测试既提供反馈,也会制造误判
编程流程先生成最多 6 条测试,过滤语法不合法的断言,再用测试执行结果或编译输出评价代码。失败后生成反思并修改实现,最终提交一份程序给隐藏测试评分。
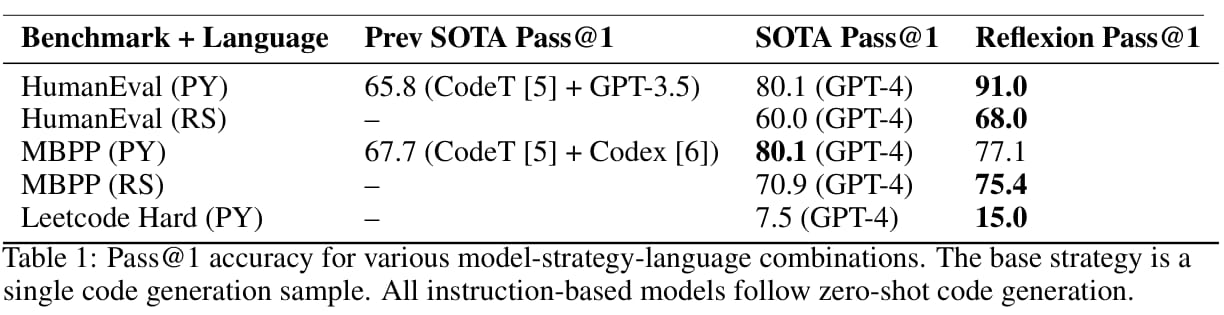
来源:原论文表 1,PDF 第 7 页。括号中的 PY 和 RS 分别表示 Python 与 Rust。
基准 | GPT-4 基线 | Reflexion |
|---|---|---|
HumanEval Python | 80.1% | 91.0% |
HumanEval Rust | 60.0% | 68.0% |
MBPP Python | 80.1% | 77.1% |
MBPP Rust | 70.9% | 75.4% |
Leetcode Hard Python | 7.5% | 15.0% |
这些 pass@1 是最终一份提交的评分口径,内部包含测试、反馈和修改;它不等于第一次未经尝试生成的准确率。Rust 的相关 HumanEval 实验使用经 MultiPL-E 转换的困难子集,不能与完整 Python 数据集直接比较难度。
MBPP Python 的下降很有解释价值。若测试把错误实现判为正确,系统会提前结束;若测试把正确实现判为错误,后续反思可能造成有害修改。原文进一步分析假阳性与假阴性,并在困难 Rust 子集做消融:基线 60%,只反思而没有测试 52%,有测试但没有反思 60%,完整方案 68%。反馈与反思共同有效,自我检查并不自动带来改善。
局限与实践条件
记忆窗口会丢弃旧经验,错误反思可能被持续复用,语言反馈也缺乏一般收敛保证。测试驱动反馈在非确定函数、外部 API、并发或硬件相关输出中更难定义。论文还需要多次模型生成与执行,未提供一种普遍低成本的纠错保证。
更合适的应用是有可验证产物、可追踪轨迹和可重试环境的任务。可以将反馈明确分成已观察事实与原因假设,只有前者直接进入稳定记忆;用后续执行验证假设,防止一次失败就形成错误经验。这是依据论文边界提出的工程建议。
复用时同时记录最终成功率、重试次数、反馈准确性、错误被重复的次数和额外费用。先比较重复采样、保留轨迹和生成反思,再判断哪部分带来改善。评价器不足时,应优先补充可靠信号,避免让模型在没有证据的情况下持续修订。
来源
原论文 arXiv:2303.11366v4,依据第 3—5 节、图 2—4、表 1—3。
作者实现与示例。本文未运行复现,所有成绩为所读版本的作者报告。